1 概率论:为什么机器学习用概率说话
给电信用户预测是否流失,输入可能包括入网月数、月费、合同类型和近期服务投诉。相似的用户仍可能作出不同决定,因为价格变化、家庭安排等因素没有全部记录下来。给图片识别服装类别,模糊、遮挡和拍摄角度也会使判断出现分歧。概率提供了描述这些不确定性的语言:在明确的信息与条件下,某个结果出现的可能性有多大。
这里的结果要先定义清楚。使用公开的 Telco Customer Churn 表格数据时,标签通常表示数据集记录的客户是否流失;它不自动等于“未来 30 天会流失”。如果要部署未来预测,就必须重新规定观察时刻、特征窗口与结果窗口。公开数据适合练习概念,实际任务的时间含义需要额外确认。把问题写错,模型算出的分数再精细,也回答不了业务真正关心的问题。
可以把待预测的结果记为 Y,把已观察到的特征记为 X。表达式 P(Y=1|X=x) 读作“在特征取值为 x 的条件下,正类结果的概率”。流失任务里 Y=1 表示流失;短文本分类里也可以表示垃圾短信。竖线右边列出我们已知的信息,它提醒我们:任何概率判断都有信息边界。加入新的可靠信息,判断可以改变;部署人群发生变化,原先的判断也可能失效。
概率不是要求每次预测都正确。若某组样本的预测概率约为 0.8,我们期待在足够多、条件可比的样本中,正类比例接近 80%,而不是要求每 5 个样本必定出现 4 个正类。单个用户最终只有流失或未流失的结果,无法靠这个结果独自检验 0.8 是否合理。概率预测需要放到重复观察、分组比较和明确的数据来源中评价。
先建立最基本的实验边界。训练集用于拟合模型,验证集用于选择特征、阈值和其他配置,测试集用于最后评估选定方案。可以从 70%/15%/15% 的划分开始,但比例本身不保证可信:同 1 个客户的重复记录不能跨集合,预测未来时应优先按时间划分。测试集若反复参与选择,就已经承担了验证集的角色,最终结果容易过于乐观。

模型先输出分数,再由阈值把分数转换成行动。比如分数至少为 0.4 才进入人工复核名单。概率判断描述不确定性,阈值表达资源和代价;这 2 件事需要分别讨论。理解本课后,读者应能追问:这个概率针对谁、依据什么信息、用什么数据估计,以及误判后会发生什么。
2 概率论中的随机变量、分布与期望
随机变量是把不确定结果映射为数值的规则。流失标签 Y 只有 0 和 1,可以用伯努利分布描述;1 天收到的垃圾短信数量可以取 0、1、2 等值,是离散计数;月费通常按连续数值建模。不要把“随机”理解为毫无规律。它表示观察之前结果尚不确定,而分布用来表达不同取值出现的可能性。
离散分布为每个可能值分配概率,各概率不能小于 0,总和等于 1。例如从某个固定客户群随机抽取 1 人,假设流失概率为 0.2,那么 P(Y=1)=0.2,P(Y=0)=0.8。这个简化描述把客户差异暂时合并了。按合同类型分组后,组内流失率可以不同;整体分布与条件分布回答的是不同的问题,不能随意互换。
连续变量则更适合讨论区间概率,例如月费落在 50 到 60 之间的概率。概率密度曲线的高度本身不是概率,区间下的面积才对应概率。入门阶段不必计算积分,但要避免把“密度为 1.2”误读成“概率为 120%”。真实账单以有限精度记录,课堂中的连续模型只是便于分析的近似,选择模型时仍要检查取值范围和异常值。
期望是按概率加权的平均值。若 Y 取 0 或 1,则 E[Y]=0×P(Y=0)+1×P(Y=1)=P(Y=1)。因此,标签平均值就是样本正类比例。若 100 名客户中有 20 名流失,样本平均值为 0.2;它估计的是对应抽样条件下的总体流失率。换成另一地区、另一月份或另一种招募方式,这个估计未必继续适用。
期望也能描述损失。假设漏掉 1 名需要帮助的客户记损失 80,误联系 1 名无需帮助的客户记损失 5,就可以按不同结果的概率计算平均损失。但平均值不展示所有风险:2 个方案可能期望损失相同,损失波动却差别很大。方差描述数值偏离期望的程度,常写为 Var(Z)=E[(Z−E[Z])²];本课只需理解,均值与波动都应关注。
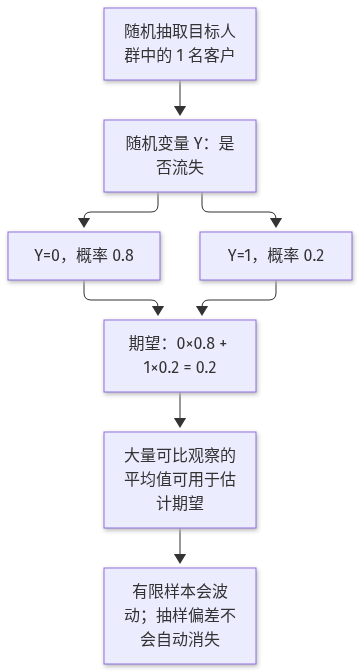
还要区分独立与相似。若知道第 1 次结果后,第 2 次结果的概率不变,才可以在相应假设下说它们独立。连续采集同 1 用户的短信、同 1 件衣服的多张图片,往往存在关联。把相关样本当成大量独立证据,会高估信息量。公开 Fashion-MNIST 中的图片可以用于分类练习,而自己补采图片时,应记录拍摄对象与来源,防止近重复图片跨越数据划分。
3 条件概率与贝叶斯更新直觉
条件概率只在满足条件的样本范围内计算。若 100 名客户中有 30 名使用月付合同,其中 12 名流失,那么 P(流失|月付)=12/30=0.4。分母是月付客户数。若总共有 20 名客户流失,则 P(月付|流失)=12/20=0.6。相同的交集对应不同分母,因此交换竖线左右的事件,通常会改变答案。
贝叶斯公式把这 2 个方向连接起来:P(A|B)=P(B|A)P(A)/P(B),条件是 P(B)>0。P(A) 是观察 B 之前对 A 的判断,P(B|A) 描述 A 成立时出现证据 B 的可能性,P(A|B) 则是看到证据后的判断。公式本身只是概率关系,不会替我们保证输入数字可靠,也不会把相关关系变成因果关系。
用短信筛查做直观练习。假设 10000 条来自目标人群的短信中,100 条是垃圾短信,基率为 1%。某条规则能标记其中 90 条垃圾短信,也会把其余 9900 条正常短信中的 5% 标记出来,即 495 条。收到标记后,短信属于垃圾短信的比例是 90/(90+495),约为 15.4%。即使规则抓住了 90% 的垃圾短信,被标记者仍以正常短信居多。
这里的 90% 是召回率,即真正的正类中有多少被抓住;15.4% 是精确率,即预测为正的样本中有多少确实为正。正常短信被错误标记的比例为假阳性率,分母是实际负类。把这些比例统一称为“准确度”,就会抹掉分母差异。解释任何指标时,都应能指出它对哪些样本计数。
动画先显示完整人群,再分别展开正类与负类,最后仅保留被标记者。观察范围的变化,就是条件概率最容易被忽略的地方。证据出现后,我们并不是凭感觉把原来的 1% 调高,而是比较证据在正类和负类中分别出现多少,并结合原先的人群规模。假阳性率看似不高,也可能被庞大的负类数量放大。
如果垃圾短信基率发生变化,精确率也可能变化。假设规则的召回率和假阳性率保持不变,基率越低,被标记者中混入的正常短信通常越多。但“保持不变”是用于比较的假设,现实中渠道变化也可能同时改变规则表现。贝叶斯更新要求我们把基率、证据质量和适用人群放到同 1 张说明里,而不是只报告最醒目的百分比。
4 动手:用小样本估计频率与期望
先用能够手算的序列练习。把 1 表示流失、0 表示未流失,按固定顺序观察标签:1、0、0、1、0、0、0、1、0、0。每观察到第 n 个标签,计算累计正类数量除以 n。第 1 次得到 1,第 2 次得到 0.5,第 4 次得到 0.5,第 10 次得到 0.3。前期频率跳动很大,这不说明总体概率在每次观察后都改变了。
在样本来自同 1 个稳定分布、抽样方式合理等条件下,样本量增加通常使频率估计更稳定。这是大数定律的直观方向,但它不保证频率单调靠近真实值,也不保证随便收集更多数据就能消除偏差。如果只访问愿意回复调查的客户,样本可能系统性漏掉沉默用户;再增加同类回复,仍可能估错总体流失率。
接着把练习迁移到公开表格数据。先读清数据说明,确认标签与每个字段的记录含义,移除直接标识客户身份的字段,并检查重复行。先划分数据,再在训练集拟合缺失值处理、数值缩放和类别编码。验证集与测试集只应用已拟合的转换规则。若先在全量数据上挑选与标签最相关的字段,再划分,测试信息已经影响了方案选择。
在训练集中计算整体流失频率,再按合同类型计算组内频率,同时列出每组样本数。某组 5 名客户中有 4 名流失,得到 0.8;另一组 500 名客户中有 300 名流失,得到 0.6。不能仅凭 0.8 就断言前组风险肯定更高。小样本比例容易波动,分组越细越容易产生偶然的极端值。遇到罕见类别,应报告样本量并限制结论范围。
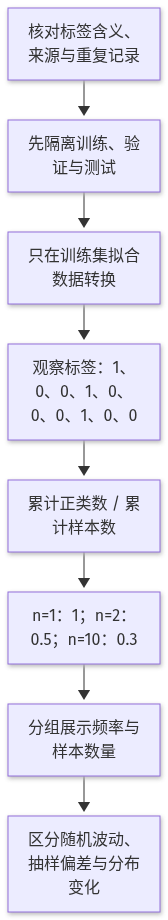
可以准备 2 列手工记录:累计样本数与累计流失频率,再画出折线。若用程序,核心计算也只是“累计标签和/累计样本数”。固定随机种子有利于复现这次排列,但不代表该排列具有特殊统计保证。为了观察抽样波动,可在训练数据内部使用若干不同排列,比较起始段的曲线;不要据此反复筛选测试集或挑选最漂亮的结果。
最后计算实际平均损失。假设某次验证预测出现 8 个漏报和 12 个误报,仍使用漏报损失 80、误报损失 5,那么总损失是 8×80+12×5=700,再除以验证样本总数得到每样本平均损失。这是指定代价表下的经验结果。记录样本来源、数量和代价假设,比只写“平均损失较低”更有意义;正式的不确定区间与推断方法留到 A8。
5 似然、先验与后验在模型里的位置
前面主要在固定模型下讨论结果概率。现在换个视角:假设 10 条标签中有 3 个正类,我们想判断未知的正类概率 p。若暂时假设各标签独立且共享相同的 p,这条具体标签序列出现的概率是 p³(1−p)⁷。把已观察数据固定,把 p 当作待比较的量,这个表达式就称为似然。它回答“哪些参数更能解释已观察的数据”。
似然不是参数的概率分布。把 p=0.2 与 p=0.3 代入,可以比较数据在这 2 个假设下有多容易出现;但不能直接把某个似然值读成“p 等于该值的概率”。如果只关心正类计数而非具体排列,表达式还会有组合系数;在这次比较 p 时,该系数对所有候选 p 相同,不影响最大值所在的位置。
最大似然估计选择让观察数据最容易出现的参数。对于上述简化模型,估计为 p=3/10。这个结果与频率一致,但并不意味着所有模型的估计都只是数标签。表格分类模型会依据 X 输出不同样本的概率,训练过程调整参数,使真实标签获得较高概率。常见的对数损失与这种思想有关:对真实正类给出极低概率,会受到较大惩罚。
先验表达看到当前这批数据之前,对参数的知识或假设。比如既往可比数据提示流失率通常不接近 0 或 1,就可以通过适当先验表达这种判断。后验则结合先验与当前数据,形式上写为“后验 ∝ 似然×先验”。这里的比例关系还需要归一化,才能成为概率分布。先验来自哪里、与当前人群是否可比,都应明确说明。
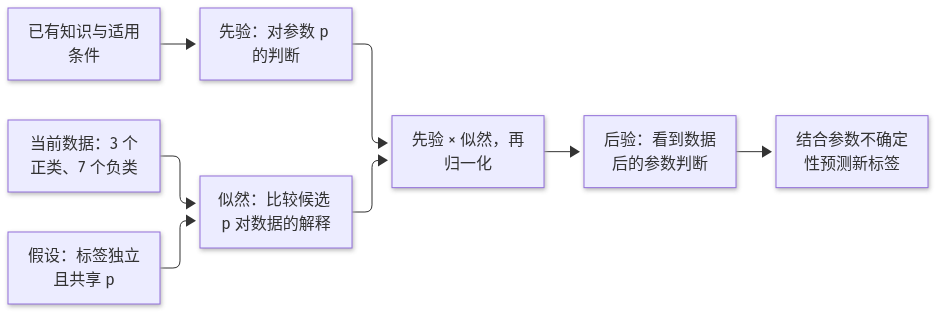
用“先放入少量虚拟正负样本”可以帮助理解平滑的效果。例如实际观察到 3 个正类、7 个负类,如果采用对应于各加入 1 个虚拟样本的特定先验,则该简单模型的后验预测正类概率为 4/12,约为 0.333。这个数字是特定假设下的预测,不是随意加数的通用技巧;它让只有极少观察时的估计避免立即落到 0 或 1。
在普通机器学习项目中,必须区分“模型预测标签的概率”和“对模型参数的不确定性”。很多分类器只提供每个输入的预测分数,并没有输出完整的参数后验。也不能把每个正则化项都未经说明地叫作业务先验。入门阶段先识别数据、参数和预测结果各自的位置即可,复杂的贝叶斯推断与模型内部求解不在本课展开。
6 常见坑:把频率当因果、忽略基率
若数据显示投诉次数多的客户流失率更高,可以把投诉记录当作预测线索,却不能推出“减少投诉记录就会减少流失”。服务质量差可能同时增加投诉和流失,客户临近离开时也可能更频繁联系支持。删掉系统里的投诉字段不会改变服务体验。预测问题关注可观察关联;干预问题还要考虑时间顺序、共同原因与对照设计,需要额外证据。
另 1 个高风险错误是让未来信息进入特征。假设在预测时点之后才生成的销户原因被加入训练表,模型可能轻易区分流失客户,测试指标也很漂亮。如果测试集来自同样污染的数据流程,测试本身无法揭穿这个问题。逐字段记录“何时产生、何时可获得”,比单纯删掉名称中带“标签”的字段更可靠。标签泄漏经常藏在看似普通的流程状态里。
类别不平衡会使准确率产生误导。若 10000 条短信仅有 100 条垃圾短信,永远预测正常就能达到 99% 的准确率,但垃圾短信召回率为 0。精确率 precision=TP/(TP+FP),召回率 recall=TP/(TP+FN),其中 TP 是正确报出的正类,FP 是误报,FN 是漏报。F1=2×precision×recall/(precision+recall),综合了这 2 个比例,但没有直接写入实际误判代价。
若验证集中完全没有预测正类,精确率分母为 0;若完全没有真实正类,召回率也无法按通常公式计算。工具可能采用默认填充值,报告时要说明这种情况。不能把缺少正类支持的漂亮数字当作充分证据。对于稀有类别,展示混淆矩阵和实际计数,往往比只保留小数点后若干位更有解释力。
动画从“准确率 99%”出发,逐步展开类别数量、混淆矩阵、特征时间和部署人群。每步都要求找出当前结论遗漏的条件。排查顺序可以是:先看标签与特征是否按时可得,再看划分是否隔离重复对象,接着看基率与指标分母,最后比较部署数据与评估数据。修复数据问题后,要重新训练并用未受选择影响的数据评价。
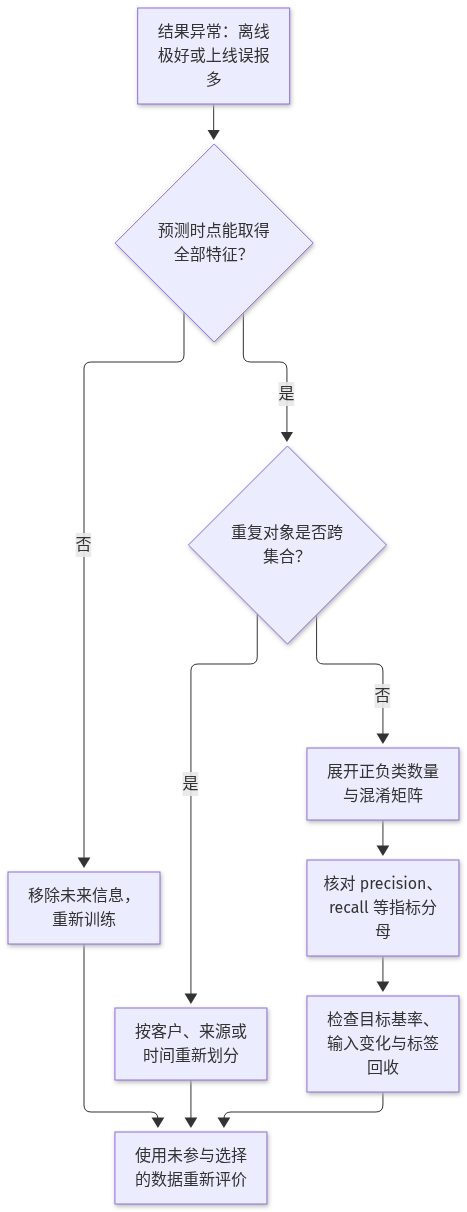
还应警惕选择性观察。若系统只复核高分短信,就只能及时知道这部分样本的真假;低分样本中的漏报可能长期不可见。根据已复核样本计算的精确率,不能直接当成整个人群的召回率。需要设计适当的抽样复核与标签回收流程,记录哪些样本有机会被检查。概率分析的起点既包括“看到什么”,也包括“为什么能看到”。
7 案例:稀有事件上的误判代价
考虑基于公开 SMS Spam Collection 进行的短文本分类练习,输入是短信文本,标签是正常或垃圾短信。可以使用词或字符片段出现情况作为特征,并训练入门分类器。公开数据的语言、采集年代和来源都有范围限制,它适合检验流程,不能据此保证当前其他语言或渠道的效果。下面的数量是为比较阈值构造的目标人群示例,不是对该数据集实测结果的报告。
设评估批次有 10000 条短信,其中 100 条为垃圾短信。阈值较低时,模型抓住 90 条垃圾短信,同时误报 495 条正常短信;于是 TP=90、FN=10、FP=495、TN=9405,精确率约 15.4%,召回率为 90%,F1 约为 0.263。每天 585 条进入复核,而真正有问题的只有 90 条。高召回率背后的人工工作量必须同时交代。
提高阈值后,假设抓住 60 条垃圾短信,误报降到 50 条;精确率为 60/110,约 54.5%,召回率为 60%,F1 约为 0.571。复核量降为 110 条,但有 40 条垃圾短信未被抓住。F1 的提高没有自动回答行动是否值得:有些垃圾短信只是广告,有些可能涉及高损失欺诈;不同错误的后果可能差别很大。
若把每次误报代价记为 1、每次漏报代价记为 20,较低阈值的总损失为 495+10×20=695,较高阈值为 50+40×20=850。这时前者更合算。若漏报代价改为 5,前者损失为 545,后者为 250,选择就改变了。代价数值应由具体流程提供,本例只展示判断如何随假设变化,不能直接用于自动删除短信。
滑块让读者改变决策阈值,同时观察误报、漏报、复核量和平均损失。使用固定的示例分数与标签计算,曲线可能呈阶梯状:阈值经过某个样本分数时,计数才变化。高分样本较少,并不意味着它们都预测正确。若复核能力只有每天 200 条,还必须检查候选阈值能否满足容量约束,不能仅在损失表中挑最小数字。
ROC-AUC 常用于衡量分数的排序能力,可以直观理解为随机取 1 个正类和 1 个负类时,正类分数更高的程度,平分通常按 0.5 计。它综合了不同阈值下的表现,不对应某个实际复核量,也不保证概率准确。稀有事件中还应查看精确率与召回率的关系。最终把阈值固定在验证阶段,再在测试集报告计数、precision、recall、F1、AUC 和所采用的代价。
8 把概率假设写进问题定义
能够执行的问题定义应先说明预测对象与单位。流失任务的单位是客户、合同还是账户?同 1 客户有多份合同,标签是否分别生成?短信任务的单位是消息还是发送者?如果训练按消息随机划分,同 1 发送者的近重复文本可能跨越集合。选择单位会影响独立性假设、去重方式和评估所能代表的使用场景,需要在建模之前写清楚。
然后规定时间。以真实未来流失预测为例,可以约定在每月末观察过去 90 天的使用与服务记录,预测接下来 30 天是否流失。只有观察时点之前已可获得的数据能够进入特征。结果窗口尚未结束的客户,标签不能仓促记为未流失。若用没有足够时间字段的公开表格练习,应明确它只能支持相应的静态分类实验,不能虚构完整的时间回测。
接下来写抽样与分布假设。训练数据来自哪些地区、渠道、时间段,是否覆盖目标用户?是否为了训练方便提高了正类采样比例?如果从负类中只保留很少样本,训练集的正类比例就不再等于部署基率。这样训练出的分数不能未经处理就解释为目标人群概率,评估也应尽量保留真实类别比例,或清楚说明加权依据与适用条件。
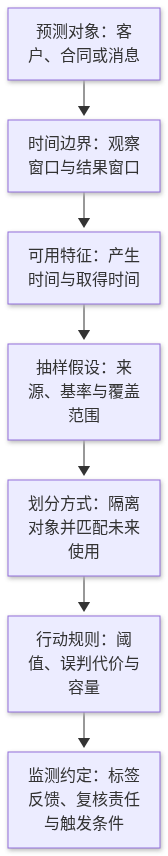
指标约定应包含正类定义、阈值选择依据、复核容量和主要错误代价。例如“在每天最多复核 200 条的条件下,提高垃圾短信召回率,同时报告精确率和误报数量”。这种表达比“追求最高 AUC”更接近实际决策。若正常短信被误删的代价很高,可以把自动动作改为提示或进入待审区,再评估整体流程,而不是要求模型独自消除所有不确定性。
最后约定失效信号与责任。若合同类型比例突然改变、新渠道出现、文本语言变化或图片采集设备更换,应检查输入分布与标签反馈。输入变化本身不必然等于效果下降,但它是复查证据的触发条件。写明谁收集延迟标签、谁复核异常、何时调整阈值或重新训练,概率假设才有机会在使用过程中持续被检验。
9 不确定性:模型输出分数不是概率保证
分类器输出 0.9,首先表示模型依据训练目标与已学参数给出的数值。这个数值可能具有概率形式,却不自动满足“所有得分约为 0.9 的样本中约有 90% 为正类”。后一种对应关系称为校准。排序能力、分类表现和校准程度是相关但不同的性质;模型可能很会把高风险样本排在前面,同时普遍给出过高分数。
检查校准的入门办法是分箱。把验证样本按分数分成若干区间,对每组比较平均预测值与实际正类频率。例如某组平均分数为 0.8,实际只有 55% 为正,就出现明显差距。每组还要展示样本数:只有 5 条短信的区间容易因偶然而偏离。分箱边界也会影响图形,不应把某次分箱结果当成精确的自然规律。
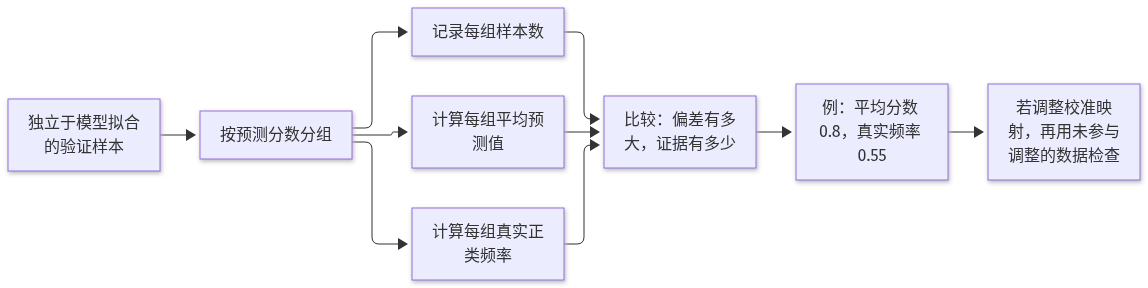
校准调整可以利用独立的验证数据学习分数到概率的映射,但调整后的效果仍要在未参与调整的数据上检查。它不能补回缺失的人群,也不能修复未来字段泄漏。若部署基率或输入与标签关系发生变化,原先校准良好的模型仍可能失准。因此“已经校准”必须附带数据范围与时间,而不是成为长期有效的认证。
不确定性还可能来自不同来源。照片遮挡、短信表述含混会使现有信息不足;某类图片从未出现在训练集中,则反映覆盖不足。单个最高类别分数通常不能可靠区分这些来源。Fashion-MNIST 分类器面对自然场景中的衣服照片,甚至面对完全无关图片,都可能输出很高的类别分数;因为它仍被要求在已有标签中作出选择。
实际流程可以设置人工复核、补充信息和暂缓判断等出口。比如流失模型对某类新合同缺乏验证证据时,先收集样本,限制自动触达规模,并追踪真实结果。阈值越高并不天然越安全,它只是改变接收行动的人群和错误结构。需要同时看分数分布、标签反馈、群体差异与具体后果,才能判断行动是否合适。
到这里,概率语言的作用已经清楚:它把未知结果、观察条件和证据更新连接起来,也让我们看见模型结论的边界。报告“分数 0.9”时,最好同时能回答训练数据来自哪里、这个分数在哪些样本上经过检查,以及遇到新情况时如何处理。模型给出数值,人负责规定解释条件,并用持续观察判断这些条件是否成立。
放进方案里
在方案的问题定义中写清预测单位、正类含义、观察时刻与结果窗口。例如以客户为单位,在月末用过去 90 天的记录预测未来 30 天是否流失,并列出月费、合同类型、服务投诉等特征何时可得。若使用公开静态数据练习,应注明时间信息的限制,避免把静态分类结果写成已验证的未来预测能力。
数据部分记录来源、时间范围、正类比例、去重规则与划分方式。说明训练、验证、测试各自承担的角色,以及缺失值处理和编码仅在训练集拟合。若客户重复出现,应按客户隔离;若任务面向未来,应说明时间边界。抽样改变过类别比例时,要记录原始基率与采样比例,解释分数为何需要重新评估。
评价部分同时给出样本总数、混淆矩阵、precision、recall、F1 与 AUC,注明正类和阈值。把误报与漏报代价写成可修改的假设,并根据验证集上的损失和复核容量选择阈值。测试集只用于评估定下的方案;小群体结果附样本数,不能用没有足够观察支持的比例作保证。
概率解释部分交代是否检查过分组频率与校准,适用人群是什么。输出分数只能在经过检验的条件下解释为风险估计。对未覆盖的渠道、语言或合同类型,设置复核与补充数据流程,并注明哪些证据足以支持扩大使用范围。
上线后的记录包括输入变化、实际标签回收、每日复核量与错误后果。指定负责查看异常的人,规定何时复查基率、调整阈值或重新训练。最终交付物应让接手者能追溯每个概率判断的分母、数据版本和代价依据,而不只是看到 1 个好看的总体指标。
10 小结:下一步统计与信息论(A8)
随机变量规定我们观察什么,分布描述可能取值,期望给出按概率加权的平均。条件概率要求明确分母,贝叶斯公式连接证据出现前后的判断;似然比较参数对已观察数据的解释能力,先验与后验则说明已有知识如何参与更新。
回看短信案例,可以自问:为什么召回率为 90% 时精确率只有约 15.4%?为什么提高阈值可能提高 F1,却增加指定代价下的损失?为什么对测试集重复选阈值会削弱结论?如果能用人群规模、指标分母与数据用途回答,就已经掌握本课的关键联系。
A8 将继续讨论怎样从有限样本推断总体、怎样表达估计的不确定性,以及信息论如何描述不确定程度。本课先保留最实用的习惯:定义事件、说明条件、报告数量、分开估计与行动,并在新证据出现时重新检查判断。