1 为什么先画 AI 全景:演示成功不等于可上线
看到系统能识别照片、判断留言主题、预测用户是否流失,人们很容易把人工智能理解成某种无所不能的程序。学习全景的目的,是把这些表现还原成可以提问、测量与验证的工作:系统收到什么输入,需要输出什么答案,答案根据什么证据产生,错误又由谁承担。能演示成功,并不等于能在新的数据上稳定工作;能输出流畅文字,也不等于其中的事实已经得到核验。
人工智能(AI)是一个宽泛领域,包含规则推理、搜索、机器学习等方法。机器学习(ML)让程序利用数据调整参数,从而完成预测或决策。深度学习属于机器学习,通常使用多层神经网络学习表示。生成式 AI 按学习到的规律生成文本、图像等内容,与判断图片类别的分类模型有不同的输出形式。这些名称不是能力等级,也不能代替具体评估。本课先建立共同框架,不展开神经网络结构、优化算法推导或大模型内部机制。
设想你面对 3 个任务:根据账户近期行为识别可能流失的用户,根据商品以外的日常物体照片判断类别,根据短新闻判断主题。它们的输入分别是表格、图像与文本,输出都可以是类别。可迁移的部分包括明确标签、整理样本、划分数据、建立基线、比较错误;需要分别设计的部分则包括特征表达、标签含义和允许采取的行动。不要因为都叫分类,就认为相同的分数具有相同的业务价值。
本课用公开的 UCI Bank Marketing 数据讨论表格预测,用 Fashion-MNIST 说明图像分类,用 AG News 说明短文本分类。Bank Marketing 的目标是预测客户是否认购定期存款,它不是用户流失数据;若任务改为流失,必须另行规定观察窗口和流失标签,不能把认购失败直接改名为流失。公开数据帮助我们重复实验,却不能自动证明模型适用于本地用户、当前年份或新的采集设备。
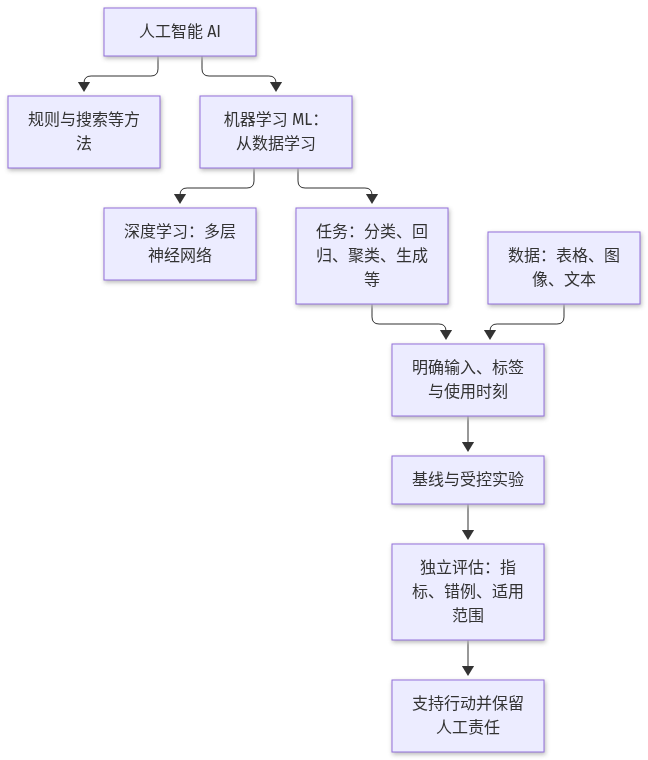
学习结束时,你应当能够把“我们想加点 AI”改写成可检验的问题,指出测试成绩中可能存在的漏洞,并说明一个简单模型为何值得先做。起点是证据意识:每个漂亮结果都应附带数据范围、划分方法、评价指标和限制条件。没有这些条件,准确率只是孤立的数字。
2 用预测时刻、输入、标签与行动定义问题与数据边界
问题定义可以写成一句完整的话:在什么时刻,使用当时已经知道的信息,为哪个对象预测什么结果,以支持什么行动。例如,在联系客户之前,根据客户基本属性与历史活动预测本次是否认购定期存款,帮助安排有限的联系名额。这句话把预测时刻固定下来,也给特征设置了边界。联系人还不知道的信息,不能悄悄出现在模型输入里。
以 Bank Marketing 的 bank-full.csv 为例,原始文件有 45211 条记录,目标列 y 取 yes 或 no。候选特征包括 age、job、education、balance、housing、loan、campaign、previous 等;duration 表示本次联系时长。如果要在联系之前预测,duration 此时尚不存在,应当排除。它可能与结果高度相关,但这种相关性不能越过时间边界。用于通话结束后分析时,问题定义已经改变,应该作为另一个实验说明。
标签不是自然界自动给出的真相。流失任务可以把“观察期后 30 天没有登录”作为标签,也可以用“取消订阅”作为标签,得到的预测对象和错误含义并不相同。新闻主题可能有重叠,图片也可能含有多个物体。先写清标注规则、冲突处理和未知类别的处理方式,再训练模型,才能知道错例来自模型能力,还是来自任务本身含糊。
数据边界还包括授权范围、采集来源、时间范围和样本单位。公开可下载不等于可以忽略许可、个人信息与使用条件。不要把不需要的姓名、电话或完整文本身份线索带入实验。若同一客户出现多次,应明确一行代表客户还是一次活动;若同一新闻被转载多次,也要考虑它们是否构成重复样本。这些决定影响数据划分,也影响指标所代表的人群。
训练集用于学习参数,验证集用于选择方案与阈值,测试集用于在方案确定后做最终评估。入门实验可按约 60% / 20% / 20% 划分,并保持类别比例接近。按类别比例抽样称为分层划分。但如果部署目标是未来月份,应优先考虑按时间切分;如果同一对象重复出现,应按对象分组。分层、时间与分组是不同约束,不能认为一次随机划分同时解决了它们。
数据划分前可以检查文件结构与明确不依赖数据统计的规则;需要从数据学习的操作必须留在训练范围内。例如缺失值填充值、标准化的均值与词汇表都应在训练集拟合,再应用于验证集和测试集。否则验证数据已经参与了模型建设,分数可能偏乐观。先画清信息从哪里进入系统,往往比先挑模型更能减少错误。
3 样本、特征、损失与泛化:可迁移的核心机制
一个监督学习样本包含输入 x 与目标 y。表格里的年龄、职业等输入字段经过处理后成为特征;图像可以由像素表达;短文本可以转换成词频或其他数值表示。模型接收特征并给出预测,训练则利用已知标签调整参数。推理是使用已经固定的处理规则与模型处理新输入。训练与推理连接紧密,但它们可使用的信息并不相同。
特征不是越多越好。客户编号通常只是在标记对象,文件路径可能暗藏类别名称,新闻来源也可能成为主题的替代线索。模型会利用能够降低训练错误的规律,却不会主动判断这种规律是否符合人的意图。设计实验时应问:这个字段在真实预测时能否取得,它与目标的联系是否可能只是采集过程留下的痕迹。
分类、回归与聚类解决不同问题。分类预测离散类别,例如新闻属于体育还是科技;回归预测数值,例如未来 7 天的用电量;聚类按相似性组织样本,不需要预先给定类别标签。聚类得到的组不自动具有业务含义。生成任务则输出新的内容,需要进一步评价相关性、事实性与可用性。本课把监督分类作为共同例子,避免在多个任务间混用结论。
训练时通常会定义损失函数,用来衡量模型输出与标签的差异,并通过优化过程降低训练损失。评价指标则用于回答使用者关心的问题。两者可能不同:模型训练时优化某种连续损失,最终却以召回率或 F1 比较方案。训练损失下降说明模型更适合训练样本,不能单凭它推断未来表现已经改善。
泛化指模型对未见样本仍有用。若训练成绩很好而验证成绩明显较差,可能存在过拟合,即模型过度适应训练数据中的细节与噪声。若训练与验证都差,则需要检查特征、标签、模型表达能力和训练设置。不要只凭这两个现象给出确定诊断,它们是进一步调查的线索。更复杂的模型可能提高能力,也可能增加过拟合与维护成本。
基线是理解收益的参照物。对认购数据,可以先构建总是预测 no 的多数类基线,再训练逻辑回归;图像任务可以先用简单分类器;文本任务可以先用词频表示加线性分类器。基线的价值在于暴露任务难度和指标陷阱。只有超过合理基线,而且额外成本可以接受,复杂方案才获得了继续投入的证据。
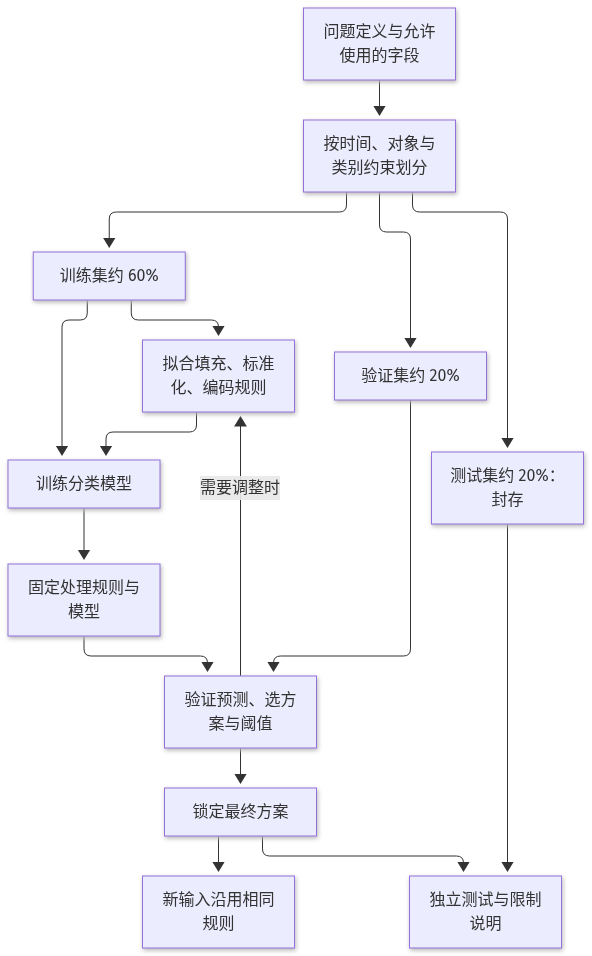
动画把信息流拆成 6 步。先观察划分边界,再观察预处理参数从哪里来,最后观察验证结果如何影响模型选择。测试集应保持封存;它不参与动画中反复试验的回路。如果在看到测试结果后继续选择特征,下一次报告就不能把同一测试集当作完全独立的最终证据。
4 落到可复现基线:Bank Marketing 实验设计
下面把“预测是否认购”落成一个可复现的基线实验。使用 UCI Bank Marketing 中的 bank-full.csv,保留 y 作为标签,排除 duration。数据包含数值字段与类别字段,不能把职业名称直接当作连续数值。入门方案可以对数值字段填充缺失并标准化,对类别字段填充缺失并做独热编码,再把组合后的特征交给逻辑回归。
独热编码为类别建立指示位置,例如 housing 的 yes 和 no 可以对应不同列。它不强行规定职业之间的大小关系。标准化则用训练数据得到的位置与尺度调整数值字段,让不同量纲更易处理。本课只要求理解“先拟合规则,再应用规则”;具体数学推导与更复杂的编码方法可以后续学习。
先固定随机种子 42,再生成训练、验证和测试索引,记录文件来源与版本。随机种子帮助重复同一随机过程,但不能消除不同划分之间的波动。这里的随机分层划分用于演示机制,衡量的是相近采样条件下的表现。若要承诺下一阶段活动的效果,还需要时间划分或新的数据验证,并确认同一客户是否跨越边界。
实验至少保存 3 类信息:输入记录,包括文件校验值、字段清单与标签映射;过程记录,包括划分索引、预处理与模型配置;结果记录,包括验证指标、阈值和错例。只保存模型文件无法说明它是如何得到的,只保存最终分数也无法重现数据边界。记录可以很简单,但必须能把一次结果追溯到明确的输入与决策。
验证阶段先用默认阈值查看结果,再根据行动限制选择阈值。例如每批只能联系有限数量的客户,就同时检查预测为正的人数和其中实际认购的比例。阈值选定后,应固定特征、处理规则、模型和阈值,再打开测试集。若验证结果很差,先检查数据与基线,再决定是否调整模型,不能把测试集当作新的验证集反复试探。
可复现也意味着说明实验没有回答的问题。这个公开数据来自特定历史环境,标签反映的是既有活动下的认购情况。模型分数高,不能证明联系本身带来了认购,也不能证明按模型挑选客户会提高整体收益。预测关联与行动效果是不同问题,后者通常需要另行设计对照评估。本课先把预测证据写可靠。
5 动手:分类 Pipeline 与信息流
把解压后的 bank-full.csv 放在笔记本可访问的位置,准备 pandas 与 scikit-learn。下面的代码演示完整的信息流;正式记录时还应保存下载来源、文件校验值以及 Python 和依赖版本。它不预设某个指标必然达到多少,运行得到的输出才是这次实验的结果。
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (
    precision_score, recall_score, f1_score, roc_auc_score,
    confusion_matrix,
)

df = pd.read_csv("bank-full.csv", sep=";")
X = df.drop(columns=["y", "duration"])
y = df["y"].map({"no": 0, "yes": 1})
X_train, X_hold, y_train, y_hold = train_test_split(
    X, y, test_size=0.4, stratify=y, random_state=42
)
X_val, X_test, y_val, y_test = train_test_split(
    X_hold, y_hold, test_size=0.5,
    stratify=y_hold, random_state=42
)

numeric = X_train.select_dtypes(include="number").columns.tolist()
categorical = X_train.select_dtypes(exclude="number").columns.tolist()
num_pipe = Pipeline([
    ("fill", SimpleImputer(strategy="median")),
    ("scale", StandardScaler()),
])
cat_pipe = Pipeline([
    ("fill", SimpleImputer(strategy="most_frequent")),
    ("encode", OneHotEncoder(handle_unknown="ignore")),
])
prep = ColumnTransformer([
    ("num", num_pipe, numeric),
    ("cat", cat_pipe, categorical),
])
model = Pipeline([
    ("prep", prep),
    ("clf", LogisticRegression(max_iter=2000)),
])
model.fit(X_train, y_train)

def report(labels, scores, threshold):
    pred = (scores >= threshold).astype(int)
    return {
        "precision": precision_score(labels, pred, zero_division=0),
        "recall": recall_score(labels, pred, zero_division=0),
        "F1": f1_score(labels, pred, zero_division=0),
        "ROC_AUC": roc_auc_score(labels, scores),
        "confusion_matrix": confusion_matrix(
            labels, pred, labels=[0, 1]
        ).tolist(),
    }

val_scores = model.predict_proba(X_val)[:, 1]
print(report(y_val, val_scores, threshold=0.5))
# 先完成验证分析,再固定阈值并评估封存的测试集。
流水线把预处理和分类器连在一起,fit 只接收训练数据。预测验证集时,填充值、标准化参数和类别编码沿用训练阶段的规则。handle_unknown="ignore" 允许输入训练时未见的类别,但这不代表模型已经理解新类别;如果未知类别比例突然升高,仍然应当诊断来源变化。数值字段中的特殊值也要结合数据字典判断,不能认为所有负数都应当填成缺失。
读代码时,重点看数据如何流动,而不是背下接口名称。y 的 yes 被映射为 1,因此 precision 和 recall 都以认购为正类。混淆矩阵按真实类别为行、预测类别为列,固定顺序为 0、1。若漏掉标签映射或交换正类,同一个函数名可能回答完全不同的问题。测试集虽已分出,此时还没有用于比较方案。
可以在验证集上单独记录多数类基线、逻辑回归默认阈值结果和候选阈值结果。每次只改变一个有明确理由的条件,并在笔记里写下预期与观察。如果训练出现未收敛提示,应检查求解过程与设置,不能直接忽略。待方案固定后,沿用同一个 report 函数报告测试结果;不要把示例输出补写成没有实际运行过的实验事实。
6 精确率、召回率、F1 与 ROC-AUC 怎么读
把认购记为正类,预测认购且实际认购是真正例 TP;预测认购但实际未认购是假正例 FP;预测未认购但实际认购是假负例 FN;预测未认购且实际未认购是真负例 TN。准确率是正确预测占全部样本的比例。若正类稀少,总是预测负类也可能得到很高准确率,因此至少同时报告类别数量与混淆矩阵。
精确率 precision = TP / (TP + FP),回答“预测为正的对象里有多少确实为正”;召回率 recall = TP / (TP + FN),回答“实际为正的对象里找到了多少”。F1 是精确率和召回率的调和平均,常写为 2PR / (P + R)。分母为 0 时应明确报告约定。F1 没有直接计入真负例,也不能代替具体错误成本,所以不能把它视为所有任务的唯一答案。
假设有 1000 个待预测对象,其中 100 个实际为正。某个阈值得到 TP=60、FP=90、FN=40、TN=810,则精确率为 0.40,召回率为 0.60,F1 为 0.48,准确率为 0.87。总是预测负类的准确率反而为 0.90,但召回率为 0。这组数字是教学示例,并非 Bank Marketing 的运行结果,作用是让不同指标的含义可以手算核对。
ROC-AUC 常简称 AUC,用连续分数衡量模型对正负样本的排序能力,可理解为随机抽取正负样本时正样本排在前面的程度,并对并列作约定。它不对应某个固定阈值,也不直接表示预测概率是否准确。类别很不平衡时,还应查看精确率—召回率曲线及明确约定的汇总指标,避免仅凭较高 ROC-AUC 判断实际可用性。
滑动阈值会改变被判为正类的范围。对固定的一组分数,阈值降低时召回率不会下降,但精确率未必单调变化;F1 也可能先升后降。联系人数增加还会提高行动成本。先用验证数据比较,再锁定阈值,才能让测试结果保留独立性。界面中的小样本用于理解机制,不代表真实客户的最优阈值。
图像与文本通常是多分类任务。宏平均 F1 先计算每个类别的 F1 再平均,使小类别也有相同权重;加权平均按各类别样本数量加权,可能掩盖小类别表现。Fashion-MNIST 要检查衬衫与相似上衣之间的混淆,AG News 要检查短标题、模糊主题和特殊来源。总分相同的模型,可能把错误集中在完全不同的人群与类别。
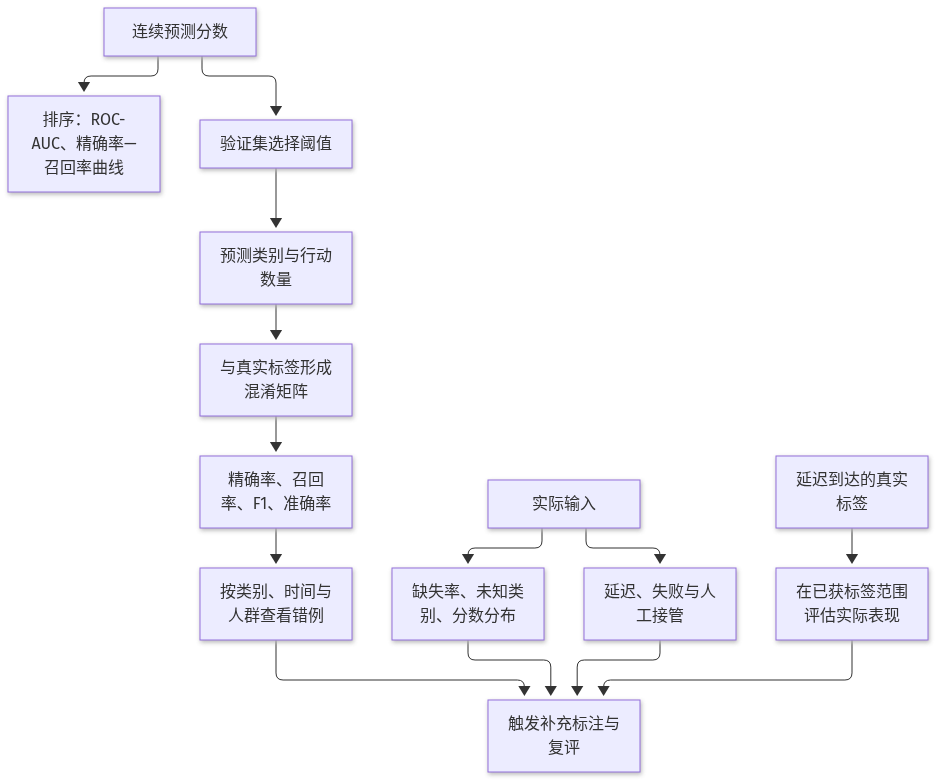
观测还应覆盖输入缺失率、未知类别比例、分数分布、处理延迟和人工接管情况。上线后标签可能延迟出现,不能拿尚未确认结果的样本直接计算完整召回率。需要分别记录“已经拿到标签的范围”和“仍在等待的范围”。概率校准则关心预测为 0.7 的一组样本是否大约有 70% 为正,它与排序指标回答不同问题,入门阶段先知道区别即可。
7 常见坑:泄漏、类别不平衡、分布偏移
数据泄漏是最容易制造虚假进步的问题。除了把 duration 放进联系前预测,还包括把目标列的改写形式放入特征、先在全量数据上拟合预处理、让近似重复样本跨越训练和测试边界。泄漏不一定来自恶意操作,经常来自便利性的选择。排查时应追问每个字段的产生时间、每个统计量的拟合范围和每条记录的对象归属。
类别不平衡也不能靠一个开关解决。调整类别权重可能改善少数类识别,但也可能增加假正例;过采样应在训练划分内部执行,不能先复制样本再切分,否则相同记录可能落入测试集。阈值调整则改变现有分数的决策方式。它们是不同手段,应在同一验证协议下比较,并报告正类比例和行动数量。
分布偏移指实际输入或输入与标签的关系发生变化。例如新的客户群体加入、照片从灰度扫描图变成手机拍摄、新闻语言风格发生变化。固定模型可能仍然正常运行,却逐渐给出不可靠结果。仅凭输入分布变化不能证明预测已经变差,但它能触发抽样标注与补充评估。反过来,输入看起来相近,也不保证标签关系没有变化。
另一个反模式是只追排行榜总分。Fashion-MNIST 上提高分类成绩,不代表能直接处理衣柜照片;AG News 上效果好,不代表适合本地社群的短留言。任务范围、输入格式和标签体系都可能不同。把公开数据当作学习与比较工具,同时保留真实目标场景的独立评估,才能避免把基准成绩误写成部署承诺。
最后,不要把高置信度当作正确证明,也不要把相关特征当作原因。某职业群体分数较高,可能反映历史采样或联系方式,并不证明职业导致认购。预测系统输出的是依据训练经验得到的分数;是否采取行动,还要考虑成本、适用范围、公平性与人工复核。遇到高影响决策,必须明确谁有权审核、申诉与停止使用。
8 案例:验证好看但上线失效
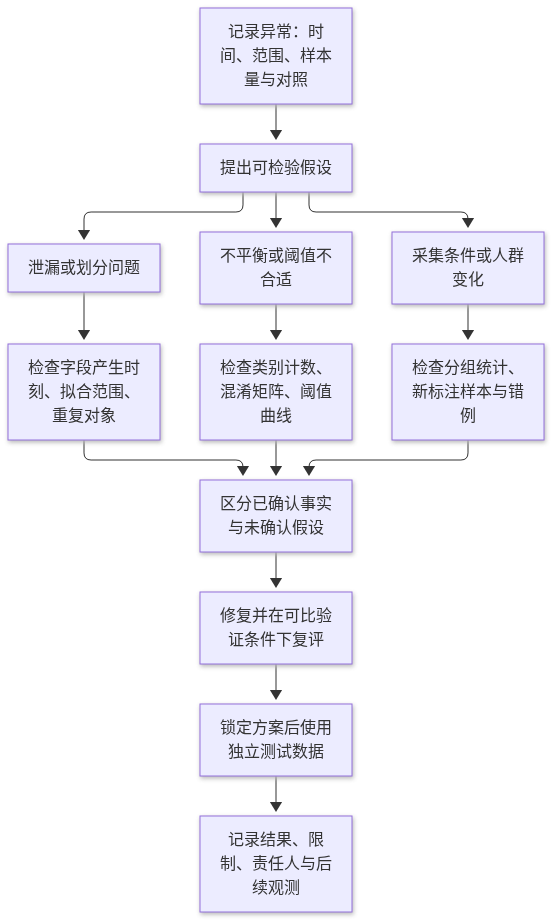
先看 Bank Marketing 中一个可实际检验的故障假设。实验甲保留 duration,实验乙排除 duration,其他划分与设置保持一致。若实验甲成绩更好,不能立刻宣称找到更强的联系前模型。首先查看数据字典:通话时长在联系结束后才能完整获得。对于联系前排序,实验甲越成功,越需要警惕它利用了部署时不存在的信息。具体差距必须通过运行得到,不能预先编造。
修复不是简单删除字段后宣布结束。需要重新生成受影响的特征与实验结果,核对是否还有其他事后字段,并更新模型使用说明。如果旧结果已用于方案比较,应注明其信息边界无效。若原始数据没有稳定客户标识,就无法彻底排除同一客户跨集合的问题;报告应保留这个限制,不能假定随机种子能够解决身份重叠。
再看 Fashion-MNIST。该数据通常以 60000 张训练图和 10000 张测试图提供,每张图为 28×28 灰度图,共 10 类。可以从原训练部分划出验证集,保留原测试集。若模型经常把 shirt 与 T-shirt/top 混淆,应先查看真实错例、标签与图像细节,再比较每类召回率。某些低分辨率轮廓确实相似,继续增加模型复杂度未必是唯一合理方向。
如果把手机拍摄的彩色服装照片直接缩放后送入该模型,背景、光照、角度和物体位置都会变化。即使程序没有报错,也可能已经越过数据适用范围。诊断时应收集经授权的目标照片,明确标签映射并做独立评估;若照片同时含有多件衣物,甚至需要重新定义任务。输入尺寸兼容不等于问题定义兼容。
AG News 常见版本包含 120000 条训练记录与 7600 条测试记录,主题为世界、体育、商业和科技。可先把标题与描述组成短文本,用词频表示和线性模型建立基线。若验证成绩异常高,应检查重复稿件、近似标题以及来源线索;若只输入很短的标题后成绩下降,也要检查是否因上下文减少而产生合理歧义。准确率变化需要结合输入条件解释。
这 3 个数据集展示了不同故障:表格任务可能越过时间边界,图像任务可能越过采集边界,文本任务可能越过内容与来源边界。动画把“分数异常”逐步连接到可检查的证据,再连接到修复与重评估。它没有预设所有问题都来自模型;同样的诊断顺序也可以用于流失预测、垃圾邮件识别等入门任务。
9 把全景收成可提问的选型清单
学完全景后,不要急着回答“我们要用哪种模型”。先把业务愿望改写成一组可检验的问题,并确认眼下能回答到哪一层。一份可用的选型清单至少覆盖下列条目;写不出来的条目,就是还没准备好做模型承诺的地方。
- 预测时刻与行动:在什么时点做预测,预测结果将触发什么行动,谁承担错误代价。
- 输入与标签边界:当时能合法取得哪些字段,标签如何定义,哪些字段因时间或授权必须排除。
- 数据代表谁:时间范围、来源、许可与样本单位;公开数据与本地数据差在哪里。
- 划分与预处理纪律:训练 / 验证 / 测试如何切开,预处理参数只在训练集拟合的证据在哪。
- 基线与指标:多数类或简单规则基线是多少;精确率、召回率、F1、AUC 各自对应什么业务问题;阈值受什么运营约束。
- 主要失效模式:泄漏、类别不平衡、分布偏移分别会如何伪装成“效果很好”。
- 还未覆盖的范围:本课不展开神经网络结构、优化推导或大模型内部机制;若任务是生成或因果干预,需要另开问题卡。
把清单写成可讨论的句子,而不是形容词。例如“在外呼前预测是否认购,排除 duration,用分层 60/20/20 划分,先超过多数类基线的 F1,再谈更复杂模型”。这样评审可以追问证据,也可以决定先补数据、先做基线,还是暂缓上线。
选型清单的产出是决策,不是模型文件。若第 1–3 条写不清,优先澄清问题与数据;若第 4–6 条写不清,优先做可复现实验;只有清单闭环后,才值得比较更重的模型族。下一课用 Python 把这些约定落成可运行的实验脚本。
放进方案里
在方案中,先用一段话定义预测时刻、输入、标签与行动。例如:“本实验在联系前,使用客户属性和历史活动预测是否认购定期存款,帮助安排有限联系名额。”注明数据来自 UCI Bank Marketing 的 bank-full.csv,公开数据用于验证流程,实际活动效果需要独立评估。写明样本单位、数据时间范围、许可检查与必要的数据最小化措施,让读者知道结论适用于哪里。
随后写清数据边界:排除本次通话时长 duration,标签 yes 为正类,采用约 60% / 20% / 20% 的训练、验证与测试划分。说明随机分层仅代表相近采样条件;若目标是未来活动,应补充时间评估,并检查客户重复。预处理只在训练集拟合,测试集封存至特征、模型和阈值确定。保存来源、文件校验值、划分索引、依赖版本和配置,以支持复现。
评价部分同时列出多数类基线和候选模型,报告精确率、召回率、F1、ROC-AUC、混淆矩阵与预测为正的人数。阈值依据验证数据与联系能力选择,不把某个公开数据分数直接写成收益承诺。按重要类别或群体查看错误,注明样本量;没有运行得到的数字留待实验填写,避免把教学示例混入结果表。
最后约定试用与退出条件:先在有限范围内收集经授权的新样本,监测缺失率、未知类别、分数变化以及标签到达后的实际表现。出现明显偏移或关键群体错误集中时,暂停自动行动并交由负责人复核。列明人工接管方式、复评时间和模型版本责任人,把尚未解决的客户重叠、历史偏差与行动效果问题写入限制。方案的价值是让后续决策有证据可依。
10 小结:下一步去 Python 工具链(A2)
- 能否用预测时刻、对象、输入、标签和行动完整描述任务?
- 是否区分 AI、机器学习、深度学习与生成式 AI 的范围?
- 每个特征在预测时刻是否已经可用,标签规则是否明确?
- 划分是否考虑类别比例、时间、重复对象与近似重复内容?
- 预处理是否只在训练集拟合,测试集是否保持独立?
- 是否有简单基线,并同时报告精确率、召回率、F1、AUC 与混淆矩阵?
- 阈值是否在验证集选择,错误成本与行动容量是否写清?
- 是否检查分组错例、分布偏移、复现记录与人工接管条件?
当你能解释一个分数为什么可信、在哪里不可信,以及下一步如何收集证据,就已经建立了继续学习具体模型所需的全景。