把数据排成矩阵之后,我们还要回答:哪些变化值得保留,哪些方向几乎重复,为什么看似细小的输入误差会让结果大幅变化?本课从几何图像出发,认识特征分解、投影、奇异值分解与条件数。目标是能解释和检查模型前的数据变换,而不是手写大型矩阵分解程序。
1 线性代数二:为什么需要特征分解与几何直觉
设想使用公开的 IBM Telco Customer Churn 数据集预测客户流失。每行是客户,每列可以是入网月数、月费用、累计费用以及经过编码的合同类型。模型看到的是坐标,业务看到的是行为。如果月费用与累计费用同时增长,数据中的变化就可能集中在某些方向,不能简单把列数当作独立信息的数量。
几何直觉把每个样本看作空间中的点,把每个特征看作坐标轴。只有 2 个特征时,我们可以画散点图;有 30 个特征时,仍可用向量和矩阵表达同样的关系。点云沿某个方向拉得很长,表示沿该方向的样本差异较大;点云贴近某个平面,表示存在近似冗余。降维就是寻找较少的坐标,让重要结构尽量留下。
这里的“重要”必须先说明。主成分分析,也就是 PCA,通常把方差较大的方向视为优先保留的方向;分类任务则关心能否区分标签。这 2 个目标并不等价。大量客户的费用差异可能占据主要方差,真正提示流失的小群体差异却很弱。因此,理解几何结构可以提出候选处理方法,不能直接替代验证集上的任务评估。
在 Fashion-MNIST 图像分类中,1 张 28×28 灰度图可以展开成 784 维向量。许多相邻像素会共同变化,降维有机会减少存储和后续模型计算。在公开短文本数据集 SMS Spam Collection 中,词频或 TF-IDF 向量通常稀疏且维数很高,低秩表示可以合并部分共现结构。这些场景都需要问:压缩保留了什么,又丢掉了什么?
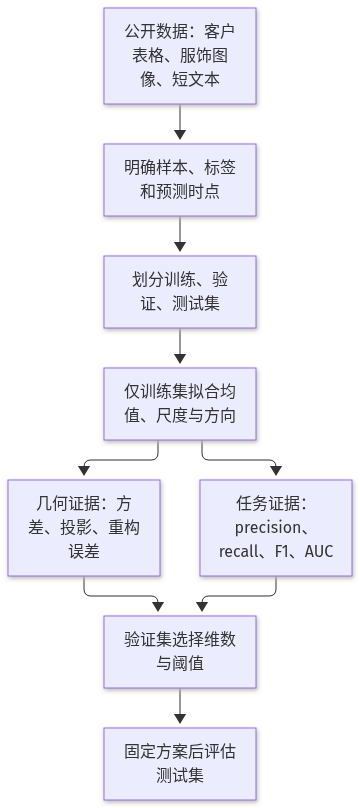
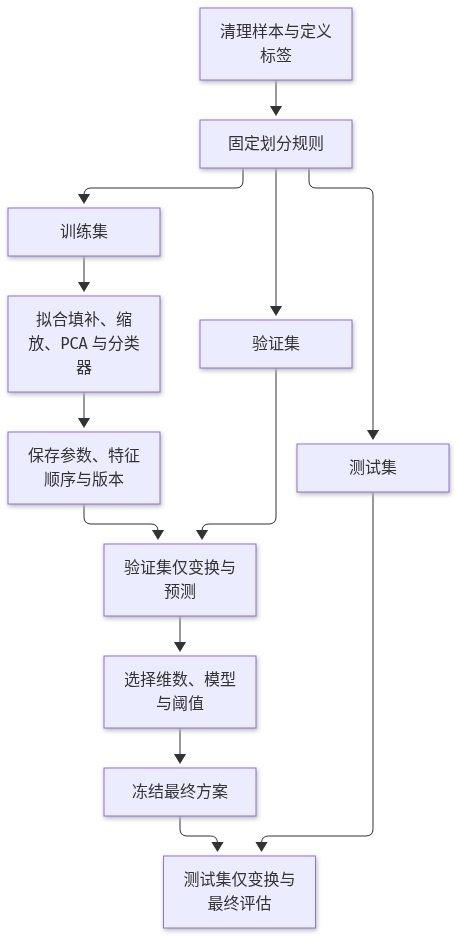
先为实验建立边界。表格样本可按分层方式划分训练集、验证集和测试集,例如比例为 70%、15%、15%;同客户多条记录要按客户分组,有时间顺序时应优先按时间划分。均值、尺度和降维方向都只能从训练集估计。验证集用于选维数与阈值,测试集在方案固定后使用,否则几何变换也会成为数据泄漏入口。
2 线性代数里的特征值与特征向量在做什么
矩阵既能表示数据,也能表示变换。把向量 v 送入方阵 A 后得到 Av。如果某个非零向量满足 Av=λv,那么它经过变换后仍留在原来的直线上。v 称为特征向量,λ 称为对应的特征值。特征向量描述特殊方向,特征值描述沿该方向的伸缩及是否反向。零向量不算特征向量,因为它无法确定方向。
例如 A=[[2,1],[1,2]],取 v=[1,1],得到 Av=[3,3]=3v;取 w=[1,-1],得到 Aw=[1,-1]=w。沿对角线方向的向量长度变成原来的 3 倍,沿另 1 条对角线的向量长度不变。任意二维向量都可以拆成这 2 个方向上的分量,再分别变换。这样看矩阵,比逐项追踪每个坐标更容易理解整体效果。
特征向量可以乘任意非零常数,仍代表相同方向。因此软件可能返回 [1/√2,1/√2],也可能返回它的相反数,不能据此判断结果矛盾。做投影时通常把方向归一化,让长度等于 1;比较不同运行结果时,应比较方向张成的空间,而不是要求每个符号完全相同。
PCA 关心的是训练数据中心化后的协方差矩阵。设 X 有 n 行样本、p 列特征,每列减去训练均值后为 Xc,则样本协方差为 C=XcᵀXc/(n−1)。C 的对角元素是各列方差,非对角元素描述共同变化。它是实对称矩阵,可以选择相互正交的单位特征向量;特征值非负,对应这些方向上的方差。
如果 C 的特征值为 9 和 1,保留最大特征值对应的方向,就保留了 9/(9+1)=90% 的总方差。这个比例是重构意义上的信息摘要,不能读成“保留了 90% 的分类能力”。方差不包含标签,某个低方差方向依然可能对少数类识别非常重要。
也不要把所有方阵都当作协方差矩阵。一般方阵可能没有足够的实特征向量,特征值也未必非负。本课主要利用实对称矩阵的清晰几何结构;更一般的分解条件与复数情形留到后续。面对实际数据矩阵,下一步还会看到适用于长方形矩阵的 SVD。
3 正交、投影与降维的几何图像
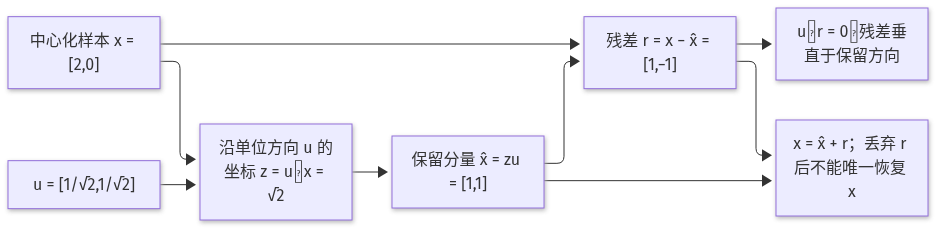
2 个向量的内积为 0,就称它们正交。在二维图上,这对应垂直方向。若单位向量 u 描述某个坐标轴,样本 x 在这个方向上的坐标为 z=uᵀx,投影回原空间得到 x̂=zu。这里 z 是数值坐标,x̂ 是原空间中的向量,不能混为同一种对象。PCA 处理中,x 通常指减去训练均值后的样本。
取 u=[1/√2,1/√2],x=[2,0],则 z=√2,投影点为 [1,1],残差为 [1,-1]。残差与 u 的内积为 0,说明从原点看,样本被分成沿保留方向和垂直方向的 2 部分。投影点是该直线上离样本最近的点,这正是正交投影用于近似的原因。
保留 k 个相互正交的单位方向,把它们作为矩阵 Q 的列,就有低维坐标 z=Qᵀx,重构为 x̂=Qz。由于 QᵀQ=I,坐标不会因基向量彼此重叠而重复计算。若 x 是原始样本,应先减训练均值 μ;重构回原始单位时,再把 μ 加回来。如果还做了标准化,还要逆转相应尺度。
投影会丢失信息。2 个不同的点可能投影到相同位置,降维后无法唯一恢复原样本。PCA 的选择依据是:在固定保留维数时,让训练集的平方重构误差尽量小。对于中心化数据,这等价于选择方差最大的正交方向。它不是保证每个样本误差都小,也不保证保留局部邻居或类别边界。
以图像为例,重构能恢复整体轮廓,但鞋带、袖口等细节可能模糊。整体像素误差下降,不一定意味着衬衫和外套更容易区分。以短文本为例,共现词形成的主方向可能反映文本长度或高频表达,较少出现却很有判别力的词可能被削弱。任务不同,应该接受的投影损失也不同。
中心化后的训练点云均值位于原点,PCA 的方向才描述围绕均值的变化。如果直接在未中心化的数据上求某些低秩表示,主方向可能主要指向整体均值。对于高维稀疏文本,显式中心化还可能破坏稀疏性,因此常用不中心化的截断 SVD;它与中心化 PCA 的解释需要区分。
还可以用“投影两次是否改变结果”检查实现。记 P=QQᵀ,则 P²=Q(QᵀQ)Qᵀ=P,而且 Pᵀ=P。样本已经落在保留子空间中,再投影不会继续移动。对于残差 r=x−Px,应有 Qᵀr 接近零;同时,原向量的平方长度等于投影与残差的平方长度之和。实际计算允许浮点误差,可比较残差内积相对于样本长度的大小。若偏差明显,先检查方向是否归一化、矩阵是否转置正确,以及中心化是否前后一致。
正交条件不能省略。例如把 a=[1,0] 和 b=[1,1] 直接作为 2 个方向,对 x=[0,1] 分别算内积再相加,会得到 0a+1b=[1,1],并没有恢复 x。虽然这 2 个方向张成整个二维平面,却因为彼此不正交而重复计入分量。若先把 b 减去它在 a 上的投影,再归一化,就得到 [0,1],此时才可使用前面的坐标公式。机器学习中拼接来自不同来源的表示,不会自动得到正交基;不能把任意特征矩阵都代入 QQᵀ 并称为正交投影。
投影残差也可以用于理解异常检测的边界。设正常图像的中心化表示主要沿 u=[1,0] 变化,则样本 [2,0.1] 的平方残差为 0.01,而 [2,3] 的平方残差为 9,后者包含明显的新方向。但 [20,0] 的残差仍为 0,它沿已保留方向远离正常样本,也可能异常。因此,基于 PCA 的检测应区分“偏离子空间”和“在子空间内过远”。前者看重构残差,后者可按训练投影坐标的尺度衡量距离;尺度接近零的方向不能直接做除法。检测阈值应在独立验证样本上按允许误报率选择,并复核图像噪声、亮度变化与真实异常,不能把所有大残差都当作异常标签。
4 SVD 概览:稳定分解与低秩近似
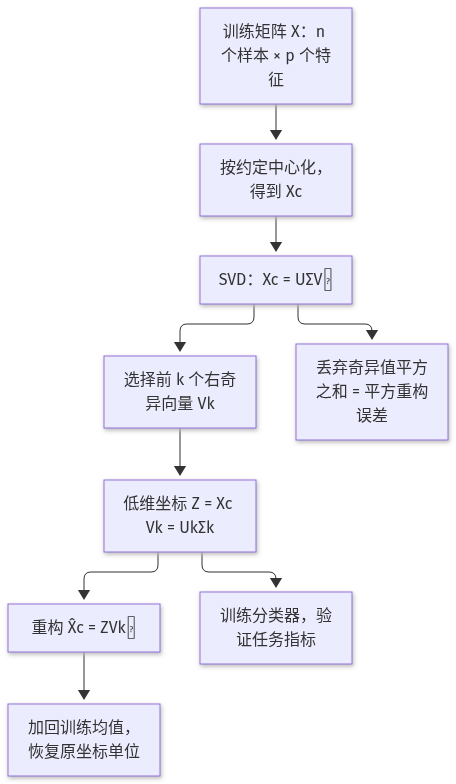
现实数据矩阵往往是长方形。n 个样本、p 个特征组成 X,n 与 p 不必相等,不能直接对 X 使用方阵的特征分解定义。奇异值分解 SVD 把实矩阵写成 X=UΣVᵀ。可以先把它理解成 3 个动作:在输入空间换到正交坐标,沿对应方向缩放,再在输出空间换到正交坐标。
Σ 的对角线上是非负奇异值,通常按从大到小排序。V 的列是特征空间中的方向,U 的列描述这些方向在样本空间中的对应关系。符号和矩阵尺寸会随完整或精简表示变化,但核心关系不变:较大的奇异值对应数据中较强的变化模式,接近 0 的奇异值提示某些方向几乎没有独立变化。
仅保留前 k 个奇异值及对应列,可以得到 Xk=UkΣkVkᵀ。它的秩至多为 k。在相同秩上,这种截断近似能使矩阵的平方重构误差最小。每丢弃 1 个方向,就少存储相应模式,同时引入对应奇异值平方的误差;因此压缩与失真之间存在明确联系。
对于中心化的 Xc,PCA 方向可以由它的右奇异向量得到,协方差特征值为 σ²/(n−1)。实际实现通常可以直接对 Xc 求 SVD,不必先显式构造 XcᵀXc。后者会把奇异值的比例平方,可能加重数值问题。这里只需要掌握选择稳定库函数的理由,不必进入迭代算法和浮点误差传播的内部推导。
在 Fashion-MNIST 上,可以比较保留 32、64、128 个方向后的逻辑回归模型,记录验证集宏平均 F1、各类召回率、投影耗时和表示大小。原始像素模型也必须作为基线。如果压缩后更快但某类召回率明显下降,应把代价呈现出来,而不能仅凭“解释方差达到 95%”宣布成功。
下面的滑块使用明确给定的演示奇异值,帮助观察保留维数与重构误差的关系。它不是公开数据集的实验报告,也不会自动生成真实分类分数。真实选择必须回到固定划分、相同评估口径的实验中,检查少数类表现以及未来数据的变化。
5 动手:小矩阵特征值与投影计算
从能手算的矩阵开始。令 C=[[2,1],[1,2]],特征值满足 det(C−λI)=0,即 (2−λ)²−1=0,所以 λ 为 3 和 1。把 λ=3 代回方程,可得方向 [1,1];把 λ=1 代回,可得方向 [1,-1]。分别除以 √2 后得到单位方向 u 和 v,它们的内积为 0。
假定这个 C 是训练数据的协方差矩阵,保留 u 时,解释方差比例为 3/(3+1)=75%。对于中心化样本 x=[3,1],低维坐标 z=uᵀx=2√2,重构 x̂=[2,2]。残差为 [1,-1],平方长度为 2。保留 2 个方向时,能精确重构这个二维样本;只保留 1 个方向时,另 1 个坐标的信息就丢失了。
再看中心化如何落地。训练样本为 [1,1]、[2,2]、[3,3],训练均值为 [2,2],中心化后为 [-1,-1]、[0,0]、[1,1]。样本协方差为 [[1,1],[1,1]],特征值为 2 和 0。这 3 个点本来就在直线上,保留沿 [1,1] 的方向即可无损表达训练点云;这里的无损结论只针对这些点。
若验证样本是 [4,2],必须减去训练均值,得到 [2,0],不能根据验证集重新计算均值。它投影到上述方向后得到 [1,1],加回均值重构为 [3,3],平方重构误差为 2。这个例子说明,训练集落在直线上不代表未来样本也一样;新的垂直变化会直接表现为重构残差。
可以把实现写成以下伪代码。每个 fit 都只接收训练数据,验证与测试仅使用 transform;这里的 k 必须先由验证过程确定,不能根据测试结果反复更换。
train, val, test = split_by_declared_rule(data)
scaler.fit(train.features)
Xtr = scaler.transform(train.features)
Xva = scaler.transform(val.features)
pca.fit(Xtr, components=k)
Ztr = pca.transform(Xtr)
Zva = pca.transform(Xva)
classifier.fit(Ztr, train.labels)
evaluate(classifier, Zva, val.labels)
如果使用交叉验证,均值、标准差、编码器、PCA 和分类器都应在每个训练折内拟合。先在完整数据上做 PCA 再交叉验证,会让验证折参与方向选择。即使没有使用标签,也泄露了验证数据分布;样本量较小或分布不均时,这种影响尤其容易误导模型选择。
6 条件数与数值稳定的信号
线性代数不只关心精确公式,还关心输入轻微变化时结果是否可靠。对可逆矩阵 A,在常用的 2 范数下,条件数 κ(A)=σmax/σmin。最大与最小奇异值接近时,各方向的缩放比较均衡;最小奇异值接近 0 时,某些方向被压得很扁,逆向恢复会放大这些方向上的误差。
例如 A=diag(1,0.001),条件数为 1000。求解 Ax=b 时,b 的第 2 个分量若从 0.001 变成 0.0011,对应解会从 1 变成 1.1。输入的绝对改动只有 0.0001,解在该坐标上却改变了 0.1。条件数刻画最坏方向的敏感程度,不表示每个输入、每次求解都一定达到同样的放大倍数。
当矩阵奇异时,最小奇异值为 0,普通逆不存在,条件数可视为无穷大。重复列、由其他列精确相加得到的列,都可能造成秩不足。表格数据中,同时保留累计费用、月费用和入网月数可能形成强相关结构,但未必是精确线性关系;应根据实际数据检查,不能凭业务直觉直接断定矩阵奇异。
最小二乘拟合中,高度相关的特征可能让系数对样本扰动敏感。更换少量训练样本后,某些系数会变大、变小甚至反号,而预测结果变化有限。这提示单独解释系数要谨慎。检查奇异值、重复特征、单位差异和重采样后的系数变化,比只看训练误差更能发现问题。
处理办法取决于原因。单位相差悬殊时,先合理标准化;重复编码时,修正特征设计;存在真实相关性时,可以比较降维或正则化方案。求解线性问题时优先使用成熟库的 solve、最小二乘或 SVD 接口,避免为求解 Ax=b 显式计算 A 的逆。正则化的优化细节留待后续,本课只认识它能约束不稳定方向。
标准化也不是万能修复。把 2 列完全相同的特征分别标准化,它们仍然相同;遇到近乎常数的特征,还应检查尺度估计是否合理。条件数也必须注明针对哪个矩阵、采用什么缩放和范数。不能把原始特征矩阵、协方差矩阵与模型中的其他矩阵的条件数混写成同一个诊断结果。
7 常见坑:把主成分当因果、忽略尺度
主成分是相关结构的摘要,不是因果因素。某个方向同时包含高月费用和短入网时间,最多说明这些特征在当前训练样本中怎样共同变化。不能据此推出“提高费用会导致流失”,更不能把干预建议直接建立在主成分载荷上。因果结论需要额外假设、研究设计和证据,本课的矩阵分解不提供这些条件。
载荷是方向在原特征轴上的系数。它可以帮助解释方向,却受中心化、尺度、编码与样本选择影响。如果 2 个特征值非常接近,小幅数据扰动就可能让对应方向在共同子空间内转动。此时应谨慎命名某个单独主成分,必要时解释整个子空间,避免把不稳定的系数包装成固定业务规律。
忽略单位会让大数值特征占据方差。以米记录距离与以毫米记录同样距离,不应自动改变任务结论,但未经缩放的 PCA 可能给出不同方向。是否标准化取决于目标:希望每个特征按自身变化尺度参与比较时,可用训练均值和标准差处理;若绝对能量本来就是目标,也可以保留原尺度,并明确理由。
标准化不能纠正标签泄漏。若表格里包含“取消服务日期”或在预测时尚未产生的累计信息,模型可能获得不现实的高分。PCA 把这些列混进新坐标之后,泄漏反而更难从单列名称识别。应在投影前审查特征的可获得时间,而不是期待降维自动清除不合规的信息。
类别不平衡也会误导判断。假设测试样本中正类占 10%,全部预测为负类就有 90% 准确率,但正类召回率为 0。精确率 precision 衡量预测为正的样本中有多少是真的,召回率 recall 衡量真实正类找回多少,F1 综合这 2 者。比较压缩方案时,要固定或在验证集选择阈值,并报告各类支持样本数。
ROC-AUC 衡量正样本排序高于负样本的能力,不能替代业务阈值下的 precision 与 recall;少数类很少时,还可补充 PR-AUC。数据分布发生变化后,原来的均值、方向和阈值可能失效。应比较新旧数据的特征分布、投影坐标和重构残差,再结合带标签的任务指标判断,不能把残差变大直接解释成分类一定失败。
8 案例:未标准化就做 PCA 的误导
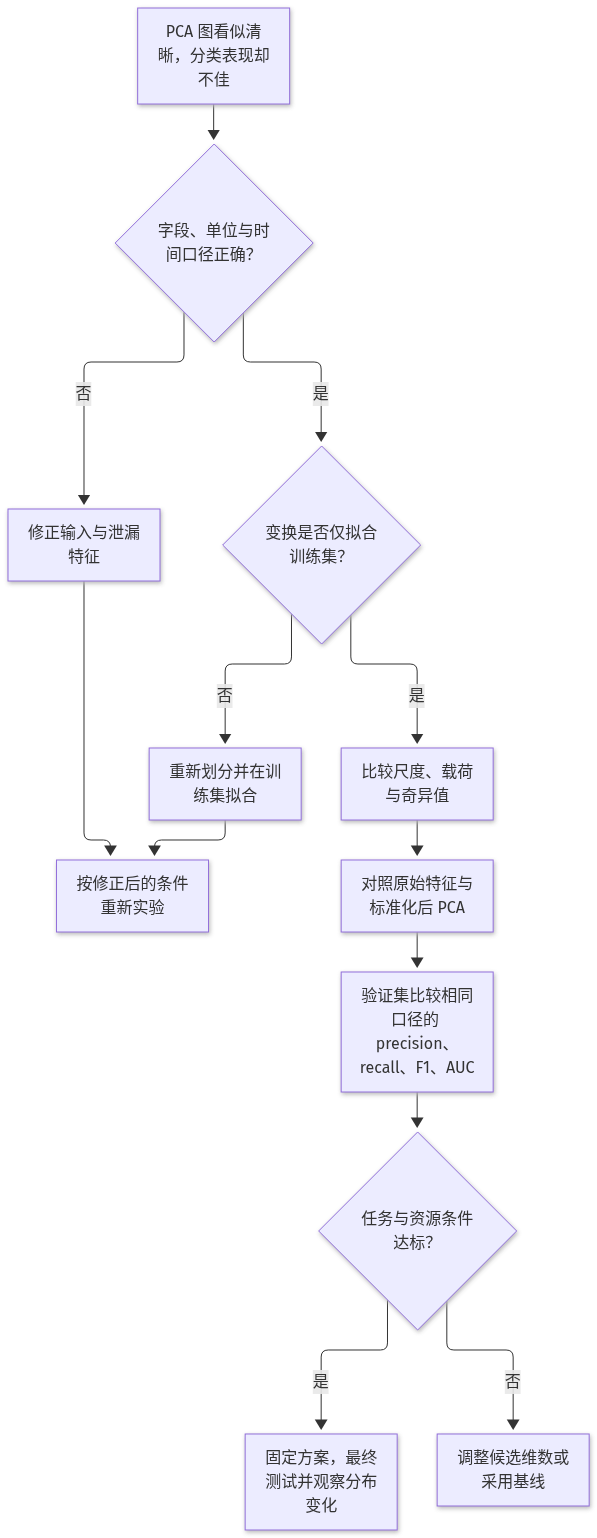
回到客户流失任务。选择入网月数、月费用和累计费用 3 个数值特征,目标是在同样的分类器下比较是否降维。累计费用的数值跨度通常比月费用大,且与入网月数有关。如果直接中心化后做 PCA,首个方向可能主要追随累计费用变化,图上看起来结构清晰,却不一定突出流失差异。
先明确时间口径:特征必须来自预测时点之前,标签表示之后约定窗口内是否流失。公开快照数据若不能支持这种时间定义,就把实验限制为该快照的分类练习,不宣称已经验证线上提前预警。清理缺失值、确认每行含义后,固定分层的 70%、15%、15% 划分;多记录客户则采用分组划分。
建立 3 个候选流程。流程 A 为训练集标准化后直接训练逻辑回归,作为基线;流程 B 为仅中心化、保留 2 个主成分后训练同类分类器;流程 C 为先标准化、再保留 2 个主成分。每个流程的填补、缩放和分解都只拟合训练集,分类器使用一致的调参范围与验证规则,避免给某个方案额外试验机会。
先观察几何证据:流程 B 的载荷是否主要指向累计费用,流程 C 的方向是否更均衡;同时记录解释方差比例和按各自尺度计算的重构误差。不同尺度下的重构误差不能直接当作同一单位比较。再看任务证据:验证集 F1、ROC-AUC、正类 precision、recall,以及相同最低精确率要求下能达到的召回率。
为练习读数,假设在同 100 个验证样本、20 个真实流失客户中,某阈值使流程 B 得到 TP=8、FP=4、FN=12、TN=76;流程 C 得到 TP=14、FP=6、FN=6、TN=74。B 的 precision 约为 0.67,recall 为 0.40,F1 为 0.50;C 分别为 0.70、0.70、0.70。这是教学假设数据,不是对公开数据集跑出的结果。
这些计数表明,在给定样本和阈值下,流程 C 找回了更多流失客户;它们不能直接给出 AUC,也不能证明标准化必然改善所有任务。还要与流程 A 比较,检查不同划分下结论是否稳定。方案选定后,仅做最终测试评估;上线后再用新时间窗口检查表现,特别关注费用结构变化与客户群变化。
9 把几何检查写进模型前置条件
几何检查应当成为数据进入模型前可以执行的条件。首先写清输入契约:每列是什么、单位是什么、何时可获得、缺失如何表示,是否存在重复客户和重复特征。检查常数列、近乎常数列、异常量级与明显重复编码。若这些基础信息不明,分解出的方向再漂亮也难以解释。
然后固定拟合边界。保存训练集版本、划分规则、训练均值、标准差、保留方向和特征顺序;推理时必须按同一顺序复用这些参数。列顺序错位可能让维数完全正确,却把月费用放进入网月数的位置。维数检查只能发现形状错误,还需以字段名称、类型和合理取值范围共同保护变换。
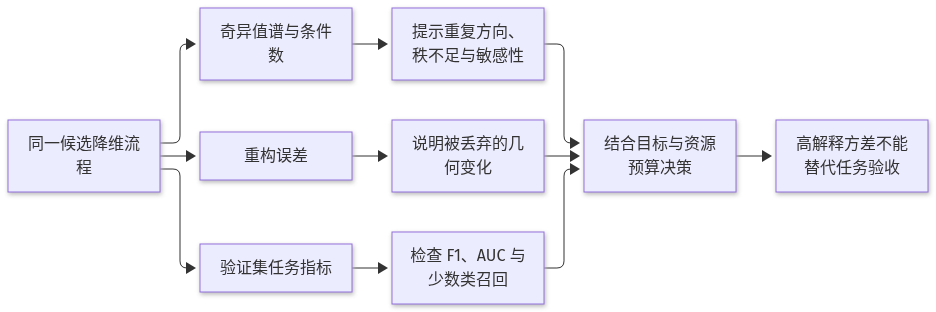
记录为什么需要降维。若目标是减少延迟,就同时测量变换自身的耗时和分类器的耗时;若目标是节省表示空间,就记录维数、数值类型和样本量;若目标是缓解相关性,就检查奇异值谱和重采样稳定性。只有能与目标对应的证据,才支持把 PCA 或 SVD 加进正式流程。
验收条件应有基线和容许退化范围。例如预先约定:在满足正类 precision 不低于某个业务阈值时,比较 recall,并记录宏平均 F1 与推理耗时。具体阈值由误报和漏报成本决定,不照搬教材数字。解释方差可以辅助筛选候选维数,但最终维数由验证集上的任务与资源约束共同决定。
还要为新数据准备观察窗口。投影坐标分布偏移,可能表示输入群体变化;重构残差升高,可能表示新方向出现;分类指标下降,则说明任务效果受损。这些信号有关联却不等价。发现异常后先核对字段、单位、缺失率和数据版本,再判断是否需要重训,不能在没有诊断的情况下自动更换方向。
对于图像,可以按类别观察重构与误判,防止总体误差掩盖某类细节丢失;对于短文本,可以检查新词比例、文本长度和稀疏度,防止把主题变化误当成模型随机波动。几何语言提供共同检查框架,具体证据仍应来自任务。把这些前置条件写清楚,后续讨论梯度和优化时才知道模型实际接收了怎样的坐标。
放进方案里
在方案中增加“特征空间与降维依据”段落,先说明任务、预测时点和样本单位。例如客户流失分类以客户为单位,输入为预测时点前可用的入网月数、月费用与合同类型,标签窗口另行定义。写明数据版本和训练、验证、测试划分;同客户记录不跨集合,时间任务按时间划分,所有变换参数仅由训练集估计。
再写坐标约定:哪些列中心化或标准化、类别如何编码、缺失如何填补,以及这些处理为何适合目标。若采用 PCA,说明候选保留维数、解释方差和重构误差的计算尺度;若采用截断 SVD,说明是否中心化及其对解释的影响。保留原始特征基线,避免把使用分解本身写成收益。
验收部分将几何证据与任务证据并列。记录主要奇异值、近零方向、载荷稳定性,并用验证集选择维数和分类阈值。按相同样本和口径报告 precision、recall、F1、ROC-AUC,类别不平衡时补充 PR-AUC;同时记录推理耗时和表示大小。所有收益均来自实际实验,教学示意数字不进入结论。
交付物包括带特征顺序的变换参数、分类器版本、划分规则和实验记录。测试集只在方案固定后用于最终评估。上线观察字段范围、缺失率、投影坐标与重构残差,并在标签到达后复核任务表现。若发现分布变化,先检查单位、编码与采集流程,再决定重训或恢复基线。
最后明确结论边界:主成分反映当前样本的变化结构,不证明因果;高解释方差不保证高召回;标准化不能消除泄漏。方案只有同时满足预先约定的任务表现、资源预算和数据可用性条件,才采用该降维流程,并记录不满足条件时的处理责任与复核方式。
10 小结:下一步微积分与梯度(A6)
特征向量描述变换下保持直线方向的向量,特征值描述对应伸缩;正交投影把样本拆成保留分量与残差;SVD 为长方形矩阵提供低秩近似,条件数提醒我们关注误差放大。把这些概念用于机器学习时,始终同时检查数据边界、几何损失和任务指标。
可以自测:为什么特征向量整体反号不改变投影重构?为什么保留 95% 方差仍可能漏掉少数类?为什么验证数据只能使用训练均值?为什么重复列标准化后仍可能秩不足?若能结合例子说明理由,就具备了继续学习的基础。
A6 将讨论函数如何随输入变化,以及梯度如何指示局部变化方向。线性代数提供坐标、方向和变换的语言,微积分进一步描述损失沿这些方向怎样变化;优化算法的内部细节将在相应课程逐步展开。