把用户是否流失、图片属于哪类、短文本表达什么意图放在同张工作台上,它们看起来很不相同。机器学习却常把它们改写成相似的问题:用向量描述样本,把向量排成矩阵,再对矩阵执行可以重复计算的运算。本课从这个共同入口出发,学习向量、矩阵、点积、线性组合、转置与缩放,并把这些概念接到真实数据的训练、验证和诊断上。
1 为什么机器学习要先补线性代数
假设你要预测订阅用户在未来 30 天是否流失。手头有过去 30 天的活跃天数、最近 7 天的会话次数、账号使用月数,还有是否流失的历史结果。每个用户可以写成包含 3 个数的向量,例如 [12, 8, 6]。这里的顺序有业务含义:第 1 个位置始终表示活跃天数。把顺序换了,即使数字没有变化,模型读到的也已经是另种事实。线性代数让我们准确讨论这种“数字按什么方式组织”的问题。
图片也能放进这个框架。把灰度图片的像素按固定顺序展开,就得到像素向量;把短文本转换成词频,也能得到向量。变化的是每个位置代表什么,保留下来的是按坐标运算的规则。入门阶段不必先理解复杂神经网络,也能检查样本数量、特征数量、权重数量是否匹配,能解释为什么把 1 列误当成 1 行会算出完全不同的东西。
更重要的是,算对矩阵不等于做对预测。流失模型如果用到了用户注销之后才产生的退款记录,向量和矩阵运算可能全部正确,评估结果仍然不可信。若图片训练集来自明亮实验室,测试集来自昏暗手机拍摄,矩阵尺寸也不会提醒你分布发生了变化。因此,本课始终同时保留 2 条线:数学上这个运算代表什么,数据上这些数在什么时候、以什么方式可获得。
本课使用 scikit-learn 提供的 Wisconsin Diagnostic Breast Cancer 公开数据做小实验。它包含 569 个样本、30 个由细胞核图像计算出的数值特征,原始标签分为良性与恶性。我们只取 3 个特征,便于看清每个坐标和权重之间的关系。实验用于理解数据表示与评估,不把所得结果解释成临床有效性。相同的计算方法可以迁移到流失表格、图片分类和短文本分类,数据边界则需要分别重新确认。
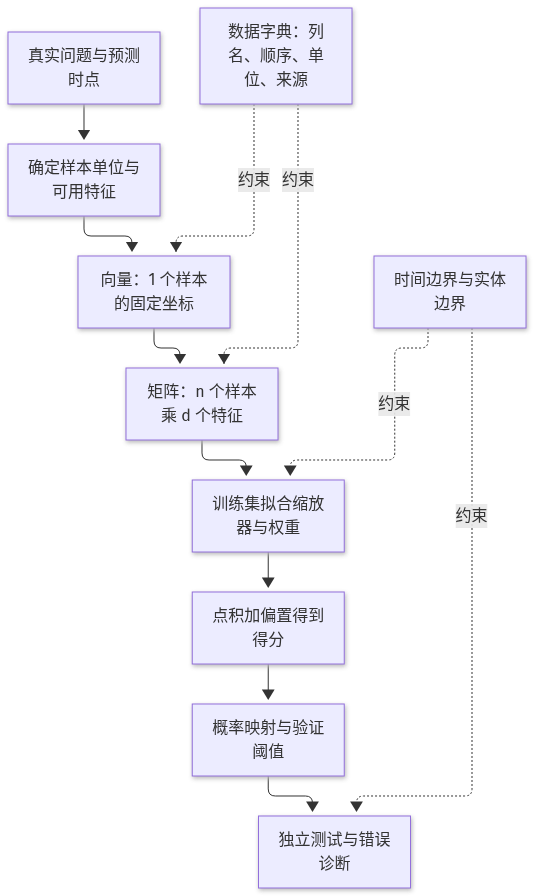
读完本课,你应当能把“模型给出了较高分数”展开为可检查的解释:输入有多少行、每行是什么、各列单位是什么、如何计算得分、阈值从哪里来,以及用哪份数据证明它有效。这种表达能力比记住几个矩阵符号更早派上用场,因为后续的模型和工具都会依赖这些约定。
2 向量、矩阵与形状约定
先定义预测单位,再开始组装矩阵。流失任务的样本可以是“用户在某个周末的状态”,标签是接下来 30 天是否流失;图片任务的样本通常是图片,但若同个物体有多张近似照片,就不能假装这些图片完全独立;文本任务的样本可以是消息,也可能是整个会话。预测单位决定了哪些行可以分到不同集合,不能只由文件里每行的样子决定。
在本课实验中,每行对应数据集提供的 1 个样本,选取的列依次为平均半径、平均纹理、平均平滑度,对应特征名 mean radius、mean texture、mean smoothness。它们的数值范围不同,不能把数值大小直接当成重要程度。我们把恶性定义为正类并记作 y=1,把良性记作 y=0。原始接口把恶性编码为 0,因此代码显式转换标签,避免后面报告的召回率指向了错误类别。
特征矩阵记作 X,标签向量记作 y。如果有 n 个样本、d 个特征,就写 X ∈ R^(n×d)、y ∈ {0,1}^n。这里的 R 表示实数,括号里的尺寸表示行数和列数。标签单独保存,不能因为它也是数字就混进特征矩阵。样本编号、数据来源、采集时间也应保留在旁边,用于分组与排查,而不是不经判断就作为模型输入。
我们用固定随机种子进行分层划分:训练集 341 行、验证集 114 行、测试集 114 行,大致对应 60%、20%、20%。分层表示让各集合的正负类比例尽量接近,避免小集合偶然缺少某类。训练集负责估计缩放参数和模型权重;验证集负责选择分类阈值;测试集在流程冻结后评估。固定种子让别人能复现这次划分,但不能证明这次划分代表所有未来场景。
随机划分适用于本课演示,实际任务还要考虑时间和重复实体。流失预测通常应使用较早时间训练、较晚时间验证和测试,并让特征窗口早于预测时点。图片若来自相同患者或相同拍摄对象,应按对应实体分组。短文本若存在转发、引用或模板副本,也需要处理跨集合重复。分层只能控制类别比例,不能自动解决这些边界问题。
写下数据字典是非常实用的起点:记录列名、顺序、单位、取值范围、缺失处理、可获得时间和标签含义。如果某列只有在结局发生后才能获得,就算它能明显提升 AUC,也不应进入预测输入。线性代数提供了整齐的容器,数据字典决定容器里放的东西是否符合问题本身。
3 点积、矩阵乘法、转置与可结合性边界
向量可以理解为具有固定坐标含义的数列。对样本向量 x=[x1,x2,x3],我们既关心数值,也关心坐标约定。向量加法按位置进行,例如 [1,2,3]+[2,0,1]=[3,2,4];标量乘法把每个位置乘以相同的数,例如 2×[1,2,3]=[2,4,6]。这些运算要求对应位置可以相互解释。把以厘米表示的半径与以毫米表示的半径直接相加,会得到形式上可算、语义上混乱的结果。
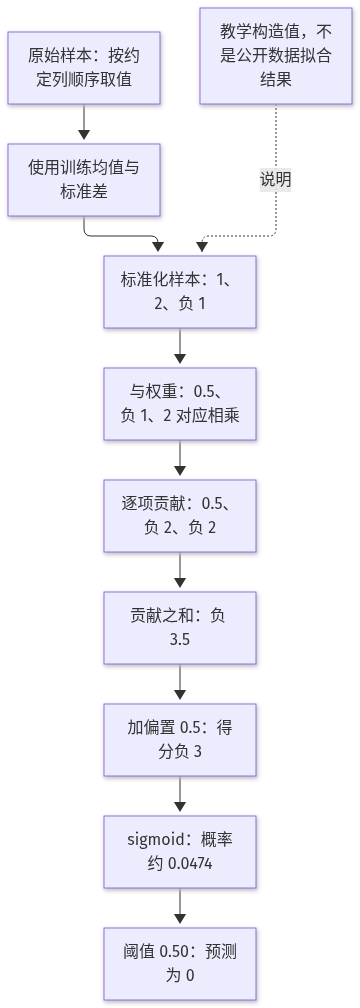
点积把 2 个长度相同的向量压成 1 个数:x·w=x1w1+x2w2+x3w3。若 x=[1,2,-1],权重 w=[0.5,-1,2],则点积为 0.5-2-2=-3.5。再加上偏置 b=0.5,得到线性得分 z=-3。这不是概率,也不是最终类别。它只是把不同特征的贡献相加后得到的有方向数值,通常还需要概率映射和分类阈值。
权重符号表示在其他输入固定时,增加某个特征会让得分向哪个方向移动。正权重把得分推高,负权重把得分压低。但特征可能相关,数据里也未必存在“只改变某列、其他列完全不变”的真实样本。因此,权重可以帮助描述模型怎样算,不能独自证明现实中的因果关系。半径权重较大,不等于人为改变半径就会按同样幅度改变某种结局。
把多个样本排成矩阵后,Xw+b 就能同时算出所有样本的得分。这里 X 的尺寸为 n×d,w 的长度为 d,结果长度为 n;同个偏置加到每行结果上。矩阵乘法的核心规则是内侧尺寸必须相同。若 A 是 m×k,B 是 k×p,乘积就是 m×p。每个输出元素都是左侧的某行与右侧的某列做点积,绝不是对应位置简单相乘。
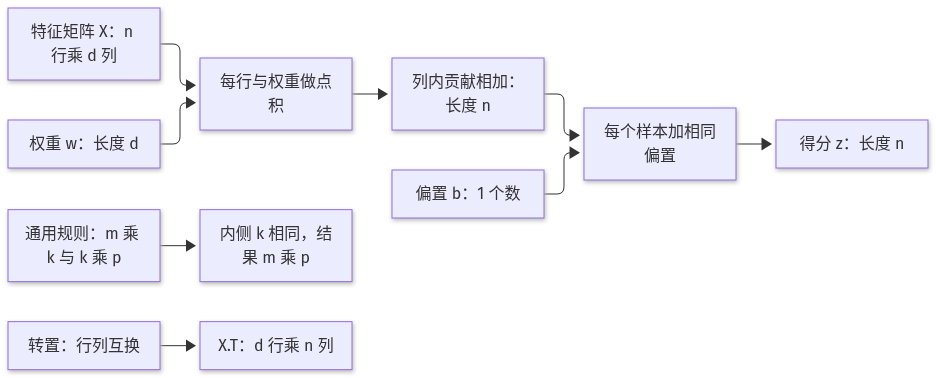
转置用 X.T 表示,它把行列互换,把 n×d 变成 d×n。这有助于表达不同的聚合方向,却不会替你更改数据的含义。看到报错就随意加转置,可能让尺寸碰巧匹配,却把“每个样本的得分”变成“每个特征的汇总”。同理,X*w 常表示逐元素乘法,会保留每个特征的贡献;X@w 才把这些贡献沿特征方向加起来。
线性组合是“把几个向量分别乘以系数后相加”。从列的角度看,Xw 是特征列的线性组合;从行的角度看,它是每个样本与权重做点积。两种描述对应同个计算。前者适合看哪些特征在组合,后者适合检查某个样本为什么得分偏高。这个双重视角以后在理解图像通道、词频特征以及模型输出时都会再次出现。
向量长度也能帮助形成直觉。欧氏长度是各坐标平方相加后开平方,距离则是差向量的长度。但如果某列量级大很多,它就容易主导距离。例如金额以元计数、账号年龄以年计数,直接算距离会让金额差异占据绝大部分结果。缩放因此会改变几何关系。它既是数值处理,也是关于“怎样比较不同坐标”的选择。
接下来用标准化连接几何与模型:对第 j 列,用训练集均值 μj 和标准差 sj 计算 x'j=(xj-μj)/sj。标准化之后的 1 表示高于训练均值约 1 个标准差,不表示原始测量值为 1。它是逐列平移和缩放;加上平移后整体属于仿射变换,本课只需理解计算效果。它不会消除离群点、修复错误单位,也不会保证不同群体遵循相同分布。
4 线性变换:从特征空间到预测得分
这个实验的问题是:只给定所选的 3 个测量特征,能否给恶性样本较高分数,并用透明的阈值规则形成分类结果?我们使用逻辑回归作为入门模型。它先计算 z=x'·w+b,再用 p=1/(1+exp(-z)) 把得分映射到 0 与 1 之间。映射保持大小顺序:得分越高,输出越高。这个形式能让点积直接连接到分类,而不必先展开优化算法的内部推导。
称输出为预测概率,并不代表它已经具有可靠的概率含义。若模型对很多样本给出 0.8,这些样本中是否大约有 80% 为正类,需要额外观察校准。入门实验先关注排序和分类表现,并保留这个限制。模型输出也不能解释成对疾病机制的结论;它描述的是给定数据与建模流程中学到的统计关联。
缩放器在训练集上计算均值与标准差,模型也只在训练集上学习权重。验证和测试样本都使用训练得到的同组缩放参数。这样,验证集才能模拟“面对以前没见过的数据”的过程。如果先用全体数据计算均值,再划分集合,验证与测试分布的信息已经进入了流程。即使没有直接使用标签,这也违反了预先约定的数据边界。
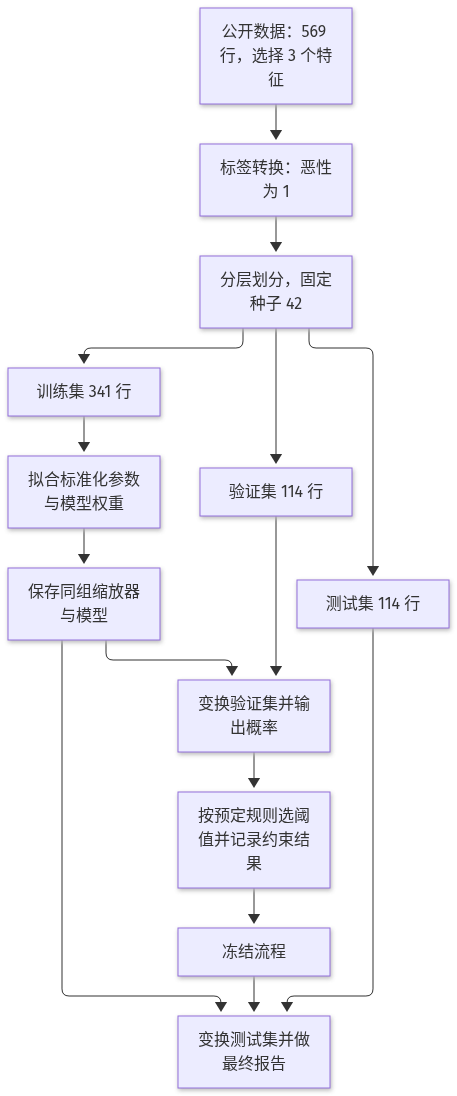
我们在验证集上比较 0.10、0.15、…、0.90 这些候选阈值。示例规则是先要求正类召回率达到 0.90,再从满足条件的候选中选择 F1 最高者,并在 F1 相同时选择较高阈值。如果没有候选满足要求,记录“验证约束未满足”,只把 0.50 作为演示回退值。回退并不表示目标已经达成,更不能隐去失败后继续宣称方案合格。
这条规则体现了需求如何进入运算:漏掉正类的代价较高,所以先约束召回,再看精确率与召回之间的平衡。具体到真实问题,约束应由任务负责人和使用流程决定,不能把这里的 0.90 当成通用标准。若人工复核容量很小,还要统计每个阈值产生多少正类预测,评估复核队列是否超出处理能力。
阈值确定之后,测试集只用于最终报告,不能看到测试结果不满意就换阈值。若继续调参,就相当于让测试集参与开发,需要新的独立评估数据。这也是为什么“代码可重跑”和“评估可相信”是不同要求:前者依靠固定输入与版本,后者依靠边界和选择过程。实验记录应同时保存随机种子、列顺序、软件版本、划分索引和阈值选择规则。
5 动手:小矩阵手算并对齐 NumPy / 模型输入
下面代码使用 NumPy 和 scikit-learn,数据由安装包自带加载器提供,无需额外下载数据文件。将整段作为脚本执行,或按阶段放进笔记本。输出指标以实际运行结果为准;本课没有预先填入某个看起来漂亮的成绩。先观察形状和标签方向,再看分类指标,最后核对手工点积能否重现模型输出。
import numpy as np
import sklearn
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (
    precision_score, recall_score, f1_score,
    roc_auc_score, confusion_matrix,
)

data = load_breast_cancer()
cols = [0, 1, 4]
X = data.data[:, cols]
y = (data.target == 0).astype(int)  # 恶性是正类
ids = np.arange(len(y))

dev_ids, test_ids = train_test_split(
    ids, test_size=0.20, stratify=y, random_state=42
)
train_ids, val_ids = train_test_split(
    dev_ids, test_size=0.25, stratify=y[dev_ids],
    random_state=42,
)
X_train, X_val, X_test = X[train_ids], X[val_ids], X[test_ids]
y_train, y_val, y_test = y[train_ids], y[val_ids], y[test_ids]
print("versions:", np.__version__, sklearn.__version__)
print("columns:", data.feature_names[cols])
print("shapes:", X_train.shape, X_val.shape, X_test.shape)
print("positive counts:", y_train.sum(), y_val.sum(), y_test.sum())

pipe = make_pipeline(
    StandardScaler(),
    LogisticRegression(C=1.0, solver="lbfgs", max_iter=2000),
)
pipe.fit(X_train, y_train)
assert np.array_equal(pipe.classes_, [0, 1])
p_val = pipe.predict_proba(X_val)[:, 1]

candidates = []
for threshold in np.linspace(0.10, 0.90, 17):
    pred = (p_val >= threshold).astype(int)
    recall = recall_score(y_val, pred, zero_division=0)
    f1 = f1_score(y_val, pred, zero_division=0)
    if recall >= 0.90:
        candidates.append((f1, threshold))
constraint_met = bool(candidates)
threshold = float(max(candidates)[1]) if candidates else 0.50
print("validation constraint met:", constraint_met)
print("frozen threshold:", threshold)

# 核对:逐行点积应重现模型的线性得分与概率。
scaler = pipe.named_steps["standardscaler"]
model = pipe.named_steps["logisticregression"]
X_val_scaled = scaler.transform(X_val)
w, b = model.coef_[0], model.intercept_[0]
z = X_val_scaled @ w + b
assert np.allclose(z, pipe.decision_function(X_val))
assert np.allclose(1.0 / (1.0 + np.exp(-z)), p_val)
print("weights and bias:", w, b)
print("first sample contributions:", X_val_scaled[0] * w)

# 阈值冻结后评估测试集;不要据此继续挑阈值。
p_test = pipe.predict_proba(X_test)[:, 1]
test_pred = (p_test >= threshold).astype(int)
print("precision:", precision_score(y_test, test_pred, zero_division=0))
print("recall:", recall_score(y_test, test_pred, zero_division=0))
print("F1:", f1_score(y_test, test_pred, zero_division=0))
print("ROC AUC:", roc_auc_score(y_test, p_test))
print("confusion [[TN, FP], [FN, TP]]:")
print(confusion_matrix(y_test, test_pred, labels=[0, 1]))
训练矩阵应显示为 (341, 3),验证和测试矩阵均为 (114, 3)。权重 w 的形状是 (3,),得分 z 的形状是 (114,)。这里 NumPy 的向量是 1 维数组,没有显式行列方向;本课用每行与权重做点积的语义解释它。若把标签写成 (114, 1) 再与 (114,) 的预测相减,广播可能生成 (114, 114) 的数组。没有报错并不意味着计算符合预期。
检查某个样本时,打印它的原始值、标准化值、逐项贡献和偏置。逐项贡献相加再加偏置,应当等于该样本的 z。如果贡献与预期相反,先确认列顺序和正类编码,而不是立刻判断模型学错。标准化后的负值只表示低于训练均值,并不表示原始测量值为负,也不意味着这个样本必然属于负类。
在探索时可以改变验证阈值并观察结果,但不要反复查看测试指标来选出喜欢的组合。若想练习更换特征,应把原来的测试结果视为已经看过的结果,新的探索只在开发集合内完成。正式比较多个候选方案还需要更严格的评估设计,本课先把单次划分、数据管道和阈值冻结做清楚。
6 从连续得分到指标:阈值、混淆矩阵与 AUC
混淆矩阵把预测与实际交叉起来。真正类 TP 是实际为正且预测为正,假正类 FP 是实际为负却预测为正,假负类 FN 是实际为正却预测为负,真负类 TN 是实际为负且预测为负。先写清正类含义再解释这些数字,否则同个“召回率”可能回答完全相反的问题。代码中的矩阵按真实标签为行、预测标签为列排列。
精确率 precision=TP/(TP+FP) 回答“报出的正类中有多少是真的”,召回率 recall=TP/(TP+FN) 回答“实际正类找回了多少”。F1 是 2PR/(P+R),在精确率和召回率之间做调和汇总。如果没有预测正类,精确率分母为 0;代码用 zero_division=0 给出计算约定,但报告仍应说明“没有报出正类”,不能只留下孤立的 0。
考虑 100 个样本,其中实际正类有 20 个。某个阈值给出 TP=16、FP=8、FN=4、TN=72,精确率约为 0.667,召回率为 0.8,F1 约为 0.727。这些是解释公式的人工计数,不是上面公开数据实验的实测成绩。降低阈值通常会同时接纳更多真阳性和假阳性,因此召回不会下降,精确率却不保证按相同规律变化。
ROC AUC 衡量正负样本的排序区分能力:随机抽取正类和负类时,模型把正类排得更高的程度,并对相同分数计入平局。计算 AUC 应使用连续得分或概率,而不是已经切成 0/1 的类别。它不依赖某个单独阈值,因此改阈值不改变同批样本的 AUC;但它也不能说明选定阈值下会产生多少误报,更不能独自保证概率已经校准。
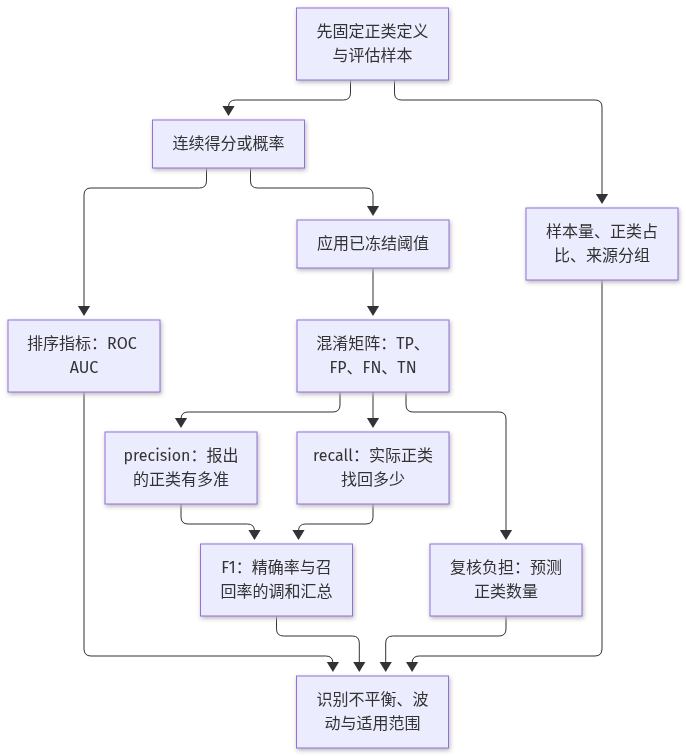
类别不平衡时,准确率特别容易掩盖失败。如果 1000 个用户中只有 20 个流失,全部预测“不流失”仍有 98% 准确率,却找不回任何流失用户。除 precision、recall、F1 和 ROC AUC 外,还应观察正类占比、预测为正的数量,必要时看精确率与召回率曲线。不同数据的类别比例不同,精确率也会变化,不能把不同样本构成下的分数直接当成模型能力排名。
诊断信号还包括训练和验证表现的差距、各特征范围、缺失比例、异常值数量,以及不同来源样本的错误分布。训练表现明显较好,可能意味着模型记住了训练数据,也可能是重复样本或来源偏差造成的。测试集中只有 114 个样本时,少数误判就会明显改变指标,应同时报告样本数和错误计数,避免把小数点后很多位当成稳定性的证据。
7 常见坑:维度对不上、列顺序错乱、训练统计泄漏
最常见的表示错误是列顺序漂移:训练使用“半径、纹理、平滑度”,预测却传入“纹理、半径、平滑度”。形状完全相同,点积也能算,意义却已改变。解决方法是把特征名和顺序写进输入契约,在组装矩阵时按名称取列。类型转换、单位换算和缺失填补也应在契约中表达,不能依靠操作人员记住某份表格的习惯。
另个常见错误是每次预测都重新标准化。单个请求没有足够样本估计自己的均值和标准差;对整个测试批次重新拟合,也会让同个用户的输出依赖它与哪些其他用户碰巧同批出现。正确做法是保存训练得到的缩放器,并在验证、测试和后续预测中调用同个变换。若训练列为常量,通常的标准化实现会避免除以 0,但该列没有样本间差异这件事仍值得记录。
不要把权重绝对值直接排列成跨特征的业务重要性。原始单位不同会改变权重的数值,相关特征可能分担贡献,某列也可能只是另种隐藏因素的代理。标准化后的系数能改善可比性,却不能自动解决相关性和因果解释。对于入门诊断,先用单个样本的贡献解释计算过程,再用数据来源与误判分组解释结果边界。
不要用复制少数类的方式随意“修复”整个数据集,然后才划分集合。相同样本的副本可能同时进入训练与测试,结果像在检查记忆。任何重采样都应限制在训练部分,验证和测试应尽量保留目标使用场景的自然类别比例。阈值调整、类别权重和补充数据各有作用,本课不展开算法细节,但应先明确问题究竟是排序不好、决策阈值不合适,还是样本根本不足。
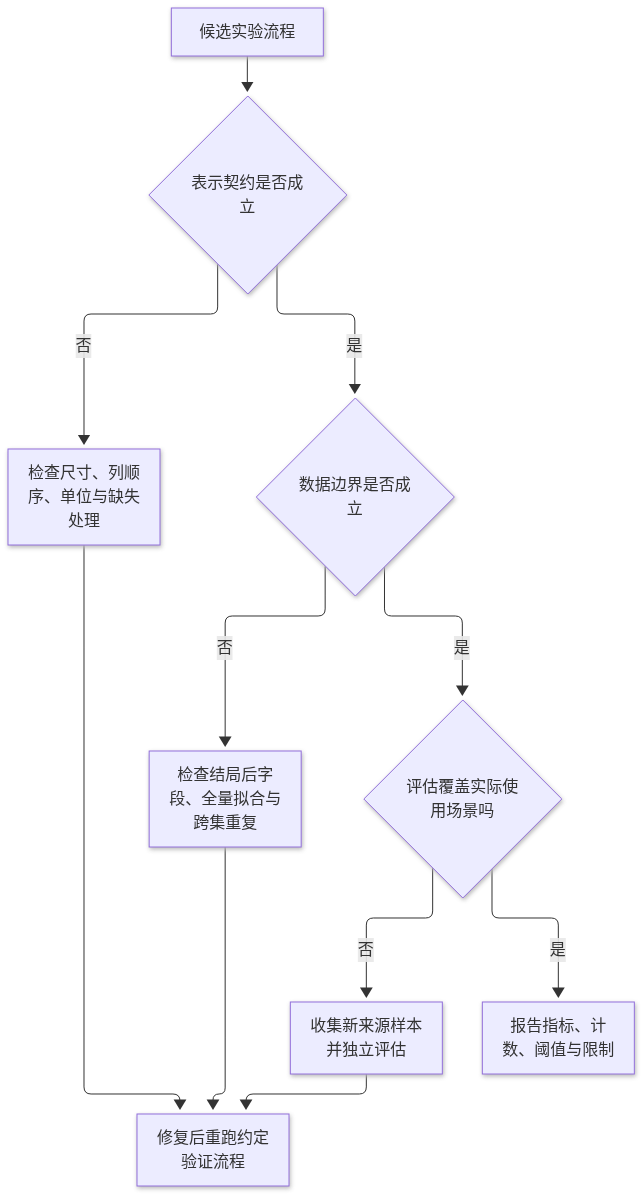
还要警惕把空间展平当成信息保全。把图片展开成向量,确实保留了每个像素数值和约定顺序,却没有让简单线性模型自动理解相邻像素的关系。词频向量保留了各词出现次数,也通常丢失了语序。相同的矩阵接口不意味着不同任务具有相同难度;后续更复杂的模型会处理这些结构,本课先明确表示保留了什么、舍弃了什么。
最后,不要把更多小数位、更多特征或更高训练分数当成可靠性的替代品。新增列可能包含泄漏,新增复杂度可能放大偶然相关,重复调试测试集也可能让测试失去独立性。先把简单基线与证据链做完整,才能知道后面的提升来自有效信息,还是来自实验边界被悄悄改变。
8 案例:特征矩阵乘错导致分数全崩
先在本课公开数据上构造可解释的故障。假设有人把标签转换为“诊断提示分”,例如用 0.1+0.8*y 生成新增列,再把它拼进 X。这列与目标直接对应,模型很容易利用它取得异常优异的区分效果。该操作是人为注入的泄漏演示,并非原始数据集存在这列,也不是已发生的项目事故。它说明矩阵接口不会阻止未来信息或答案本身进入输入。
面对这样的提升,应该追问新增列在预测时是否存在、由谁生成、生成时间是否晚于结局。移除它后表现下降并不说明修复失败,而是让评估重新回答真实问题。对于流失任务,“已经确认的注销原因”就有类似风险:如果预测目标是未来是否流失,这种字段即使来自正式业务系统,也很可能无法在预测时获得。可信的列来源比列名是否专业更重要。
再构造列交换故障:训练完成后,仅在验证输入中交换半径和纹理,仍保持 114×3 的尺寸。不要猜测指标必然下降多少,应比较交换前后的概率、得分和混淆矩阵,并检查送入缩放器之前的列名与单位。若部分样本改变很小,也不能据此接受错误映射;这可能只是数值巧合或模型恰好对相关方向不敏感。输入契约本身已经被违反。
图片分类可以用公开的 Fashion-MNIST 作迁移例子。它把服饰图片组织成固定尺寸的灰度像素,线性模型可以把每张图展成向量作为基线。若后来输入的是手机拍摄、背景复杂、位置偏移的服饰照片,图片类别名称虽然相同,输入分布却发生变化。旧测试集上的高分不能直接证明新场景可用,应单独收集有代表性的标注样本并比较错误类型。
短文本分类则可以参考公开的 20 Newsgroups 数据。若目标是按正文主题分类,邮件头、引用内容、签名或讨论组名称可能提供与目标部署条件不一致的捷径。应明确是否移除 headers、footers、quotes,并在实验记录中固定选择。词表及基于语料计算的特征统计也只能在训练部分拟合。这里讨论的是需要控制的数据条件,不预设移除后指标一定降低多少。
这些案例连接了 3 种不同失败:泄漏让评估过于乐观,列错位让同个模型读错坐标,分布变化让旧证据无法覆盖新场景。它们都可能表现为“预测不准”,但修复路径不同。先区分问题属于数据获得时间、表示契约还是适用范围,再讨论换模型,通常能更快定位原因,也能避免用复杂方法掩盖基础错误。
9 把线性代数检查写进实验清单
线性代数错误很少以“报错:你乘错了”的形式出现;更常见的是形状碰巧能广播、分数仍能产出,但已经不是原来的问题。上线前把下列检查写成实验附件,和指标表放在一起。
- 形状契约:
X为n×d,每行一个样本、每列一个特征;权重w为d维,与列顺序一一对应。交换两列后必须同步交换权重,不能只改矩阵。 - 点积重算:任抽 1 个样本,用保存的缩放参数得到
x',逐项算x'j·wj,加总加偏置,核对与模型连续得分一致。 - 转置与行列:确认没有把
1×d当成d×1后静默广播;打印关键中间量的.shape。 - 训练统计边界:均值、方差、词典等只在训练集拟合;验证/测试只应用。
- 标签与阈值:正类方向、阈值来源(验证集约束)写明;测试集不参与选型。
- 失败案例:至少保留 1 个“列顺序打乱”或“误用测试集统计”的对照,证明检查能抓住它。
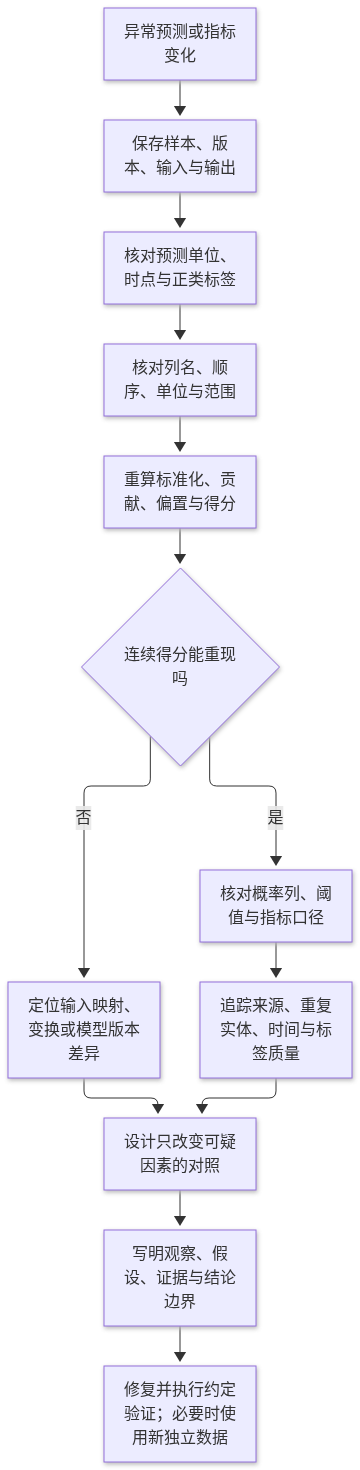
清单通过,不代表模型业务正确,只代表表示与运算没有先把问题换成另一个问题。下一课进入特征分解与几何时,会在同一套形状纪律上讨论投影与低秩近似。
放进方案里
在机器学习方案中,把本课内容写成可执行的输入与评估约定。先说明预测单位、预测时点和标签窗口,例如根据用户过去 30 天的行为预测未来 30 天流失。列出允许使用的特征、列顺序、单位、缺失处理和可获得时间,解释哪些结局后字段被排除。对于图片或文本,补充像素展开顺序、词表来源以及会被丢弃的结构信息。
数据部分注明来源、版本、样本数和正类定义。说明训练、验证、测试的划分比例,并根据场景选择时间划分或实体分组,避免近似副本跨集合。把标准化参数、填补参数和词表的拟合范围限定为训练集,保存完整变换流程,使后续预测能够重现相同坐标含义。
模型部分给出简单基线及输入输出尺寸,用点积、偏置和概率映射解释得分来源。记录模型与缩放器版本,提供可复算的样本计算账本。明确系数解释属于计算关联,避免把权重大小直接写成业务因果结论,也不要把概率数值直接当成已经验证的风险水平。
评估部分先写决策要求,再写指标。说明阈值在验证集上如何选择、目标召回是否达到、精确率和复核量是否可接受;测试集报告 precision、recall、F1、ROC AUC、混淆矩阵和样本量。若约束未满足,应写明差距及下一步,而不是通过反复查看测试集挑选阈值。
交付时附上可复现代码、依赖版本、划分索引、特征契约和错误样本记录。监测列顺序、缺失比例、数值范围与来源变化,在能获得真实标签后持续检查分类效果。若出现分布变化,先收集代表性样本重新评估适用范围。需要明确由谁维护输入契约、谁确认标签质量、谁批准阈值变更,让每次修改都能追溯到对应证据。
10 小结:下一步特征分解与几何(A5)
- 能说清
X的每行和每列分别代表什么,并给出n×d的尺寸。 - 能用逐项贡献重算
x·w+b,区分点积、逐元素乘法和转置。 - 能解释标准化使用的均值与标准差来自训练集,并保存相同变换用于后续数据。
- 能指出正类定义、数据划分方式、泄漏风险及列顺序约定。
- 能用混淆矩阵解释 precision、recall、F1,并用连续得分计算 ROC AUC。
- 能说明阈值选择过程、约束是否满足,以及测试集是否保持独立。
- 能区分泄漏、表示错误、类别不平衡和分布变化,并写出可复核的排查证据。
自测时可以口头回答:把输入列交换后为什么形状检查可能通过?降低阈值为什么不能提高同批样本的 AUC?训练均值为什么不能在测试集上重新计算?如果这些问题都能联系到具体样本和计算步骤,你已经建立了后续学习线性代数与机器学习所需的共同语言。矩阵分解、特征值以及更复杂的优化内部机制留待后续课程。