1 为什么表格式数据先学 NumPy 与 Pandas
机器学习项目里,模型往往只占几行代码,数据准备却决定这几行代码是否有意义。客户流失预测需要把每位客户的使用记录整理成特征;图像分类需要把像素排成数值数组;短文本分类需要把文本和标签准确对应。如果标签错位、缺失值被误当成 0,或者预测时才知道的信息提前混入训练集,换更复杂的模型通常只会把错误隐藏得更深。
NumPy 提供处理数值数组的共同语言,Pandas 提供处理带行列标签表格的工具。前者帮助我们表达形状、维度、批量运算和统计;后者帮助我们表达字段、索引、筛选、连接与分组。学习它们的重点不是背函数名,而是能回答:每行代表谁,每列表示什么,运算沿哪个方向进行,结果还能否对应原来的样本。
本课以公开的电信客户流失数据为主线。常见版本包含客户标识、在网月数、月费用、合同类型和是否流失等字段。不同发布版本的字段和编码可能不同,下载后需要核对说明。本课同时使用自造的小表演示可直接运行的操作;真实数据案例讨论诊断方法,不把演示结果冒充公开数据上的实验成绩。
还可以把同样的问题迁移到公开的手写数字图像或短文本数据。客户表中的 1 行通常是 1 位客户,图像数组中的第 0 维通常是样本,文本表中的 1 行通常是 1 段文本。它们的共同要求是:输入、标签和样本身份始终一致;训练时能够获得的字段,预测时也能够获得。
初学时容易觉得,电子表格也能完成筛选和求平均。区别在于可复现性:程序能记录清洗规则、划分方式、异常检查和输出路径,让同事在同样的数据快照上得到同样的结果。可复现不意味着永远固定旧数据,而是每次数据变化都有记录,每次指标变化都能找到证据。
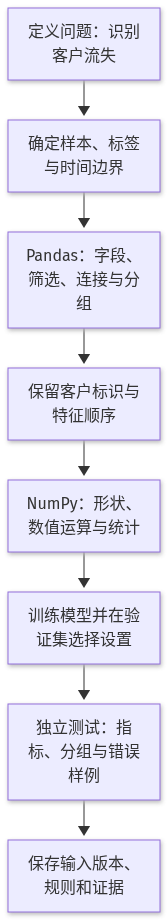
学习完成后,你应该能读懂数组的形状,区分位置与标签,写出可检查的筛选和聚合,并解释为什么必须先划分数据再拟合预处理规则。更深的内存布局、稀疏矩阵和分布式计算留到后续课程;这里先建立能够保护实验可信度的基本习惯。
2 数组形状、dtype、轴与基础广播
先把“预测流失”写成可检验的问题:在每月月末,利用此前已经发生的客户行为,预测该客户是否会在接下来的 30 天内取消服务。样本是某位客户在某个观察时点的记录;标签来自后续 30 天;特征只能来自观察时点及以前。这个时间边界比选用哪种分类器更早确定,也更难在实验末尾补救。
静态公开流失表通常只有当前客户属性和流失标记,未必提供完整事件时间。它适合演示分类流程,但不能仅凭这些字段宣称已验证“预测未来 30 天流失”的能力。可以将课堂任务限定为给定表格上的流失标签识别,并明确上线预测还需要按时间收集快照。公开不等于语义自动清楚,数据说明也是实验输入。
例如,在网月数 tenure、月费用 MonthlyCharges、合同类型 Contract 可以是候选特征;客户标识 customerID 用于追踪样本,通常不直接输入模型。取消申请时间、退款结果和流失后形成的备注,则可能直接泄露答案。累计费用是否可用,要看它在观察时点是否已经结算,不能仅因字段名普通就默认安全。
数据边界还包括纳入范围。只保留字段完整的客户会不会删掉大量新用户?同一位客户是否出现多次?标签未知表示还未观察满 30 天,还是确实未流失?这些情况不能统一填成负类。写出样本进入和退出数据集的条件,才能知道模型到底服务了谁,以及哪些人从未进入评估。
训练集用于学习参数,验证集用于选择特征、阈值和模型设置,测试集用于最后的独立评估。入门实验可以约定约 60% / 20% / 20% 的划分比例。类别较少时使用分层划分,让各集合保留接近的标签比例;存在重复客户时应按客户分组;评估未来表现时应按时间划分。分层随机划分并不能替代时间边界。
图像任务也有同样限制:同一原图裁出的多个片段应进入同一集合,否则模型可能记住背景。短文本任务中,转发、模板文案和近重复句子也可能跨集合泄漏。先确定独立样本的单位,再决定划分方式。随机种子只能稳定抽样结果,不能把错误的样本单位变正确。
建议在实验开头写下数据契约:来源和版本、样本单位、目标标签、允许使用的时间范围、字段类型、缺失含义以及划分原则。对每个候选字段补充“预测时是否可获得”的答案。这个小文档会把模糊争论变成可逐项检查的问题,也为后面的排查提供起点。
3 用 Pandas 做类型检查、筛选、分组与受检连接
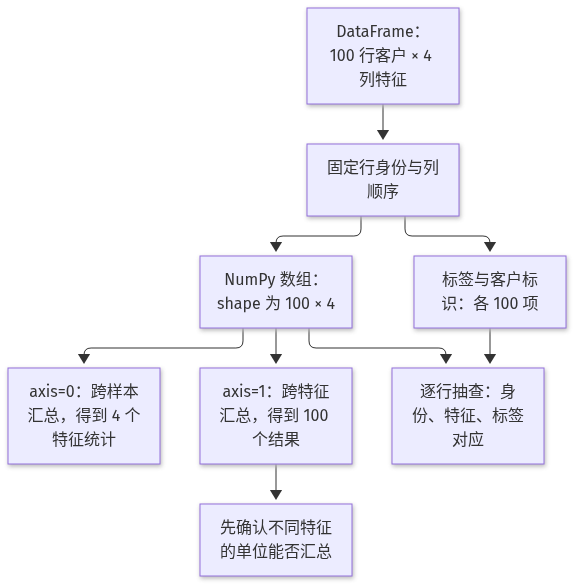
NumPy 的核心对象是 ndarray。它把相同数据类型的元素组织成规则数组。shape 表示各个轴的长度,ndim 表示轴的数量,dtype 表示元素类型。形状 (100, 4) 可以约定为 100 个样本、每个样本 4 个特征;形状 (100, 28, 28) 可以约定为 100 张灰度图。轴本身没有“客户”或“像素”的含义,含义来自你的约定。
对形状为 (100, 4) 的表格数组,沿 axis=0 求均值会汇总样本,得到每个特征的均值,结果形状为 (4,);沿 axis=1 求均值会汇总特征,得到每个样本的均值,结果形状为 (100,)。不过,月费用和在网月数的单位不同,直接求行均值通常没有业务意义。形状合法只是运算成立的必要条件,不能保证解释成立。
批量运算可以直接表达整列或整批样本的计算。若 x 是月费用数组,x > 80 会产生布尔数组,x[x > 80] 会取出满足条件的值。这比手写逐行循环更贴近“对所有样本施加相同规则”的意图。规则仍需检查缺失值和单位,例如把“分”误当成“元”,批量运算只会更快地产生错误。
广播允许某些不同形状的数组共同运算。判断时从末尾维度向前比较:对应长度相等,或其中 1 个长度为 1,才可兼容。例如 (100, 4) 减去 (4,),可表示每个样本减去相同的 4 个特征均值。若错误地得到 (100, 1) 的均值,运算可能仍然成功,却变成每行减去自己的均值,所以要同时核对形状和语义。
Pandas 的 Series 是带索引的列,DataFrame 是带行列标签的表。它可以让数值、字符串、日期等不同类型按列共存。列名表达字段含义,索引帮助定位和对齐数据。索引不一定是连续整数,也不一定唯一;需要稳定追踪客户时,应明确保存客户标识,不能把当前行号当作永久身份。
iloc 按位置取数据,loc 按标签或布尔条件取数据。df.iloc[:3] 表示前 3 行;df.loc[df["tenure"] < 6] 表示在网月数小于 6 的客户。筛选之后,原来的索引通常保留。此时 loc[0] 指向标签为 0 的行,未必是当前第 1 行。把标签和位置混用,是标签错位的常见来源。
Pandas 的运算经常按标签对齐。2 个 Series 相加时,会先匹配索引标签,缺少对应项可能产生缺失值。NumPy 数组则主要按位置运算。调用 to_numpy() 会移除行列标签;混合类型还可能得到不适合数值模型的类型。因此,转换前先固定特征列顺序,转换后检查形状、数值类型以及标签对应关系。
缺失值也需要语义。空白字符串不一定会被自动识别为缺失,NaN 与 0 也不能互换。对总费用列,空白可能源于刚开户尚未计费;对行为日志,缺失可能表示采集失败。应先辨认来源,再决定删除、填补或增加缺失标记。任何从数据估计出来的填充值,都要仅在训练集上计算。
groupby 能按合同类型或客户群体汇总数量和流失比例;merge 能按客户标识连接属性和行为统计。连接前必须检查键的唯一性:本来期望每位客户 1 行,却连接到多条事件,行数就会膨胀。先将事件汇总到约定粒度,再连接,并检查连接前后的样本数、未匹配数和标签分布。
4 样本标识、特征顺序与标签对齐
把实验拆成有边界的步骤,才能知道变化来自哪里。先固定原始文件和字段解释,再完成不依赖总体统计的类型检查与标签合法性检查,然后划分训练、验证和测试集合。之后才在训练集上学习填补值、类别映射和缩放参数。验证集与测试集只使用已经确定的规则进行转换。
这里要区分“固定规则”和“拟合规则”。把明确编码为 Yes 的标签转成 1,属于事先约定的映射;用整张表的中位数填补月费用,则从数据中估计了参数。固定规则也可能写错,因此需要检查;拟合规则还多了数据边界要求。不要把所有预处理都机械挪到划分后,也不要把所有清洗都当成与划分无关。
设训练集月费用为 [40, 60, 缺失, 100],中位数是 60。训练中的缺失值填为 60,验证集和测试集的缺失值也填为 60。即使验证集的月费用整体更高,也不能据此重新估计填充值。这个差异可能正是需要发现的分布变化,提前用验证集修正统计量会让评估边界变模糊。
类别编码同样如此。训练时见过按月合同和长期合同,验证时出现新合同类型,应采用事先约定的未知类别处理方式,并记录出现比例。如果每个集合各自生成编码列,列数或顺序可能不同;模型接到的第 2 列就可能不再表示原来的合同类型。保存编码规则和特征顺序,可以避免这种静默错误。
在最小实验中,可先训练只输出多数类的基线,再训练简单分类器。假设负类占 80%,永远预测未流失就有 80% 的准确率,但流失召回率为 0。这个基线提醒我们:高准确率未必意味着识别了需要关注的人。模型比较应使用相同划分、相同标签定义和一致的指标计算方式。
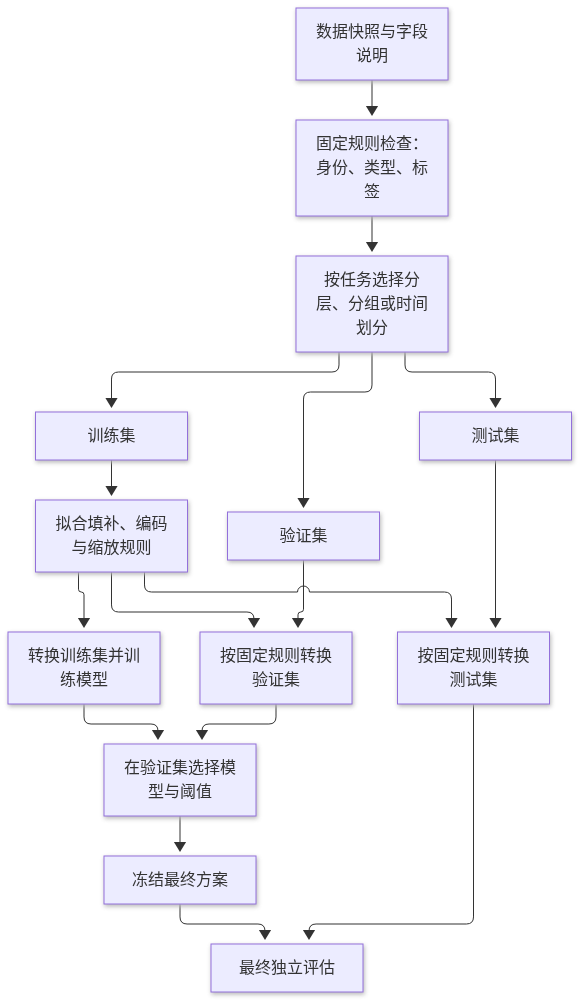
为了复现,需要保存原始文件摘要、软件版本、随机种子、划分清单、特征列表和预处理设置。种子不是万能凭证:文件排序、去重规则或库版本变化,也可能改变结果。最直接的证据是保留每个样本被分到哪个集合,以及该次运行采用了什么输入与规则。
实验输出应包含样本数、各集合正类比例、缺失比例、特征数量和验证指标。先看这些基础统计是否合理,再解释分数高低。若训练集有 6000 行,编码后突然只剩 4200 行,或者验证集没有正类,应该先查数据流程。模型能成功运行,并不意味着实验已具有解释价值。
5 动手:按任务边界切分并避免预处理泄漏
下面的小表专门制造了乱序索引、空白字符串和缺失月费用。它用于观察数据操作,不足以训练有意义的流失模型。运行环境需要 NumPy 和 Pandas。每个单元格都应有明确输入和输出;从头顺序运行笔记本,避免依赖某次手动执行遗留的变量。
import numpy as np
import pandas as pd

df = pd.DataFrame({
    "customer_id": ["c01", "c02", "c03", "c04", "c05", "c06"],
    "tenure": [2, 24, 1, 36, 8, 12],
    "monthly": [70.0, 50.0, np.nan, 90.0, 65.0, 55.0],
    "total": ["140", "1200", " ", "3240", "520", "660"],
    "contract": ["monthly", "annual", "monthly", "annual", "monthly", "annual"],
    "churn": [1, 0, 1, 0, 1, 0],
}, index=[20, 10, 40, 30, 60, 50])

assert df["customer_id"].is_unique
assert df["churn"].isin([0, 1]).all()
raw_total = df["total"].replace(r"^\s*$", pd.NA, regex=True)
total_number = pd.to_numeric(raw_total, errors="coerce")
parse_failure = raw_total.notna() & total_number.isna()
assert not parse_failure.any()
df["total"] = total_number
print(df.dtypes)
print(df.isna().sum())
errors="coerce" 会把无法解析的值变成缺失,它本身不能证明清洗正确。这里先把约定的空白转成缺失,再单独检查其他非空值是否解析失败。真实文件还应保留失败样例并统计数量。如果有 "1,200" 或货币符号,需要根据文件说明明确转换规则,不能悄悄吞掉异常。
接下来检查筛选和汇总的直觉。比较 recent.index 与原表索引,观察筛选不会自动重排标签。分组结果中的 count 表示该列非缺失值的数量,因此这里用已验证无缺失的标签列计数。若标签本身可能缺失,必须先解释缺失标签,避免把统计口径混在一起。
recent = df.loc[df["tenure"] < 6,
                ["customer_id", "tenure", "monthly", "churn"]]
summary = df.groupby("contract")["churn"].agg(["count", "mean"])
print(recent)
print(summary)

# 明确列顺序后,再把表格转换为数值数组。
feature_columns = ["tenure", "monthly"]
x = df.loc[:, feature_columns].to_numpy(dtype=float)
print(x.shape, x.dtype)
print(np.nanmean(x, axis=0))
最后演示训练规则如何应用到验证集。这里按客户标识手工指定集合,只为展示边界,不把这个小表的标签比例当作正式划分方案。总费用和合同类型暂不进入此段特征,方便集中观察数值填补。测试集在真实实验中应单独保留,此处没有执行模型选择或最终测试。
train_ids = ["c01", "c02", "c03", "c04"]
val_ids = ["c05", "c06"]
indexed = df.set_index("customer_id", verify_integrity=True)
train = indexed.loc[train_ids].copy()
val = indexed.loc[val_ids].copy()
assert set(train.index).isdisjoint(val.index)

fill_values = train[feature_columns].median()
assert fill_values.notna().all()
x_train = train[feature_columns].fillna(fill_values).to_numpy(dtype=float)
x_val = val[feature_columns].fillna(fill_values).to_numpy(dtype=float)
y_train = train["churn"].to_numpy(dtype=int)
y_val = val["churn"].to_numpy(dtype=int)
assert x_train.shape == (len(y_train), len(feature_columns))
assert x_val.shape == (len(y_val), len(feature_columns))
assert np.isfinite(x_train).all() and np.isfinite(x_val).all()
这段检查同时保护了 3 件事:集合身份不重叠,数组行数与标签长度相同,输入没有剩余的非有限数值。不过,长度相同仍不足以证明顺序正确。更稳妥的做法是在同一张已确定行顺序的表中同时提取特征和标签,并保留对应客户标识,方便逐行抽查与回溯。
在真实笔记本里,为读取、清洗、划分、转换和评估各保留清晰的单元格。修改前面的单元格后,应重新从头运行,不能只重跑最后的指标输出。展示表格时还要控制敏感字段和样例范围;公开数据的练习习惯,应能自然迁移到受权限约束的真实数据环境。
6 用输入统计对照精确率 / 召回率 / F1 / AUC
把流失定义为正类。真正例 TP 是实际流失且被预测为流失的客户;假正例 FP 是实际未流失却被预测为流失的客户;假负例 FN 是漏掉的流失客户;真负例 TN 是正确识别的未流失客户。混淆矩阵先给出数量,让后续比率有可追溯的分母。
精确率为 TP / (TP + FP),表示被提醒的客户里有多少确实流失;召回率为 TP / (TP + FN),表示实际流失客户里找到了多少;F1 为 2TP / (2TP + FP + FN),用于综合观察精确率和召回率。若分母为 0,需要说明采用的处理约定,并报告原始计数,不能让默认输出掩盖没有正类预测的事实。
假设验证集中有 1000 位客户,其中 100 位实际流失。某阈值下 TP=60、FP=90、FN=40、TN=810,则精确率为 40%,召回率为 60%,F1 为 48%,准确率为 87%。这些数值对应不同问题:名单中误报不少,同时仍漏掉 40 位流失客户。准确率单独出现时,很难支持行动决策。
模型通常先给出分数,再按阈值产生类别。降低阈值通常会增加提醒人数,同时提高召回率并带来更多误报。阈值应结合验证集表现、人工处理能力和误报漏报的代价来选。不要在测试集反复试阈值;反复选择会把测试集变成事实上的验证集,使最终分数失去独立性。
ROC AUC 描述跨阈值的排序能力,可理解为随机抽取 1 个正例和 1 个负例时,正例分数排得更高的程度;并列分数按约定处理。AUC 不直接说明某个阈值下要处理多少客户,也不证明概率已经校准。类别很不均衡时,还应查看 PR 曲线与平均精确率,并始终报告正类比例。
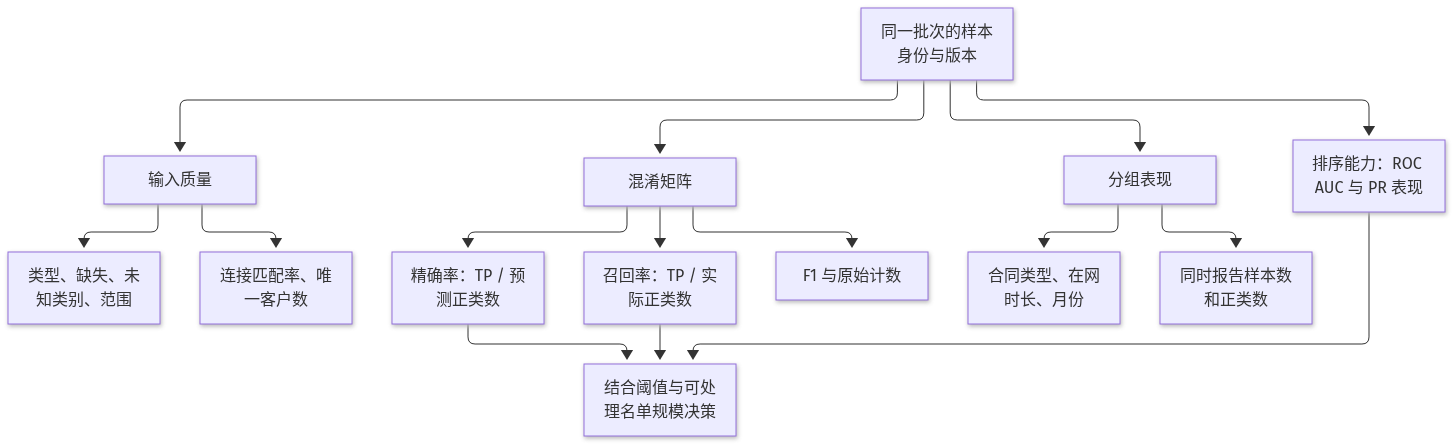
除总体指标,还要按合同类型、在网时长区间和数据月份查看样本数、正类比例与召回率。某个组只有 5 个正例,漏掉 1 个就会明显改变召回率,解释时必须同时给出分母。比较分组表现不是为了追逐每个小组的最高分,而是发现模型在哪些条件下证据不足或失效。
输入侧则记录类型变化、缺失比例、未知类别比例、数值范围和连接匹配率。若新批次在网月数整体更短,可能出现分布偏移;若月费用突然扩大 100 倍,可能是单位变化。前者需要评估模型对新群体的适用性,后者首先需要修复数据。仅看到 AUC 下降,无法区分这 2 类原因。
7 常见坑:隐式拷贝、对齐错位、链式赋值
第 1 类错误是泄漏。先对全表计算均值再划分,看似没有使用标签,却已经让评估集参与了训练规则。根据全表标签筛选“相关性最高”的字段,泄漏更加直接。修复时应把所有依赖训练数据估计的步骤放在训练边界内,并在每次验证划分中重新拟合;不要只修复最后的模型训练语句。
第 2 类错误是对齐破坏。对特征排序后,标签仍按旧顺序;对缺失特征删行后,标签只截取同样长度;连接后新增重复行却没有同步检查标签。它们都可能满足数组长度要求,但样本已经错配。应在拥有稳定样本标识的表上完成操作,最终再同时导出特征、标签和标识。
第 3 类错误是连接粒度不匹配。客户表每位客户 1 行,事件表每位客户有多行,直接连接会增加样本数,让高活跃客户被重复计入。若双方同一客户都出现多行,还可能形成组合膨胀。使用连接验证选项检查预期关系,并通过连接指示列检查未匹配记录;不能把行数增加解释为“数据更多了”。
第 4 类错误是把类型转换当作语义确认。数字外观的客户编号不是连续数值特征;0 可能表示没有使用,也可能表示缺失编码;日期字符串的字典序未必等于正确时间顺序。每次转换都应附上单位、允许范围和异常处理规则。输入越整齐,越需要警惕错误规则已经把异常整齐地抹平。
第 5 类错误是连写筛选后直接赋值,使修改对象和原表关系不清楚。入门时优先用 df.loc[条件, "列名"] = 值 表达对原表的明确修改;需要独立中间表时显式调用 .copy()。不同 Pandas 版本可能有不同复制行为,不能依赖偶然观察到的副作用,版本也应进入实验记录。
第 6 类错误是只为平衡类别而在划分前复制少数类样本。相同记录可能同时进入训练和测试,造成虚高分数。如需重采样,应只对训练部分进行,评估集保留任务实际分布。类别权重、重采样和阈值调整解决的问题各有侧重,先用基线和混淆矩阵确定症状,再选择方法。
第 7 类错误是盲目追求“向量化”。把整张大表复制成多个数组,或让广播生成巨大的中间结果,可能耗尽内存。入门阶段先选择必要列、检查形状与数据量,确认正确后再处理效率问题。图像像素转为浮点数前也要检查范围,避免对已经归一化的数据再次除以 255。
8 案例:连接后行数暴涨与指标失真
在公开电信客户流失表上,首先值得检查的是数值列中的空白和客户在网时长。若累计费用中的空白集中出现在刚开户客户,直接删掉这些行就改变了评估对象。应比较删除前后的在网时长分布、流失比例和样本数量,再决定是否保留缺失并增加标记。这里的诊断方向需要在实际下载版本上验证。
设某次教学实验中,随机验证得到较高 AUC,但换到较晚月份的客户快照,召回率明显下降。不能立刻断言模型过拟合。先核对标签观察窗口是否完整,再检查合同类别、缺失比例和在网时长分布。若较晚批次包含更多新用户,旧训练集对这类客户支持不足,才有证据考虑分布偏移。
另一种故障是把取消服务后的字段加入特征,验证指标突然接近完美。排查时按字段询问生成时间,并检查它与标签是否存在近乎直接的对应。删除可疑字段后重新运行完整流程,再比较指标变化。分数下降并不说明修复失败;在正确边界下得到较低指标,才能揭示任务真正的难度。
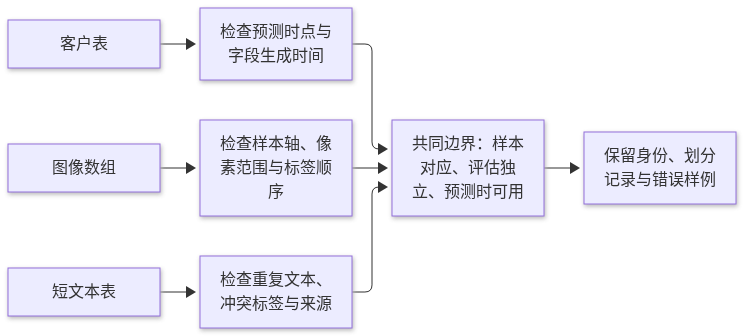
在公开手写数字图像上,NumPy 常用于查看批次形状、像素范围和标签数量。若只打乱图像而未同步打乱标签,模型输入与目标就失去对应。若数组从 (N, 28, 28) 展平成 (N, 784),应保持第 0 维的样本顺序,并抽取少量图像与标签对照。形状转换不能修复原先的数据错配。
图像上的另一个误判来自采集差异:训练图像背景干净,实际输入可能有倾斜、阴影或裁切。此时训练集准确率很高,不能证明真实输入可靠。用真实输入来源组织独立评估,并比较亮度、尺寸和错误样例。Pandas 可以记录每张图像的来源、标签和预测结果,NumPy 负责像素统计,二者共同支持诊断。
在公开短文本分类任务中,Pandas 适合检查文本长度、空文本、标签分布和重复记录。完全相同的文本跨集合出现,会让测试结果过于乐观;近重复模板也值得抽查。去重前先检查重复文本是否存在冲突标签,不能简单保留第 1 行。若标签冲突来自标注口径,清洗代码无法替代任务定义的修订。
这些案例都说明,故障经常发生在模型之外。客户表的时间边界、图像的样本顺序、文本的重复关系,表面上属于不同领域,实质上都在检查评估是否独立、输入是否可用、样本是否对应。把这些问题写成检查项,比记住某个数据集的特例更有迁移价值。
9 为不均衡与分布偏移准备可复现诊断
表清洗完成后,两类问题最容易让指标说谎:类别不均衡,以及训练分布与新批次分布不一致。把诊断准备写进流水线,比等到“效果变差”再临时查表更可靠。
不均衡诊断最少保存:各类计数与比例、分层划分是否生效、混淆矩阵、阈值扫描曲线,以及“多数类基线”分数。若正类只有几个百分点,单独报准确率没有决策价值;应同时报召回率、精确率与达到运营容量时的表现。
分布偏移诊断最少保存:按时间或来源分组的输入统计(缺失率、类别比例、数值分位数)、标签率(若可得),以及同一模型在新旧切片上的指标对照。漂移本身不是罪名——要写清它是否伴随目标指标变化,以及是特征变化、标签定义变化还是采样变化。
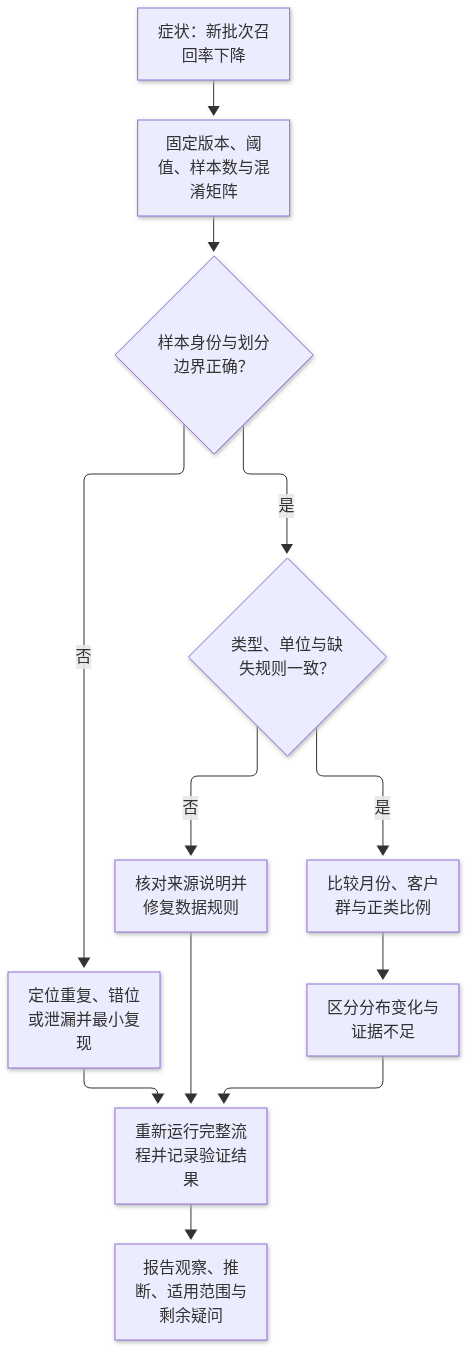
可复现要求每次诊断都能指向具体对象:哪次连接、哪份划分清单、哪版特征表。例如怀疑连接膨胀,就保留连接前后行数、唯一客户数与重复键样例;怀疑单位变更,就保留字段范围与来源说明。先固定数据身份,再谈调模型。
把上述诊断输出当作实验附件,而不是口头印象。下一课补线性代数时,特征矩阵的形状与尺度会直接影响模型;若这里已经能稳定说出“谁在不均衡、哪里在偏移”,后面的向量与矩阵讨论才有数据可挂。
放进方案里
在客户流失识别方案中,先写清预测时点、标签窗口与样本单位,再说明公开静态表能支持哪些练习结论,以及上线前还缺少哪些时间数据。字段清单应包含名称、类型、单位、来源和可用时间,客户标识用于追踪,标签与预测后才出现的字段不得混入输入。对缺失、重复和未知类别分别约定处理规则。
数据流程由 Pandas 完成读取、筛选、按客户汇总和受检查的连接,由 NumPy 承担数值数组转换与批量统计。交接处固定特征顺序,保留样本标识,检查数组形状、数值范围和标签对应。按任务选择分层、分组或时间划分;只在训练集拟合填补、编码与缩放规则,验证和测试复用同一套转换。
数组交接的验收应要求客户键唯一、特征与标签标识逐行一致、数值输入全部有限。客户级汇总后的连接用 merge(validate="one_to_one") 检查关系,并保存连接前后行数及未匹配客户清单。另用乱序索引、重复客户键和整列缺失的样例验证:流程应保持身份对应,或明确报错,不能静默改变训练样本。
验收从多数类基线开始,同时报告样本数、正类比例、混淆矩阵、精确率、召回率、F1 与 ROC AUC。类别不均衡时补充 PR 表现,阈值依据验证集和可处理名单规模确定。对新用户、合同类型和数据月份单独查看指标与分母,避免总体分数掩盖局部失效。测试集在决策完成后提供最终独立评估。
交付物包括数据契约、文件摘要、划分清单、环境版本、可顺序运行的笔记本、预处理参数与指标报告。设置缺失比例、未知类别比例、连接匹配率及数值范围的检查;发现异常先保留批次和样例,再按证据链排查。若输入来源或标签口径改变,应重新确认适用范围,并用新的独立数据评估,不能只沿用旧分数。
10 小结:下一步补线性代数直觉(A4)
- 能说明每行、每列和每个轴的含义,读懂
shape、dtype与axis。 - 能区分
loc与iloc,知道 Pandas 按标签对齐,NumPy 主要按位置运算。 - 转换为数组前固定列顺序,保留样本标识,同时提取对应标签。
- 检查缺失含义、解析失败、连接粒度和重复键,不把缺失统一填成 0。
- 根据任务选择划分方式,只用训练集拟合预处理规则。
- 用基线、混淆矩阵和分组指标解释模型,使用验证集选择阈值。
- 将泄漏、类别不均衡和分布偏移写成可检查的假设,并保存复现证据。
自测时可以问自己:为什么 87% 的准确率仍可能漏掉大量流失客户?为什么 2 个长度相同的数组仍可能标签错位?为什么验证集出现新类别时不能重新拟合编码?能够结合样本身份、时间边界和指标分母解释这些问题,就具备继续学习模型训练的基础。