模型训练常被画成不断下降的曲线,但曲线不会告诉我们:该改哪个参数、该改多少,以及下降是否真的有用。微积分提供了观察局部变化的语言。本课从可手算的小函数出发,把导数、梯度与训练日志联系起来;不要求先掌握严格的极限证明,也不展开复杂优化器的内部结构。
1 为什么优化模型要懂一点微积分
设想用公开的 UCI 乳腺癌诊断数据做表格分类。数据包含 569 个样本、30 个数值特征,例如平均半径、平均纹理和平均面积。我们把恶性设为正类,希望模型输出恶性的预测分数。这个练习用于理解分类训练,不能据此宣称具备临床使用能力。模型中的权重决定每个特征如何影响分数,偏置决定整体倾向。训练的任务,就是依据已有标签调整这些参数。
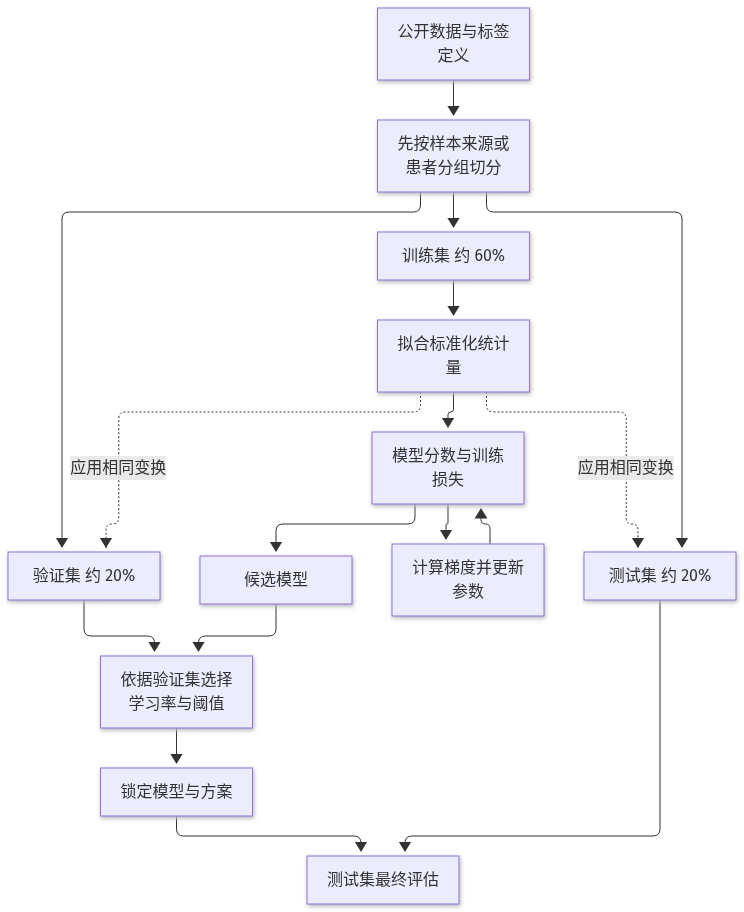
开始前先分数据。采用分层抽样,将约 60% 用于训练、20% 用于验证、20% 用于测试,实际整数样本数以切分程序为准,并固定随机种子。如果数据存在同患者多次记录,应先按患者分组,防止同患者跨集合。训练集用来计算梯度并更新参数;验证集用来选择学习率、训练轮数和决策阈值;测试集在方案锁定后评估。均值、标准差和缺失值填补规则也只从训练集估计,再原样应用于另外 2 个集合。
假设模型把某条恶性记录的分数从 0.40 提高到 0.45,方向似乎正确,但应该把半径权重加多少?如果每个参数都随机尝试,参数稍多就会难以安排。导数回答更具体的问题:在当前参数附近,让参数增加很小的量,损失大约会怎样变化。这个局部信息让训练可以有方向地试探,而不必枚举所有参数组合。
我们需要分清损失与指标。损失是训练时用来评价预测偏差的函数,通常选择便于计算梯度的形式;precision、recall、F1 和 AUC 则帮助评估模型在任务中的表现。precision 关注预测为正的样本中有多少确实为正;recall 关注实际正类中找回多少;F1 综合前面 2 项;常见的 ROC AUC 衡量正类分数排在负类之前的能力。它们不保证随损失同步改善。
微积分也不替我们确定标签是否可信、切分是否泄漏。如果把诊断后才产生的字段放进特征,训练可能迅速收敛,验证结果也可能很好,却无法用于真正的提前预测。梯度只会推动既定目标下降,不会判断目标和数据是否符合任务。因而学习微积分的价值,是让我们能解释参数更新、识别数值异常,并把数学变化与数据证据放在同张记录里。
2 导数、偏导数与梯度的含义
先看只含 1 个变量的函数 f(w)=(w−3)²。在 w=1 时,函数值为 4。如果把 w 增加 0.01,函数值变成 3.9601,平均变化率是 (3.9601−4)/0.01=−3.99。把这个增量继续缩小,变化率趋近 −4,这就是该位置的导数。符号告诉我们局部上升或下降的方向,绝对值描述对参数微小变化的敏感程度。
导数写作 f′(w),这里 f′(w)=2(w−3)。它表达的是局部近似:当增量 Δw 足够小时,f(w+Δw)≈f(w)+f′(w)Δw。在 w=1 附近,增加 0.01 大约使函数值减少 0.04,和刚才的实际结果接近。这里的“足够小”依赖函数和当前位置,不能把局部近似随意延伸到远处。导数为负也不表示参数越大越好;超过 w=3 后,导数会变成正数。
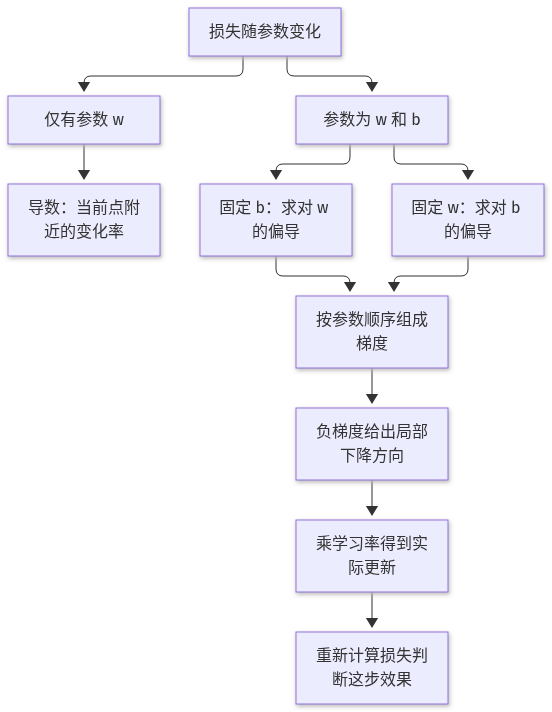
模型往往有很多参数。若损失是 L(w,b),对 w 求偏导,就是暂时固定 b,只观察改变 w 会造成什么影响;对 b 求偏导则反过来。偏导数不是把另外的参数删掉,而是在当前全部参数给定的条件下考察某个方向。比如 L(w,b)=(w+b−3)²+w²,在 w=1、b=0 时,对 w 的偏导为 −2,对 b 的偏导为 −4。相同大小的独立扰动,对损失的局部影响不同。
把各参数的偏导按固定顺序排列,就得到梯度 ∇L。对刚才的例子,按 (w,b) 排列得到 (−2,−4)。在普通欧氏距离的参数坐标中,梯度指向局部增长最快的方向,负梯度则是下降方向。训练常用更新式 θ新=θ旧−η∇L,其中 θ 代表全部参数,η 是学习率。必须保持参数与梯度的顺序、形状一致,否则即使每个数字单独看起来合理,更新仍会出错。
梯度小通常表示当前损失对局部参数扰动不太敏感,但不能直接宣布“已经找到最好模型”。可能确实接近驻点,也可能进入平坦区域,或者梯度在计算中被错误截断。不同参数的单位和量级还会影响梯度大小,不能仅凭某个偏导绝对值大,就认定对应特征更重要。我们将用函数值、梯度和更新后的结果共同判断,而不是只盯住某个数字。
3 链式法则:复合损失怎么回传
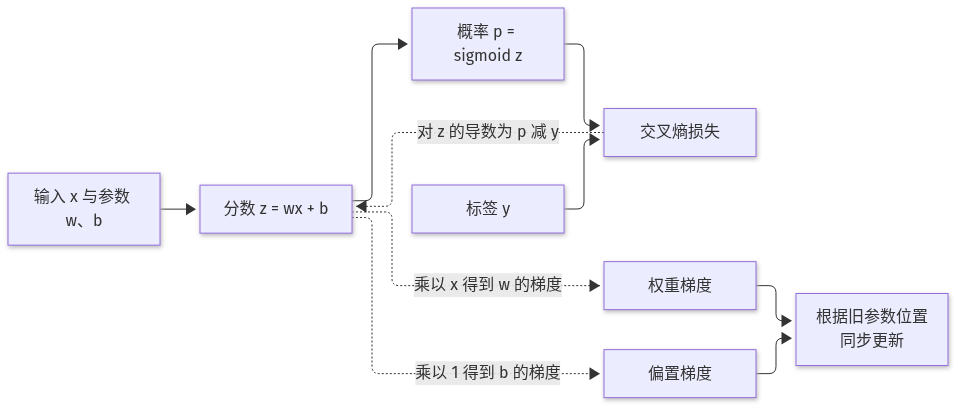
分类模型通常不是直接把权重代入最终损失,而是经过多层计算。取标准化后的平均半径为 x,先算线性分数 z=wx+b,再用 sigmoid 得到 p=1/(1+e^(−z)),最后将 p 与标签 y 比较。对单条记录,二元交叉熵为 ℓ=−[y ln p+(1−y)ln(1−p)]。其中 y 只能是 0 或 1,p 位于 0 与 1 之间。对训练批次取平均,才得到本次更新使用的损失。
如果想知道 w 如何影响损失,就要把沿途的影响连起来。链式法则写成 ∂ℓ/∂w=(∂ℓ/∂p)(∂p/∂z)(∂z/∂w)。可以把它理解为变化的传递:权重变化先影响分数,分数变化影响概率,概率变化再影响损失。每段只需回答局部问题,沿路径相乘后就得到起点对终点的影响。如果某个参数通过多条路径影响损失,各路径的贡献还要相加。
在 sigmoid 与二元交叉熵的这个组合中,中间项化简后有 ∂ℓ/∂z=p−y,因此 ∂ℓ/∂w=(p−y)x,∂ℓ/∂b=p−y。这个简洁结果依赖指定的模型和损失,换成别的损失不能直接照搬。若批次包含 m 条样本,平均损失对权重的梯度就是这些单样本梯度之和再除以 m;把平均误写成求和,会让梯度尺度随批次大小改变。
用具体数字走过路径。设 x=2、w=0、b=0、y=1,那么 z=0、p=0.5,单样本损失约为 0.693。此时对 z 的导数为 −0.5,对 w 的梯度为 −1,对 b 的梯度为 −0.5。学习率取 0.1,更新后 w=0.1、b=0.05,新的 z=0.25,p 约为 0.562,损失约为 0.576。真实正类得到更高分数,损失也下降了。
实现时不必先求概率再手工取对数。许多训练库提供直接接收原始分数的稳定交叉熵实现,可以避免极端概率造成 log(0) 等数值问题。选择这类接口时要检查输入要求,不能把已经做过 sigmoid 的概率又当原始分数传入。链式法则在这里帮助我们理解接口组合;至于复杂计算图如何保存中间量、如何调度反向计算,将留给自动微分专题。
4 动手:一元/二元函数手算梯度
先安排 1 个可以独立核对的练习。给定 f(w)=(w−3)²,从 w=0 出发,学习率取 0.1。当前函数值为 9,导数为 −6,所以更新后 w=0−0.1×(−6)=0.6。重新代入,函数值为 5.76。下一次导数是 2×(0.6−3)=−4.8,更新后 w=1.08,函数值为 3.6864。每次都应使用当前位置的导数,不能把起点的 −6 一直复用。
这段计算可以拆成固定顺序:记录旧参数,计算旧位置的损失和梯度,形成新参数,再计算新位置的损失。损失下降验证了这几步在当前例子上的效果,但不能反过来证明所有实现都正确;错误梯度偶尔也可能让损失下降。手算练习的重点,是建立可以逐项对照的中间值,尤其检查减号、平方求导时的系数,以及学习率是否真正乘到了梯度上。
再看 2 个变量:L(w,b)=(w+b−3)²+w²。记 r=w+b−3,则 ∂L/∂w=2r+2w,∂L/∂b=2r。从 w=1、b=0 出发,r=−2,损失为 5,梯度为 (−2,−4)。学习率为 0.1 时,得到 w新=1.2、b新=0.4。重新计算 r新=−1.4,损失为 1.96+1.44=3.40,确实比 5 小。
这里的 2 个新参数都应依据旧位置 (1,0) 的梯度计算。若先把 w 改成 1.2,再用这个新 w 重新计算 b 的梯度,执行的就是另一种更新过程,不能再拿它与刚才的结果直接比较。写程序时,可以先保存完整梯度,再统一更新参数。这个约定尤其适合刚开始排查手写模型,能减少“公式没错、执行顺序不同”带来的困惑。
还可以用有限差分检查方向。固定 b=0,在 w=1 附近取 h=0.001,分别计算 L(1+h,0) 与 L(1−h,0),中心差分 [L(1+h,0)−L(1−h,0)]/(2h) 得到约 −2,与解析偏导一致。对 b 做同样操作得到约 −4。这个例子是二次函数,中心差分在精确算术下恰好给出正确导数;一般函数只会近似吻合。亲手完成这张数值对照后,再把检查迁移到分类损失,会更容易定位错误发生在哪个环节。
把手算迁移到分类模型时,还可以加入正则项,观察同个权重受到的 2 种作用。设目标为 J(w,b)=平均交叉熵+λw²/2,这里约定只惩罚权重,不惩罚偏置。对 w 求导得到 ∂J/∂w=平均[(p−y)x]+λw;对 b 的偏导仍为平均(p−y)。正则项让较大的权重付出额外代价,其梯度与 w 同号,因此负梯度更新会产生把权重拉向 0 的分量。
取单条记录 x=1、y=1,旧参数为 w=1、b=0,λ=0.5。此时 p 约为 0.731,数据损失对 w 的导数约为 −0.269,正则项的导数为 0.5,总导数约为 0.231。学习率取 0.1,得到 w新约为 0.9769、b新约为 0.0269。虽然正类样本希望增大权重,总目标却要求此刻略微减小它。这说明不能只用单条样本的预测方向判断更新是否正确,必须先写清实际优化的完整函数。
核对时分别列出数据损失、正则代价及两者的梯度,再求和。若前向用了 λw²/2,反向却写成 2λw,就把惩罚力度翻倍了;若数值差分漏掉正则项,也会制造梯度不一致。多个特征时,正则代价可写为 λΣwⱼ²/2,各权重分别贡献 λwⱼ。不同特征尺度会影响同等预测作用所需的权重大小,因此正则强度的比较应建立在固定预处理规则之上。
5 学习率、步长与局部最优的直觉
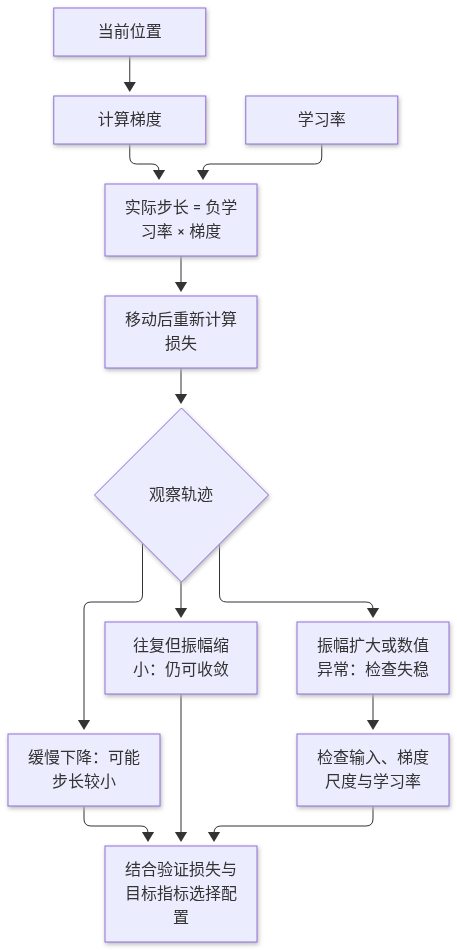
学习率与实际移动距离不是同个概念。更新式中的 η 是缩放系数,参数步长则是 Δθ=−η∇L。因此,即使学习率保持 0.1,梯度绝对值从 2 变成 200 时,更新幅度也会从 0.2 变成 20。观察训练是否稳定,应同时记录学习率、梯度范数和参数更新幅度。只记录学习率,解释不了为什么某个批次突然把参数推得很远。
仍用 f(w)=(w−3)²,从 w=0 出发。学习率取 0.1,参数逐步接近 3;取 0.5,更新直接到达 3;取 0.9,参数会在 3 两侧来回,但振幅逐渐缩小;取 1,参数在 0 与 6 之间往复,损失始终为 9;取 1.1,振幅还会扩大。这些现象说明“沿下降方向”只描述起点附近的方向,过大的移动可能跨过谷底并走到更高的位置。
这个例子还能写成误差关系:w新−3=(1−2η)(w旧−3)。当 0<η<1 时,误差绝对值会逐步缩小。但这个范围只适用于当前函数,不能当作所有训练任务的学习率推荐。若把函数改成 100(w−3)²,曲面陡峭程度改变,同样的学习率就可能失稳。真实模型还会遇到多个方向陡峭程度不同、不同批次梯度不同的情况,需要用验证记录选择合适设置。
局部最优表示在足够小的邻域里,找不到更低的函数值;全局最优则要和整个允许范围比较。梯度为 0 只是驻点的信号,未必是最小值,例如 f(w)=−w² 在 w=0 的导数为 0,却处在峰顶。复杂模型还会有较平的区域和鞍点,本课只需知道“梯度变小”不能单独证明到达全局最优,不必在此学习完整的曲面分类理论。
在实际训练中,可以固定切分、初始化和批次顺序,比较少量候选学习率,观察训练损失是否平稳下降、验证损失是否改善,以及目标指标是否达标。若训练损失继续下降而验证损失上升,应考虑过拟合,不能只靠不断减小学习率解决。若不同种子的结果差异明显,应报告波动,并检查小样本和类别比例。学习率选择服务于整个训练流程,不是只让图上的曲线看起来平滑。
6 常见坑:不可微点、尺度失衡、爆炸/消失苗头
并非每个常见函数在所有位置都可微。绝对值 |w| 在 w=0 左右的斜率不同,ReLU=max(0,z) 在 z=0 也存在转折。训练库会采用约定的处理方式,这使许多模型仍可训练,但检查工具要知道正在比较什么。如果有限差分的正向扰动和负向扰动落在转折的两侧,得到的结果可能无法与某侧的解析导数直接对齐。此时应换到远离转折的位置,或明确报告该点不能按普通光滑函数检查。
尺度失衡在表格数据中很常见。平均面积可能取几百,某个比例特征却在 0 到 1 之间。对线性分类模型,梯度含有输入 x,数值尺度差异会直接影响不同权重的更新。模型可能沿某个方向频繁跨越谷底,沿另个方向却推进缓慢。常用起点是标准化:用训练集均值中心化,再除以训练集标准差,并将同套变换应用于验证集和测试集。标准差为 0 的特征需要单独处理。
标准化不是越早做越好,而是必须放在正确的数据边界内。如果先用全量数据算均值和标准差,再进行切分,就让验证集和测试集的信息进入了训练准备过程。类似地,使用全量标签筛选特征后再切分,也会泄漏。这样的流程可能拥有正常的梯度和漂亮的曲线,因此不能把数值检查当作数据检查的替代品。调试时要分别记录预处理拟合范围和梯度计算范围。
在较深的图像分类模型中,链式法则沿路径相乘,连续出现很大或很小的局部因子,会让某些梯度变得巨大或接近 0。爆炸的苗头包括梯度范数骤增、损失突然跃升、出现无穷大或 NaN;消失的苗头包括前部参数梯度长期极小、对应参数几乎不变且训练停滞。但小梯度也可能意味着已经接近稳定点,需要结合损失、参数变化和层间差异判断,不能见到小数字就下结论。
排查应从容易确认的事实开始:输入是否有限值,标签编码是否正确,损失接口是否匹配,是否重复累积了本不该累积的梯度,损失是求和还是平均。接着用更小学习率和固定小批次复现,再检查初始化和各层激活。梯度裁剪可以限制过大的更新,但不能修复错误标签、泄漏或错误的求导路径。面对消失问题,也不要直接把学习率放大很多,否则其他梯度正常的部分可能先失稳。
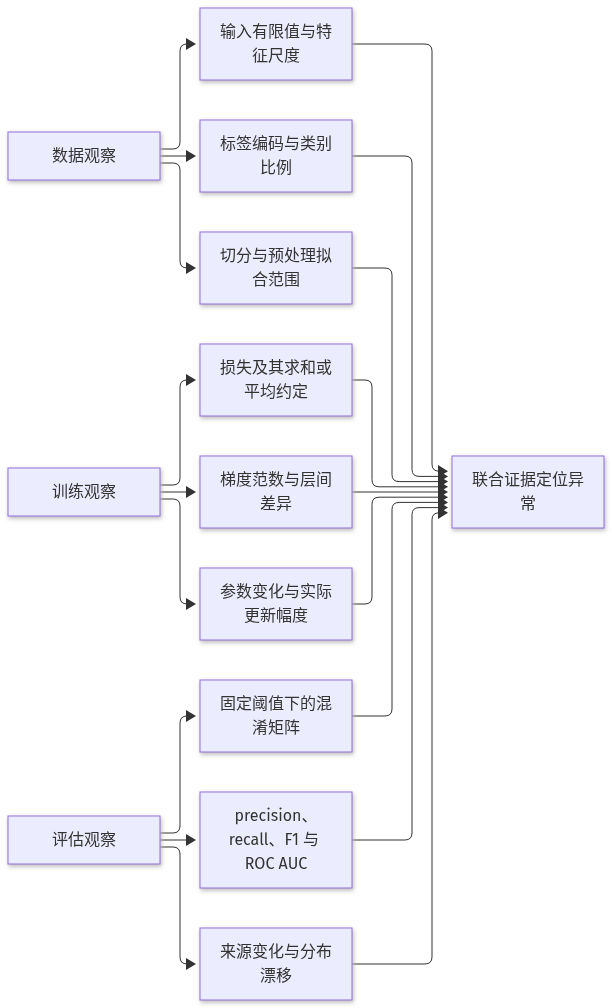
7 案例:损失下降但业务指标不动
回到乳腺癌表格分类练习。先锁定训练、验证和测试索引,将恶性映射为 1,按训练集统计量标准化,并训练逻辑回归。为了说明诊断过程,下面使用构造的验证记录,不把它冒充该数据集的实测成绩。假设某个验证集有 114 条记录,其中正类 42 条、负类 72 条。评估时暂时固定阈值为 0.5:分数不低于阈值就预测为正类。
训练早期与后期的平均验证交叉熵分别为 0.48 和 0.39,但在阈值 0.5 下,2 次都得到 TP=20、FN=22、FP=3、TN=69。于是 precision=20/23,约为 0.870;recall=20/42,约为 0.476;F1=40/65,约为 0.615。损失确实下降了,固定阈值下的分类结果却完全相同。原因可能很普通:正类分数由 0.20 提高到 0.35,或负类分数由 0.20 降到 0.10,都能降低损失,却没有样本跨过 0.5。
还应检查排序。若 ROC AUC 同时从 0.86 提高到 0.90,说明排序能力也改善,只是当前阈值没有把改善转成更多正类检出;若 AUC 几乎不动,也可能主要是分数置信程度发生变化。ROC AUC 不依赖单个分类阈值,但不能保证某个工作点的 precision 和 recall 达标。对于强调少漏检的任务,应先明确可接受的误报与漏报约束,再在验证集上比较阈值。
例如在示意记录中,把阈值降到 0.3 后可能得到 TP=32、FN=10、FP=12、TN=60,对应 precision 约为 0.727,recall 约为 0.762,F1 约为 0.744。召回提高伴随误报增多,不能只展示其中有利的数字。阈值选择属于模型方案的一部分,应只根据验证集决定,再固定到测试集。反复查看测试集并据此选阈值,会把测试集变成另个验证集。
类别不平衡会放大误读。如果某短文本分类任务只有 5% 的正类,全部预测为负也能得到 95% 的准确率,却有 0 的正类召回。平均损失可能主要受多数类影响,因此应同时报告各类样本数、混淆矩阵和目标类指标。若部署后的文本来源改变,或图像拍摄条件改变,还要考虑分布漂移。此时即使训练梯度完全正确,旧验证集上的损失下降也不能证明新环境已经改善,应补充来自目标环境且标注可信的评估样本。
8 把梯度检查写进训练调试步骤
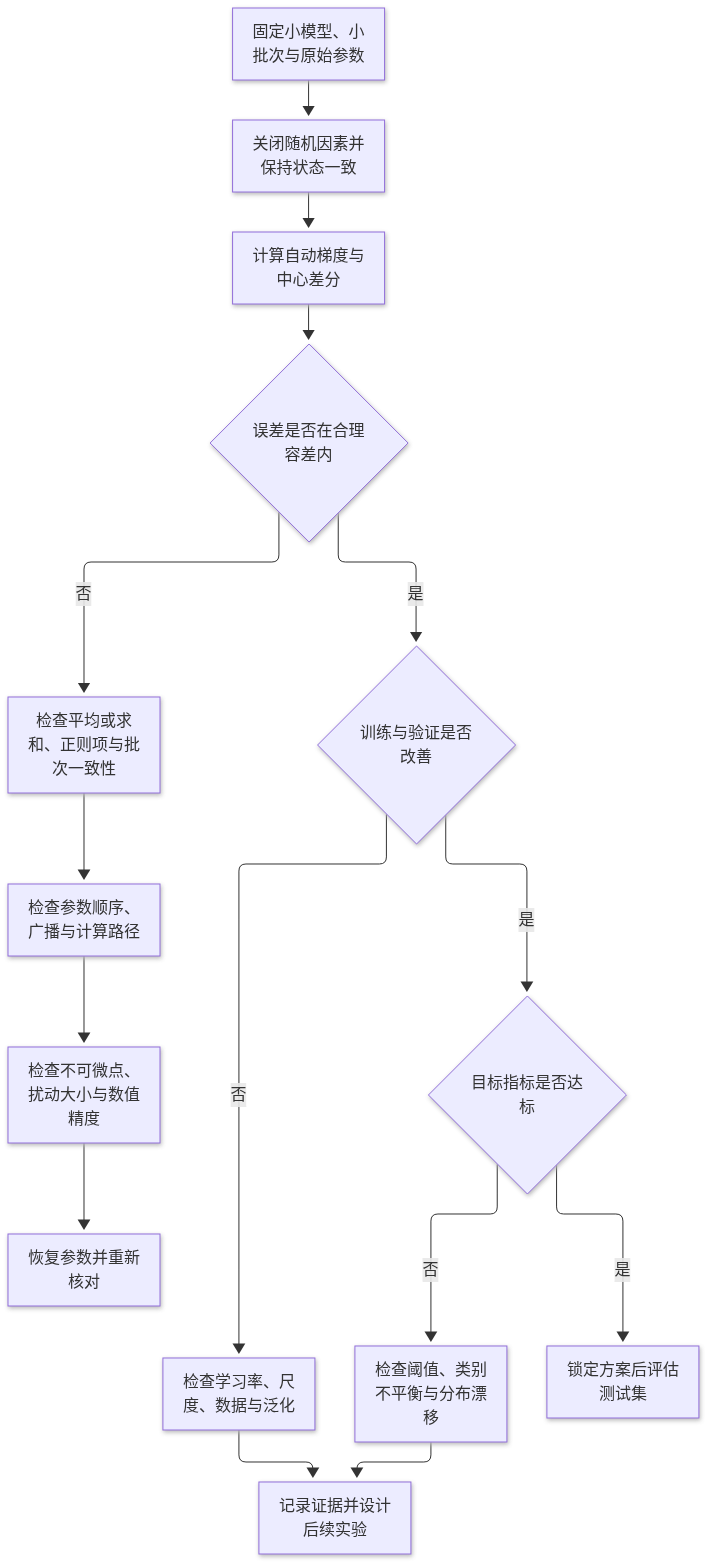
梯度检查比较的是同个函数、同组参数上的解析或自动微分结果与数值近似。对第 i 个参数,中心差分为 g数值,i=[L(θ+h eᵢ)−L(θ−h eᵢ)]/(2h),其中 eᵢ 只在第 i 个位置为 1,其余位置为 0。每次只扰动该参数,其他参数和数据必须保持不变。需要强调,有限差分不用于替代正常训练;参数很多时,它需要大量额外的前向计算。
先挑选很小的模型和固定批次,例如 4 条记录、2 个输入特征、1 个偏置,并尽量使用双精度计算。关闭随机丢弃、随机增强等因素,使多次前向计算对应同个函数;涉及批次统计的模块也要保持状态一致。先在原始参数处求自动梯度并保存,再分别计算正扰动与负扰动损失。每次扰动后恢复原值,最后再次确认模型处于原始参数位置,避免检查动作改变后续训练起点。
比较时不要只看显示到小数点后 2 位的结果。可以同时记录绝对误差 |g自动−g数值|,以及相对误差 |g自动−g数值|/max(ε,|g自动|+|g数值|),其中 ε 可先取 10⁻⁸ 作为分母保护。对于接近 0 的梯度,相对误差可能被放大,要结合绝对误差判断。容差还取决于精度、函数平滑程度和扰动大小,不能把某个固定阈值宣布为所有模型都通用的正确标准。
扰动 h 太大,会让局部近似误差明显;太小,则可能在相近数相减时暴露浮点舍入误差。双精度的小模型可以从 h=10⁻⁵ 开始,并比较 10⁻⁴、10⁻⁶ 等邻近量级,观察结论是否稳定。这里只是起点。如果参数尺度差异很大,还需让扰动与参数尺度相适应。若检查点靠近不可微转折,应先移开检查点,不能仅靠减小 h 来保证问题消失。
出现不一致时,先核对损失是否同为平均、是否包含同样的正则项、标签和批次是否一致,再查广播、参数顺序以及是否意外断开计算路径。若有限差分与自动梯度吻合,而训练仍不改善,就继续检查学习率、数据、阈值与泛化。将参数坐标、正负扰动损失、梯度、误差和运行精度写入调试记录,比只留下“检查通过”更有用。对完整大模型可以抽取少量坐标检查,但抽查通过不能证明所有参数都没有问题。
9 从解析梯度过渡到自动微分的边界
解析梯度是依据求导规则写出表达式,适合本课的平方损失和简单分类模型。有限差分通过参数扰动近似变化率,适合小规模核对。自动微分则把实际执行的运算拆成支持求导的局部操作,再按照链式法则组合导数。它通常不需要像有限差分那样为每个参数重新做正负扰动,也不是把整段程序先转换成我们手写的完整代数公式。
理解这个区别,才能正确使用训练库。自动微分会对执行到的计算路径求导,但不会替我们发现“写出来的损失并非想要的损失”。如果把恶性标签与良性标签反过来、把平均误写成求和,或者将某项损失漏加,程序仍可能顺利返回梯度。它给出的是当前程序的局部导数,任务定义、数据切分和指标选择仍然需要人检查。梯度检查也只能验证所选函数的求导一致性。
图像分类和短文本分类会出现更长的计算路径。例如图像经过若干变换得到类别分数,或文本经过词表示与聚合得到分类分数,最终仍可与交叉熵连接。读者此时不必手推每个网络层,只需先辨认输入、可训练参数、原始分数和损失,并确认它们之间有连续的求导路径。把连续分数转换成离散类别的 argmax 通常用于评估,不应放在需要梯度的分类损失前面。
另外,梯度只描述当前批次和当前位置。小批次更换后,梯度会波动;在验证集上计算损失用于选方案,也不等于应该用它更新参数。训练时还要理解梯度是否被累积:很多库的反向计算会把梯度加到已有缓冲区,因此每次普通更新前要按框架约定清理;若有意累积多个微批次,则应明确损失缩放与更新时机。不能仅凭调用了反向接口,就认为更新规则已经完整正确。
本课可以停在这个边界:能够手算小函数梯度,解释链式法则,观察学习率与梯度共同造成的参数变化,并用有限差分检查小模型。更复杂的自动微分实现、优化器状态、曲率方法和混合精度细节留待后续。面对真实任务,先让数据边界、目标函数、更新规则和评估证据彼此对应。这样从纸面公式走向训练代码时,每个异常都有可追问的位置,而不会把所有失败都归因于“模型还不够大”。
放进方案里
在乳腺癌表格分类方案中,先写清任务边界:使用预测时可获得的 30 个数值特征,恶性为正类,输出分数及按固定阈值得到的类别。数据来源、标签映射、样本标识和去重规则必须可追溯;若存在同患者多条记录,按患者分组切分。采用约 60%/20%/20% 的训练、验证、测试划分,保存索引与随机种子,标准化统计量只从训练集估计。
训练部分以逻辑回归和平均二元交叉熵作为起点,记录初始化、批次大小、学习率、轮数和停止条件。正式训练前,用固定小批次核对前向损失、解析梯度与中心差分;保存扰动量、计算精度、误差及异常坐标。训练中记录损失、梯度范数和更新幅度,遇到非有限值先检查输入与损失接口,再调整学习率。任何类别权重调整都要记录,并重新评估其对阈值的影响。
评估部分在验证集选择学习率、停止轮次和阈值,报告类别数量、precision、recall、F1、ROC AUC 与混淆矩阵。若损失下降但召回不动,检查分数是否跨越阈值、排序是否改善,以及错误是否集中在某类样本。待配置锁定后使用测试集评估,写明小样本带来的不确定性,不依据测试成绩继续选配置。
交付时附上预处理参数、模型参数、阈值、运行环境和评估记录,使同份输入能得到可复现结果。对后续来源变化的数据,跟踪特征范围、类别比例及有标签样本的指标;若出现明显漂移,补充评估再决定重训。验收不只要求损失下降,还要求目标类指标达到事先约定的门槛,且无已知数据泄漏。未达到时应记录失败证据与下步实验,避免把数学收敛直接写成任务成功。
10 小结:下一步概率语言(A7)
导数刻画局部变化,偏导固定其他参数,梯度汇总各方向的敏感度。链式法则把局部影响连成完整路径,学习率决定沿这条方向走多远。有限差分能够核对小模型的梯度,但梯度正确、损失下降和任务达标仍需分别提供证据。
读完后,试着解释 3 个问题:为什么负梯度方向上的大步也可能让损失上升?为什么交叉熵下降而 recall 保持不变?为什么自动微分无法识别数据泄漏?若能分别从局部近似、阈值决策和数据边界作答,就抓住了本课主线。
下一课 A7 转向概率语言:预测分数与概率陈述有什么联系,条件概率如何表达已知信息,不确定性怎样影响判断。微积分帮助我们调整参数,概率帮助我们描述和检验模型面对未知样本时的判断。