1 框架帮你省掉什么
假设你拿到乳腺肿瘤检查数据,希望根据半径、纹理、周长等数值特征,区分恶性与良性。任务并不是“调用神经网络就结束”:你需要明确标签、划分样本、处理不同量纲、训练参数,再检查漏判与误判。PyTorch 负责其中重复而容易写错的计算工作,包括张量运算、梯度计算、参数管理和设备迁移。数据是否泄漏、指标是否合适、实验是否回答了业务问题,仍然需要你判断。
本课使用公开的 Wisconsin Diagnostic Breast Cancer 数据集,通过 scikit-learn 内置接口读取。它包含 569 个样本、30 个数值特征,原始标签中 0 表示恶性、1 表示良性。我们把恶性重新编码为正类 1,便于把 recall 解释为“实际恶性样本中被识别出的比例”。这是学习实验,数据规模与来源都不足以支持现实诊断决策。先写清正类含义,比看到指标后再解释更可靠。
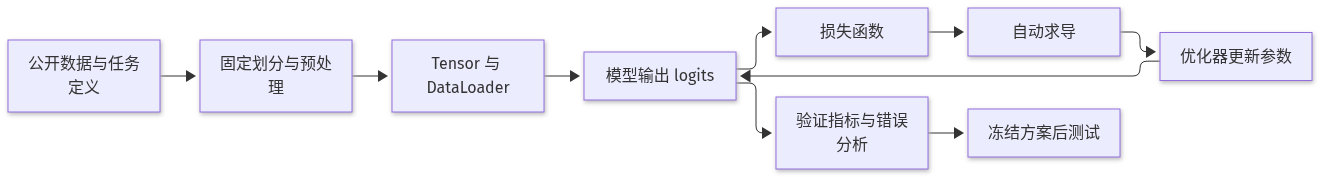
如果手写训练过程,你不仅要算预测值与损失,还要推导每层参数的偏导数,并维护更新后的参数。自动求导能够根据实际执行的运算建立计算图,沿着这张图计算梯度。你仍需选择模型结构和损失函数,但不必为每次改动重新手写完整导数。这使小步实验成为可能:先建立线性分类基线,再尝试带隐藏层的网络,比较验证集结果是否真的改善。
框架没有替你定义“好模型”。在客户流失任务中,把所有用户预测为不流失,可能获得很高的准确率,却完全找不到即将流失的用户。在图片分类中,同 1 个对象的近似照片如果分散到训练集和测试集,测试结果可能过于乐观。短文本分类也会出现重复句子、模板词和时间变化。学框架时要同时学会检查数据边界,否则计算正确也可能得出错误结论。
入门阶段先掌握完整的实验闭环:输入是什么,输出代表什么,如何得到损失,参数如何更新,结果怎样验证,以及如何保存。暂时不展开分布式训练、编译优化和复杂算子内部实现。对小型表格问题,树模型等传统方法也值得作为基线;采用 PyTorch 的学习价值,在于理解同样的训练骨架如何迁移到图像与文本模型,而不是保证神经网络在每个任务上都获胜。
2 Tensor、设备与自动求导
Tensor 可以先理解为带有形状、数据类型和设备位置的多维数组。单个样本的 30 个特征可以写成形状 [30];把 32 个样本组成批次,输入形状就是 [32, 30]。本课模型给每个样本输出 2 个类别分数,所以输出形状为 [32, 2]。标签保存为 [32],每个元素是 0 或 1。写下这些形状,常常比反复猜测某个维度为什么报错更有效。
数值特征通常转成 float32,交叉熵接收的类别索引通常使用 int64,也就是 PyTorch 的 long 类型。模型的输出叫 logits,是未经 softmax 转换的实数分数。CrossEntropyLoss 内部已经包含适合分类的对数概率计算,因此训练时直接传入 logits;提前 softmax 会改变损失接收的输入,容易让训练行为偏离预期。展示概率时,才对 logits 做 softmax,并读取正类对应的列。
设备说明张量放在哪里计算。cpu 表示主机处理器,cuda 表示通过 CUDA 使用受支持的 GPU。模型参数与参与同次计算的输入通常必须处于兼容设备上。x.to(device) 返回迁移后的张量,要写成 x = x.to(device);只调用而丢弃返回值,不会修改变量 x 的绑定。模型则通过 model.to(device) 迁移其参数与缓冲区。不要根据机器装有显卡,就认定当前 Python 环境可以使用它。
自动求导追踪需要梯度的张量参与的运算。模型参数默认需要梯度,普通输入通常不需要。前向计算得到 loss 后,loss.backward() 把梯度写入参数的 grad 属性;这时参数数值尚未更新。调用优化器的 step() 才执行更新。梯度默认会累积,因此每个普通训练批次前要清空旧梯度。先把“计算梯度”和“改变参数”分开理解,再看训练循环就会清楚许多。
import torch

w = torch.tensor(2.0, requires_grad=True)
loss = (w * 3 - 1) ** 2
loss.backward()
print(w.grad)  # tensor(30.)
这里预测值为 6,与目标 1 的差为 5,平方损失为 25;梯度为 2 × 5 × 3,也就是 30。梯度告诉我们当前点附近损失怎样变化,并不保证任意更新幅度都会改进结果。学习率过大仍可能越过合适区域。这个例子只为建立直觉,不需要在入门阶段掌握所有求导细节。
3 Dataset / DataLoader 与训练循环骨架
Dataset 定义如何按索引取得样本,DataLoader 负责把样本组成批次,并按配置打乱或顺序读取。表格数据已经在内存中时,可以直接使用 TensorDataset 包装输入和标签。图片任务的 Dataset 往往需要按路径读取文件并做变换;文本任务则需要把句子转换成模型可接收的数字表示。变化的是取样与预处理方式,模型、损失和优化器之间的基本关系仍然相同。
batch size 是每次更新使用的样本数,epoch 是训练集被完整遍历的轮次。569 个样本划分后,训练集不足 569;batch size 为 32 时,末尾批次可能小于 32,所以代码不能把批次维度写死。训练集通常启用 shuffle,让批次顺序变化;验证集与测试集通常不打乱,便于核对样本。打乱不等于重新划分数据,更不能把验证样本混进训练集一起更新参数。
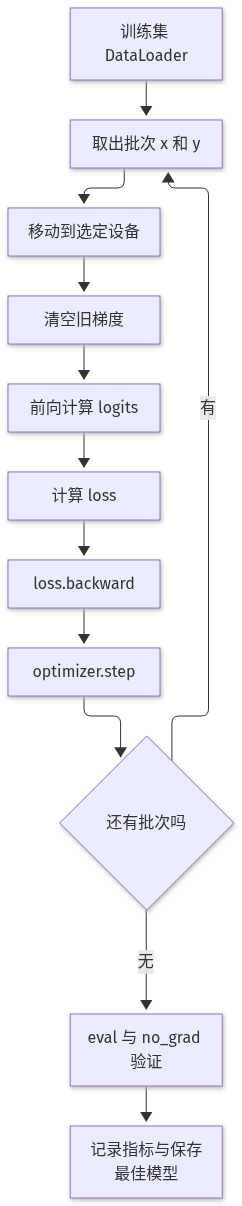
每个训练批次依次执行清梯度、前向、算损失、反向和更新。每轮结束后切换到验证阶段,只测量泛化表现。训练损失下降说明模型越来越适应训练样本,并不自动说明它能处理新样本。若训练损失继续下降而验证损失上升,可能已经过拟合;若两者都没有改善,应先检查数据、标签、损失和更新是否正常,再考虑增加网络规模。
统计平均损失时,需要考虑批次大小。默认交叉熵返回当前批次的平均值;先乘当前批次样本数,累计后再除以总样本数,才能避免末尾小批次被过度加权。指标也应在完整验证集上汇总后计算。直接平均每批 F1 通常不等于整体 F1,因为 F1 是基于累计 TP、FP、FN 的非线性比值。记录时同时保留样本数,可以更快发现漏跑了部分数据。
初次实验把 DataLoader 的 num_workers 设为 0,先得到可理解的正确流程。更多加载进程、锁页内存等选项可能改善某些任务,也可能增加开销;没有测量之前,不应把它们当成固定加速配方。对于本课的小数据集,CPU 完全可以完成练习,GPU 的意义主要是让你认识设备路径,并为后续更大模型准备检查方法。
可以先从训练加载器取出 1 批,核对它实际交给模型的内容:xb, yb = next(iter(train_loader))。本课应看到 xb 的形状为 [32, 30]、类型为 float32,yb 的形状为 [32]、类型为 long。再检查 torch.isfinite(xb).all() 与标签取值,能在反向传播之前发现缺失值或错误编码。Dataset 中同个索引返回的特征与标签必须属于同个样本;若分别打乱特征数组和标签数组,形状检查仍会通过,但模型学到的是错误配对。应通过样本索引一起取出二者。
批次维度还决定损失怎样解释。对 [32, 2] 的 logits,argmax(dim=1) 才是逐个样本选类别;沿 dim=0 操作会变成逐个类别在 32 个样本中找最大值。不要为了消除形状报错,随手把标签改成 [32, 1] 或复制成 [32, 2]。本课使用类别索引形式的交叉熵,要求每个样本对应 1 个整数标签。遇到维度错误时,先写清每个轴的含义,再决定应在哪里调整。
理解更新次数也有助于比较实验。本课划分后有 341 个训练样本,batch size 为 32 时,每轮包含 10 个完整批次和 1 个含 21 个样本的批次,共执行 11 次参数更新。若改成 64,每轮只有 6 次更新;即使轮次相同,优化过程也已改变。默认保留末尾批次;设置 drop_last=True 会让每轮少用部分样本,小数据练习通常没有必要这样做。比较不同批次大小时,应同时记录轮次、更新次数与验证结果。
还可以用参数变化确认训练骨架确实工作:在 1 次更新前,用 model[0].weight.detach().clone() 留下首层权重副本;反向后检查该层 grad 是否存在且数值有限,step 后再比较权重差异。若梯度存在但权重始终不变,应核对优化器是否持有当前模型的参数、是否漏掉 step,以及学习率是否为 0。仅看到 loss 被成功打印,不能证明参数已经更新。这个小检查应放在诊断阶段,确认流程后再恢复正常训练日志。
4 动手:用 PyTorch 复现小分类器
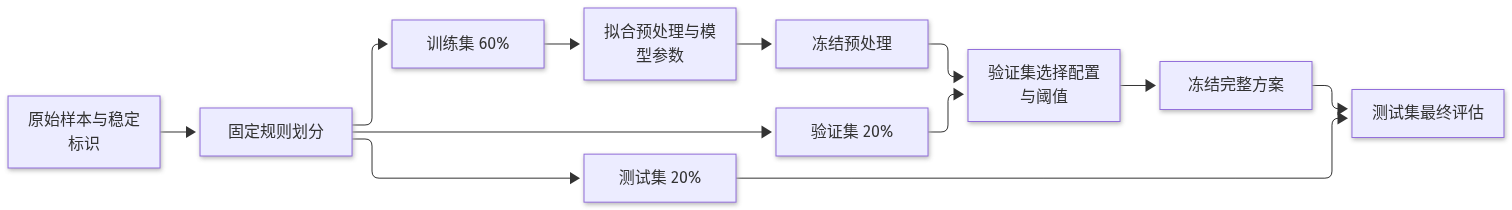
下面的程序可按代码块顺序放进同 1 个脚本运行,需要安装 torch 与 scikit-learn。先划分数据,再拟合预处理。我们采用约 60% 训练、20% 验证、20% 测试的分层随机划分,使各部分尽量保持类别比例。数据总数不能被比例整除,实际数量由划分函数决定。标准化只在训练集上计算均值和标准差,再把相同变换应用到验证与测试集,避免提前使用评估数据的信息。
import random
import numpy as np
import torch
from torch import nn
from torch.utils.data import TensorDataset, DataLoader
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import (
    precision_score, recall_score, f1_score,
    roc_auc_score, confusion_matrix,
)

seed = 42
random.seed(seed)
np.random.seed(seed)
torch.manual_seed(seed)
if torch.cuda.is_available():
    torch.cuda.manual_seed_all(seed)

data = load_breast_cancer()
X = data.data
y = (data.target == 0).astype(np.int64)
indices = np.arange(len(y))
train_idx, rest_idx = train_test_split(
    indices, test_size=0.4, stratify=y, random_state=seed
)
val_idx, test_idx = train_test_split(
    rest_idx, test_size=0.5, stratify=y[rest_idx],
    random_state=seed,
)
scaler = StandardScaler().fit(X[train_idx])

def make_dataset(idx):
    features = torch.tensor(
        scaler.transform(X[idx]), dtype=torch.float32
    )
    labels = torch.tensor(y[idx], dtype=torch.long)
    return TensorDataset(features, labels)

generator = torch.Generator().manual_seed(seed)
train_loader = DataLoader(
    make_dataset(train_idx), batch_size=32,
    shuffle=True, generator=generator, num_workers=0,
)
val_loader = DataLoader(make_dataset(val_idx), batch_size=128)
test_loader = DataLoader(make_dataset(test_idx), batch_size=128)

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = nn.Sequential(
    nn.Linear(30, 16),
    nn.ReLU(),
    nn.Linear(16, 2),
).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
print("device:", device, "counts:",
      len(train_idx), len(val_idx), len(test_idx))
标准化使半径、面积等量纲不同的特征处于更相近的数值范围。隐藏层把 30 个输入变成 16 个中间数值,ReLU 引入非线性,最后输出 2 个类别分数。16 是教学配置,并非数据集的最优答案。固定这套结构运行成功后,再与只有 Linear(30, 2) 的基线比较,每次只改少量因素,才能解释改进来自哪里。
def evaluate(loader, threshold=0.5):
    model.eval()
    total_loss, count = 0.0, 0
    labels, probabilities = [], []
    with torch.no_grad():
        for xb, yb in loader:
            xb, yb = xb.to(device), yb.to(device)
            logits = model(xb)
            loss = criterion(logits, yb)
            total_loss += loss.item() * len(yb)
            count += len(yb)
            labels.extend(yb.cpu().tolist())
            probabilities.extend(
                logits.softmax(dim=1)[:, 1].cpu().tolist()
            )
    labels = np.asarray(labels)
    probabilities = np.asarray(probabilities)
    predictions = (probabilities >= threshold).astype(np.int64)
    return {
        "loss": total_loss / count,
        "precision": precision_score(labels, predictions, zero_division=0),
        "recall": recall_score(labels, predictions, zero_division=0),
        "f1": f1_score(labels, predictions, zero_division=0),
        "auc": roc_auc_score(labels, probabilities),
        "matrix": confusion_matrix(labels, predictions, labels=[0, 1]),
    }

import copy

best_loss = float("inf")
best_state = None
for epoch in range(1, 31):
    model.train()
    total_loss, count = 0.0, 0
    for xb, yb in train_loader:
        xb, yb = xb.to(device), yb.to(device)
        optimizer.zero_grad(set_to_none=True)
        logits = model(xb)
        loss = criterion(logits, yb)
        loss.backward()
        optimizer.step()
        total_loss += loss.item() * len(yb)
        count += len(yb)
    val = evaluate(val_loader)
    if val["loss"] < best_loss:
        best_loss = val["loss"]
        best_state = copy.deepcopy(model.state_dict())
    print(epoch, "train_loss", total_loss / count, "val", val)

model.load_state_dict(best_state)
test_result = evaluate(test_loader, threshold=0.5)
print("final_test", test_result)
这里用验证损失选择 30 轮中保存的状态,阈值固定为 0.5,最后只评估所选模型。不要根据 test_result 再调整学习率或轮次,然后继续把同个测试集当成新证据。如果确实反复参考了测试结果,它已经参与开发,需要另设独立评估数据。代码没有附上承诺分数,读者应记录自己的实际结果与运行环境,避免把偶然运行当作标准答案。
正类预测正确的数量为 TP,误报为 FP,漏报为 FN。precision=TP/(TP+FP),回答“预测为恶性的样本里有多少确实恶性”;recall=TP/(TP+FN),回答“实际恶性样本里找到了多少”。F1 综合这 2 个比例。AUC 在这里指 ROC AUC,使用连续正类分数评价排序能力,不能用已经变成 0 或 1 的预测替代概率。混淆矩阵行是真实标签、列是预测标签,顺序固定为 [0, 1]。
降低阈值可能提高 recall,也可能增加 FP。若要选择阈值,应在验证集上依据任务代价确定规则,再冻结用于测试。代码中的 zero_division=0 是明确的统计约定;出现没有正类预测时,要同时报告对应计数,不能只看 0 分而忽略模型行为。真实类别严重不平衡时,准确率与 ROC AUC 都可能不足以表达使用效果,还应看正类数量、precision、recall,以及必要时的 PR 曲线。
5 保存、加载与可复现实验
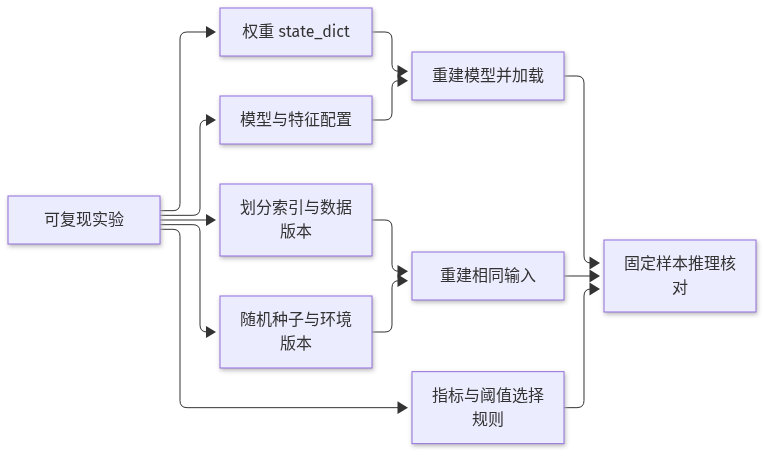
保存权重只是保存实验的部分结果。重建预测至少还需要模型结构、特征顺序、标签映射、标准化参数与阈值。假设训练时第 1 列是平均半径,推理时却把平均纹理放进第 1 列,即使张量形状完全正确,模型也会接收到错误含义。保存有序特征名并在加载时核对,比依赖口头约定可靠。数据划分索引也要保留,否则下次得到的验证分数可能来自另一批样本。
checkpoint = {
    "state_dict": {k: v.detach().cpu().clone()
                   for k, v in model.state_dict().items()},
    "input_dim": 30,
    "hidden_dim": 16,
    "feature_names": data.feature_names.tolist(),
    "positive_label": "malignant",
    "mean": scaler.mean_.tolist(),
    "scale": scaler.scale_.tolist(),
    "threshold": 0.5,
    "seed": seed,
    "train_idx": train_idx.tolist(),
    "val_idx": val_idx.tolist(),
    "test_idx": test_idx.tolist(),
}
torch.save(checkpoint, "a19-checkpoint.pt")

saved = torch.load("a19-checkpoint.pt", map_location="cpu", weights_only=True)
restored = nn.Sequential(
    nn.Linear(saved["input_dim"], saved["hidden_dim"]),
    nn.ReLU(),
    nn.Linear(saved["hidden_dim"], 2),
)
restored.load_state_dict(saved["state_dict"])
restored.eval()
raw = X[test_idx[:3]]
normalized = (raw - np.asarray(saved["mean"])) / np.asarray(saved["scale"])
with torch.no_grad():
    probability = restored(
        torch.tensor(normalized, dtype=torch.float32)
    ).softmax(dim=1)[:, 1]
print(probability)
这个文件适合恢复推理;若要中断后继续训练,还要保存优化器状态、当前轮次、随机数状态以及相关采样状态。否则即使权重相同,后续更新路径也可能不同。加载来自不可信来源的序列化文件存在风险,应只使用可信文件,并优先使用当前版本支持的受限权重加载方式。模型结构仍由代码明确创建,文件里的配置不应变成任意代码执行入口。
固定随机种子能减少无关差异,但不同设备、库版本和某些算子仍可能产生差异。记录 Python、PyTorch、scikit-learn 版本、设备名称、代码版本和数据来源;严格复现实验时再评估确定性选项及其限制。小数据集的单次划分也有波动,比较模型应使用同样的划分,并在验证阶段检查多个种子或交叉验证。测试集保持独立,不应因某个种子测试分数高就选中它。
6 常见坑:断图、eval/train 模式、设备不一致
断图是指你在需要求梯度的路径上切断了计算关系。比如把 loss 转成 Python 数字后,再包装成新张量调用 backward,新张量已经不知道原来的模型参数。detach() 也会生成不追踪原计算历史的视图;它适合记录或导出结果,但不能随意插在模型输出与训练损失之间。日志可使用 loss.item(),反向仍应针对原来的 loss。若报出张量不需要梯度,先检查这些边界,而不是给所有张量强行设置 requires_grad。
另一个容易忽视的问题是记录张量。若每批直接把带计算图的 loss 存入列表,可能保留不再需要的计算关系并增加内存占用。记录标量使用 item,记录预测使用 detach 后移到 CPU。它们用于观察,训练路径则保留原张量。观察与训练使用同个数值的不同表示并不矛盾,关键是知道哪条路径需要梯度。
model.train() 与 model.eval() 控制某些层的行为,例如 Dropout 的随机丢弃和 BatchNorm 的统计使用方式。eval 不会自动关闭自动求导,no_grad 也不会替你切换模型模式,验证时通常同时需要两者。本课网络没有这些层,因此忘记切模式可能暂时看不出差异;这不表示约定可以省略。以后加入 Dropout,再用错误模式验证,指标可能在相同输入上反复变化。
设备错误常见于模型已经在 GPU,而标签仍在 CPU;也可能是前向里临时创建的张量默认落在 CPU。检查输入、标签、参数和临时张量的 device。创建辅助张量时可使用输入的 device,或使用 zeros_like 等保留设备信息的接口。不要把每处报错都机械地加上 cuda 调用;应让模型和批次遵循同个显式 device,CPU 路径才不会因此失效。
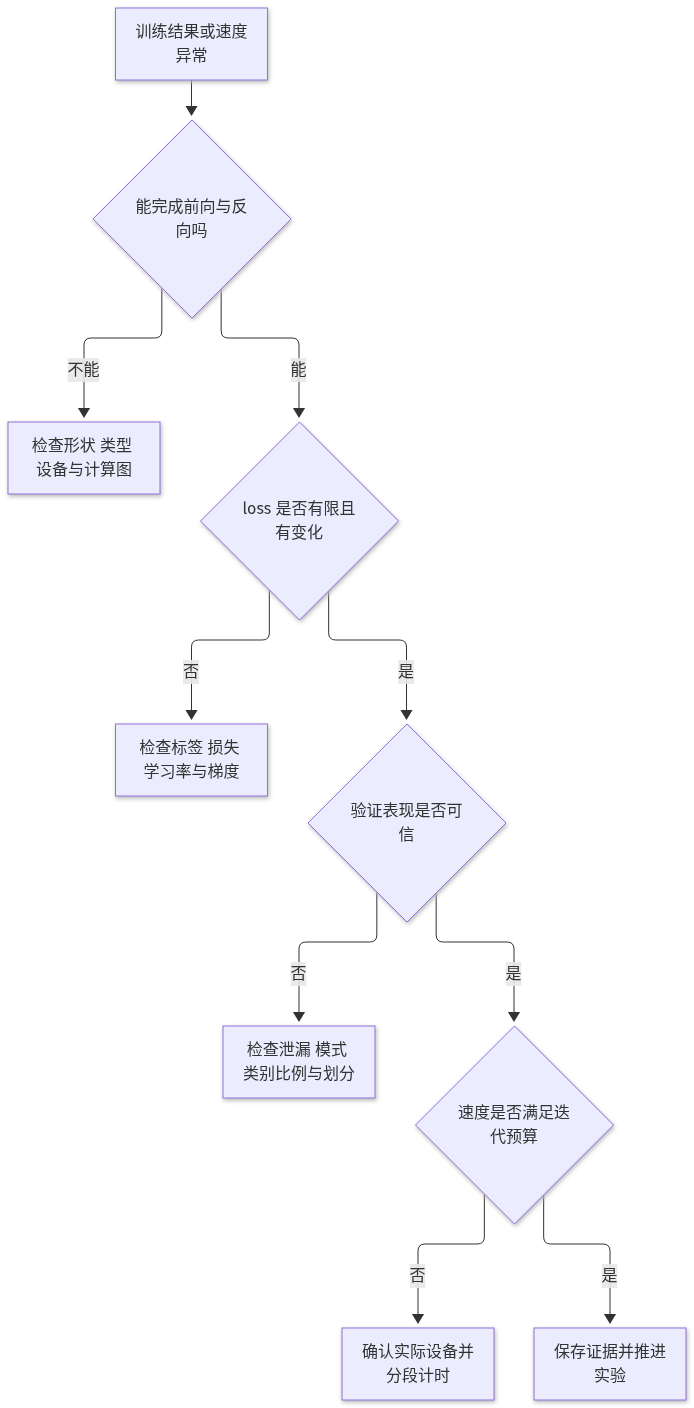
若程序运行却效果异常,先用极小训练子集检查模型是否有能力拟合,再排查标签方向、输入缺失值、学习率与梯度。这个检查只用于诊断,不能用该子集训练分数代替泛化指标。若验证分数高得异常,检查重复样本和泄漏:流失预测不能使用注销后产生的字段;文本不能把标签名称拼进输入;患者级数据不能把同个患者的记录随机分散到训练与测试中。
7 案例:静默 CPU 训练拖垮迭代
设想团队把同样的训练骨架迁移到公开图像分类数据,准备比较 6 组配置。脚本没有报错,loss 也下降,但每轮耗时远超预算。开发者于是减少轮次,用尚未收敛的结果淘汰配置。问题看起来是模型效果不佳,实际还混入了迭代时间不足。以下是教学案例,不代表任何真实硬件的性能记录;它说明运行位置可以通过实验管理间接影响结论。
旧代码使用 cuda if available else cpu,运行环境无法使用 CUDA,于是模型和输入一起落到 CPU。因为两者设备一致,PyTorch 没有理由报设备冲突。日志只记录 loss,没有记录实际设备,团队把“机器有 GPU”当成了“本进程在用 GPU”。GPU 活动较低可以作为线索,但不足以证明根因;小模型、读取等待或采样时机也可能让 GPU 看起来空闲。
排查先打印 CUDA 可用性、选定 device、模型参数设备以及首批输入设备。若都在 CPU,再检查当前解释器使用的 PyTorch 构建、运行环境对 GPU 的可见性和兼容性。若已经在 GPU,则分开测量读数据、传输、前向与反向,不能把所有慢速都归咎于设备选择。GPU 操作可能异步提交,测量 GPU 阶段时需要在计时边界同步,或使用适当的 GPU 计时工具;否则记录到的可能主要是提交工作所需时间。
修复后,用相同数据、批次大小、模型和训练轮次比较,先预热再计时,同时保留验证指标。样本吞吐变快而结果发生大幅异常,仍然不能宣布成功,应检查配置是否同时改变。对于很小的表格模型,传输和启动开销可能抵消 GPU 收益,因此不应承诺迁移后必然加速。案例真正需要的结果,是实际设备符合约定,并且训练完成时间有可解释的测量证据。
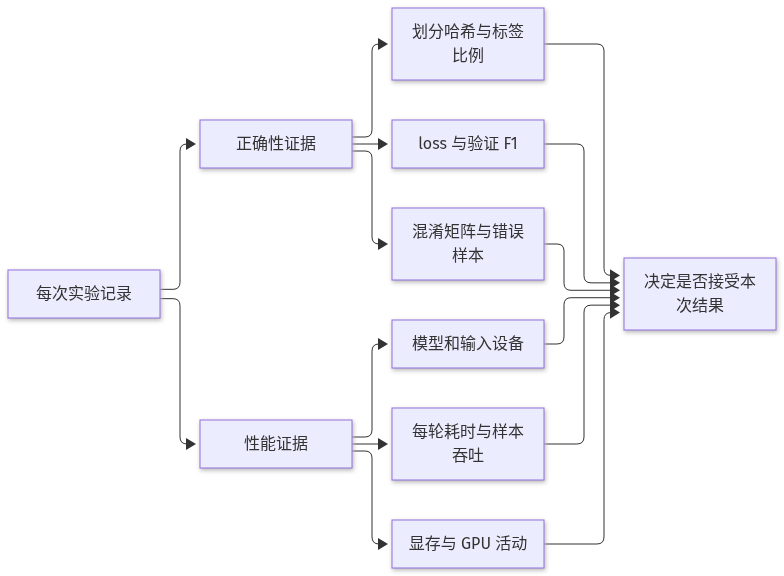
最终把设备意图分成明确策略:本地练习允许 CPU,则启动时打印选择与原因;计划必须用 GPU 的实验,若不可用就立即失败。这样不需要等 6 组任务完成才发现回退。性能记录至少包括总样本数、轮次、每轮耗时、吞吐、设备和批次大小。显存占用可以辅助解释资源需求,但显存已分配不等于持续有效计算,仍需结合时间与吞吐判断。
8 把训练脚本约定写进仓库规范
把能够重复执行的实验变成仓库约定,比要求每位成员记住所有坑更有效。数据规范应说明来源、版本、样本标识、正类含义、特征顺序和划分方法。随机划分适合本课练习;若真实问题要预测未来流失,应考虑按时间划分;若同个用户或患者有多条记录,应考虑按实体分组。划分方法服务于将来怎样使用模型,不能只选择分数最高的方式。
配置应显式保存 batch size、学习率、轮次、模型结构、种子、设备要求和模型选择规则。每次运行建立独立目录,放入配置、环境信息、日志、最佳权重和评估报告。运行名可以包含日期与简短配置,但日期不能代替内容;需要能够从记录还原实际执行了什么。训练脚本默认不得读取测试集指标来选择最佳模型,评估入口再加载冻结后的完整方案。
日志不必铺满每个中间张量,至少要让人回答:读了多少样本,正类比例多少,模型与输入在哪里,每轮是否完成,训练和验证损失怎样变化,最终按什么规则选择权重。运行前检查特征数、标签范围和数值是否有限;评估时保存混淆矩阵,并抽查错误样本。AUC 要求评估数据含有可比较的正负类,缺少某个类别时应报告不可计算,不能编造正常分数。
代码评审可以围绕具体失败提出要求:预处理是否仅拟合训练集,验证是否使用 eval 与 no_grad,梯度是否按批次清空,最佳状态是否复制保存,加载后是否能复现固定样本的预测。文件成功写出并不能证明加载流程正确;应在独立进程里重建模型与预处理,并核对输出。这样的检查直接保护实验结果,比只检查文件名是否符合格式更有价值。
还要给失败留下可理解的出口。出现 NaN 损失时停止并记录轮次与输入摘要;要求 GPU 却不可用时报告环境证据;没有正类预测时输出计数与指标约定。对类别不平衡,可以在训练集上尝试类别权重或采样策略,但验证与测试应保留目标分布。不能在划分前复制少数类样本,再让副本进入不同集合,那会把“改善类别比例”变成新的数据泄漏。
9 从小模型走向大模型体验(A20)
走向大模型之前,先确认自己能够解释小模型的全部路径:原始输入怎样变成 Tensor,输出维度怎样对应标签,训练时哪些对象更新,评估时哪些状态冻结,以及权重加载后怎样恢复相同输入含义。这些问题在大模型中仍然存在,只是文本输入通常要先经过 tokenizer,模型输出可能是每个位置的词元分数,推理还要控制生成长度与其他参数。

小分类器从随机参数开始训练;大模型初体验通常从加载已有的预训练权重并完成推理开始。先观察它对固定任务的输出,再考虑是否需要微调。不能把演示中回答流畅等同于任务正确,也不能直接把生成文本套用本课的分类 AUC。短文本分类若仍有明确标签,可以继续使用 precision、recall、F1;开放式生成则需要任务标准、参考答案与人工检查等合适的评估方式。
路径上先准备 GPU,是为了理解模型是否装得下、运行多快以及资源为何随输入变化。检查运行环境支持、可用显存、权重规模与输入长度,先跑最小推理样例,再扩大批次或文本长度。显存中不只有权重,还可能有输入、中间结果和生成时的缓存;训练还需要梯度与优化器状态,因此“推理能跑”不等于“同样设备能够训练”。这些内部构成将在后续逐步展开。
分布变化同样会跟随你进入下一课。当前数据上的好结果,不能保证对新医院设备、新图片风格或新出现的网络用语仍然有效。需要记录数据来源,并保留来自目标场景的评估样本。看到分数下降时,先区分输入分布变了、标签定义变了,还是实现出了问题。框架提供统一的计算接口,可靠实验则需要你持续维护输入、证据和决策之间的关系。
放进方案里
在方案中把 PyTorch 写成可执行的实验路线:使用公开乳腺肿瘤数据建立教学分类器,以恶性为正类,输入为 30 个数值特征,输出为正类概率。说明这项实验用于验证训练、评估与保存流程,不用于现实诊断。约 60% 数据训练、20% 验证、20% 测试,采用固定的分层划分,保存样本索引。标准化仅拟合训练集,并把特征顺序、均值与标准差随模型保存。
先运行线性基线,再运行 16 个隐藏单元的小网络,保持相同划分与评估方式。验证集负责选择配置与权重;若调整分类阈值,也只使用验证集。测试集用于冻结方案后的最终评估,同时报告 precision、recall、F1、ROC AUC、混淆矩阵和样本数。针对漏判代价解释 recall,针对误报负担解释 precision,不承诺单次运行能够达到某个分数。
资源计划写明实际设备、批次大小、训练轮次与耗时记录方法。本地练习允许 CPU;指定 GPU 的运行必须检查可用性,不能静默回退。交付物包含脚本、环境版本、配置、划分记录、最佳权重和独立加载示例。验收时在新进程恢复预处理与模型,核对固定样本概率,并确认验证阶段没有更新参数。
加载验收保留固定样本索引、保存前后的正类概率与最大绝对误差;同设备比较时预先约定容差,例如 0.000001。另核对阈值两侧样本的类别结果,若不一致,检查预处理、权重与阈值是否配套,不能只凭文件可读取就通过验收。
风险部分聚焦可检查的失效:重复样本跨集合导致泄漏,类别不平衡掩盖漏判,目标人群变化导致分布偏移。分别要求样本去重与分组检查、分类计数与分项指标、目标场景数据评估。若这些证据不足,先补充数据与验证,再扩大模型。这样后续进入大模型体验时,仍能沿用输入定义、设备检查、冻结评估和结果追溯这套约定。
10 小结:下一步大模型初体验(路径上先 GPU)
PyTorch 把张量计算、自动求导和参数更新组织成可重复的训练过程。Dataset 与 DataLoader 提供样本,模型输出 logits,损失衡量误差,backward 计算梯度,优化器执行更新;验证阶段切换模式并停止记录梯度。数据边界、指标含义与实验记录共同决定结果是否可信。
进入 A20 前,尝试口头回答:为什么标准化不能先看完整数据?为什么 backward 后参数还没改变?为什么 eval 仍需配合 no_grad?为什么机器有 GPU 却可能全程使用 CPU?能用代码与日志回答这些问题后,再准备 GPU 环境,加载预训练模型完成最小推理,把本课的可复现实验习惯带过去。