机器学习让计算机从样本中形成可用于新样本的规则。判断它是否有用,不能只看模型能否记住已有答案,还要看它面对未见数据时,能否在明确的成本和约束下做出可靠判断。本课围绕客户流失预测展开,并用公开图像、短文本任务对照。读完后,你应能解释任务类型、模型如何学习、为什么需要独立评估,以及怎样用简单基线检验复杂方案。
1 机器学习问题地图:监督 / 无监督 / 强化学习边界
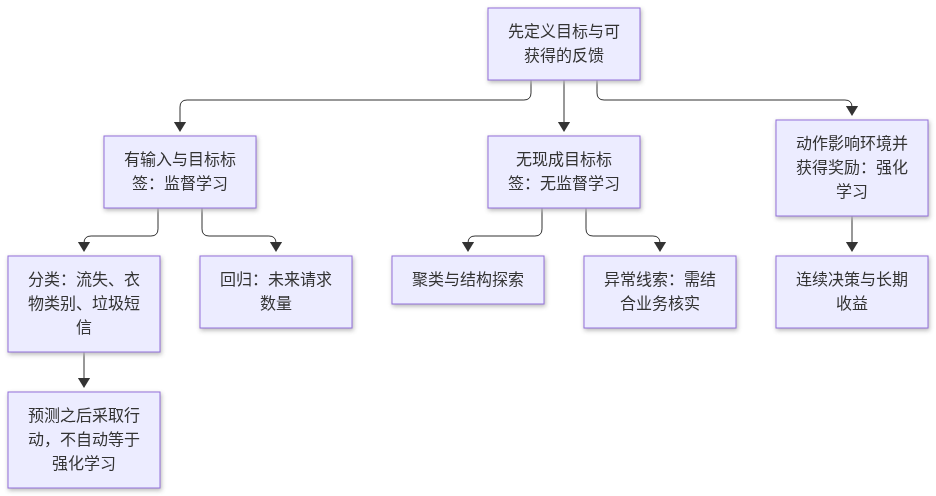
设想服务团队希望提前联系可能流失的客户。输入可以是客户在某个观察日之前的在网月数、月费用、合同类型和历史故障次数,输出是未来 30 天是否流失。过去客户的后续结果提供了标签;利用输入与标签学习映射,属于监督学习。这里真正的问题不是“选什么算法”,而是“在什么时候,依据当时可见的信息,预测什么结果”。如果这句话不清楚,训练代码再完整也可能解错题。
监督学习中的分类预测离散类别,例如流失或留存、衣物属于哪个类别、短信是否为垃圾信息。回归预测数值,例如下个月服务请求数量。分类模型往往先输出分数,再按阈值给出类别。分数 0.8 不能自动解释为准确的 80% 概率;是否能这样解释,还需要专门检查。任务类型由目标决定,不由输入形态决定。表格、图像、文本都可以用于分类,也都可能用于其他目标。
无监督学习没有现成的目标标签,重点是描述数据结构。例如按使用行为把客户聚成若干组,或把高维特征压缩成便于观察的表示。“聚成 4 组”并不代表发现了 4 类真实人群,分组会受距离定义、尺度和算法选择影响。聚类结果可以帮助探索,却不能直接证明某组必然会流失。异常检测也需要谨慎:罕见样本可能是错误记录,也可能是合理的新行为,异常程度不等于业务危害。
强化学习处理连续决策:智能体采取动作,环境返回新状态与奖励,当前动作还可能影响未来机会。例如模拟环境中的移动机器人需要比较不同路径的长期收益。这与读取历史客户记录、预测流失标签存在区别。把预测结果交给人员采取行动,并不会让整个分类任务自动成为强化学习;只有明确动作、反馈、长期目标以及交互条件后,才适合讨论这种框架。本课只建立边界,不展开其算法。
公开数据有助于把这些边界具体化。UCI 的 Bank Marketing 数据可用于预测客户是否订阅定期存款,Fashion-MNIST 用于衣物图像分类,UCI 的 SMS Spam Collection 用于短文本分类。它们便于复现实验,但数据采集时期、样本群体和标签含义都有范围。练习数据上的成绩只回答该数据划分中的问题,不能直接证明模型适用于现在的所有客户、照片或短信。
2 假设空间、归纳偏置与模型族
模型不是从空白中“理解世界”,而是在允许的规则集合中寻找可用规则。这个集合称为假设空间。假设只允许用月费用与在网月数的加权和判断流失,那么所有可能的权重与截距就形成了该模型的假设空间。允许按“合同类型是否为月付”分支,再按费用分支,就得到不同形状的规则集合。训练集相同,允许的规则不同,最后学到的判断也可能不同。
归纳偏置是模型和学习过程对某些解释的偏好。线性模型偏好由特征贡献相加形成的关系;浅决策树偏好少量条件分支。偏好并非缺陷,而是从有限样本推广到新样本所必需的约束。仅凭已观察的客户,无法确定所有未来客户的答案;模型必须带着某种假设补足未知。适合任务的偏好能够减少数据需求,错误的偏好则会持续遗漏重要关系。
例如,逻辑回归虽然名称中有“回归”,常用于二分类。它将特征的加权和转成 0 到 1 之间的分数,适合作为表格分类基线。浅决策树能够表达“月付合同且费用较高”这样的组合条件,也较容易展示判断路径。这里的比较不是给模型族排永久名次:真实关系、样本规模、噪声、特征处理和部署约束都会改变结果。模型族只是候选规则的组织方式。
特征表示也包含偏好。合同类型没有自然的大小顺序,不能随意编码成 1、2、3 后让模型把相邻数字理解为相似。可以用独热编码,为每个类别建立指示列。月费用与在网月数的量纲不同,某些模型需要标准化。图像可以先以像素作为输入,文本可以先以词频作为输入;这些简单表示各有局限,却能为后续改进建立参照。本课不展开卷积、注意力等内部机制。
容量描述模型能表达多复杂的关系,不能简单等同于参数数量或文件大小。更深的树通常能切出更细的区域,也更容易记住偶然样本。更多特征也不必然增加有效信息,重复列、噪声列和泄漏列可能让评估更脆弱。选择模型时,应同时记录可表达的关系、数据要求、推理时间和解释方式。可训练只是起点,能稳定解决目标问题才是选择依据。
3 训练循环:数据 → 损失 → 更新 → 评估
训练循环可以拆成明确步骤:准备输入与标签,产生预测,计算损失,更新模型,再检查未参与拟合的数据。损失是训练时使用的误差信号。例如二分类常用对数损失,它会对自信而错误的预测给出较大惩罚。准确率、F1 或 AUC 则是评估视角,不一定就是训练直接优化的量。损失下降说明当前优化目标改善,不能单独证明实际业务效果改善。
“更新”也不限定为某种公式。逻辑回归可以逐步调整权重,使损失降低;决策树则通过选择特征与切分条件构建分支。它们都从数据中选规则,但训练过程不同。训练轮数、树的最大深度、正则化强度等通常是超参数,由实验设计来选择;权重、分支阈值等通常由训练数据学习。把这 2 类选择分开,才能看清哪些数据参与了什么决定。
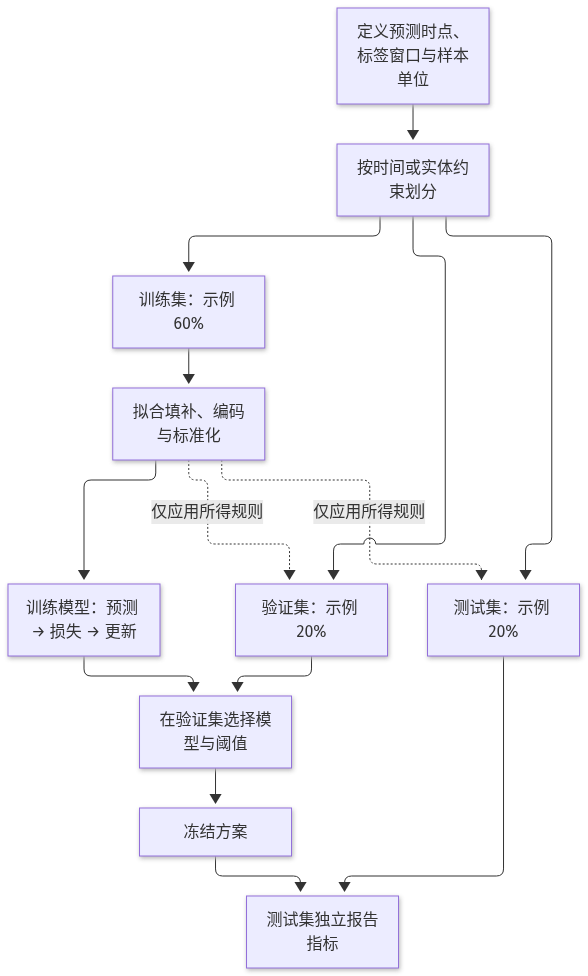
常见做法是将数据划为训练集、验证集、测试集,例如 60%、20%、20%。训练集拟合参数,验证集选择候选方案与阈值,测试集用于最终独立评估。这个比例只是起点,还要看样本量与业务时序。同一客户的多条记录应按客户分组,预测未来则应优先按时间划分。随机拆行如果让同一实体或未来信息跨越边界,测试分数就可能失去意义。
预处理同样必须遵守边界。缺失值填补使用的中位数、标准化的均值和尺度、文本词表,都应只在训练集上拟合,再应用于验证集与测试集。先用全部数据处理再切分,会把留出数据的统计信息带进训练流程。即使没有直接使用标签,也可能形成不符合实际使用条件的信息通道。将处理步骤与模型放进同一流水线,可以减少这种操作失误。
评估分类模型先要确定哪个类别是正类。若把流失设为正类,真正例 TP 是被识别出的流失客户,假正例 FP 是被误报的留存客户,假负例 FN 是漏掉的流失客户,真负例 TN 是正确识别的留存客户。精确率 precision = TP / (TP + FP),回答提醒名单有多准;召回率 recall = TP / (TP + FN),回答实际流失者找回多少。分母为 0 时应明确报告约定,不能把无定义结果默默当成完美成绩。
F1 = 2 × precision × recall / (precision + recall),综合考察精确率与召回率,忽略真负例。ROC-AUC 衡量跨阈值的排序区分能力,可以理解为随机抽取正、负样本时,正样本获得更高分数的能力,并对并列分数作相应处理。它不直接给出某个联系名单的效果。少数类很稀少时,还应看 PR 曲线或 PR-AUC;很高的 ROC-AUC 仍可能伴随大量误报。任何单个指标都不能代替成本判断。
4 动手:同一数据上对比 2 个简单模型
下面用 Bank Marketing 的 bank-full.csv 设计可复现实验。目标 y 表示是否订阅定期存款,正类为 yes;这与流失预测都是表格二分类,但业务含义不同,报告时必须写清。先使用 age、balance、campaign、job、education、housing、loan、contact 等字段。排除 duration,因为它表示本次通话时长,在拨打电话前不可知。保留它会让练习悄悄变成“通话结束后判断结果”,偏离预期使用时点。
实验对比带正则化的逻辑回归与最大深度为 4 的决策树。再加上“始终预测为负类”的朴素参照,用来揭示准确率的局限。下面代码是实验骨架,要求本地已有公开文件及 pandas、scikit-learn。这里使用分层随机划分演示公平比较;该文件缺乏足以重建完整部署时间线的信息,因此这份结果不能替代上线前的时间外验证,也不应被包装成未来营销效果的保证。
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.dummy import DummyClassifier
from sklearn.metrics import precision_score, recall_score, f1_score, roc_auc_score

df = pd.read_csv("bank-full.csv", sep=";")
num = ["age", "balance", "campaign"]
cat = ["job", "education", "housing", "loan", "contact"]
X = df[num + cat]
y = df["y"].eq("yes").astype(int)
X_dev, X_test, y_dev, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42)
X_train, X_val, y_train, y_val = train_test_split(
    X_dev, y_dev, test_size=0.25, stratify=y_dev, random_state=42)

def make_pipeline(model):
    numeric = Pipeline([("fill", SimpleImputer(strategy="median")),
                        ("scale", StandardScaler())])
    categorical = Pipeline([
        ("fill", SimpleImputer(strategy="most_frequent")),
        ("encode", OneHotEncoder(handle_unknown="ignore"))])
    prep = ColumnTransformer([("num", numeric, num),
                              ("cat", categorical, cat)])
    return Pipeline([("prep", prep), ("model", model)])

models = {
    "dummy": DummyClassifier(strategy="most_frequent"),
    "logistic": LogisticRegression(max_iter=2000, random_state=42),
    "tree": DecisionTreeClassifier(max_depth=4, random_state=42),
}
fitted, validation = {}, {}
for name, model in models.items():
    pipe = make_pipeline(model).fit(X_train, y_train)
    score = pipe.predict_proba(X_val)[:, 1]
    pred = (score >= 0.5).astype(int)
    validation[name] = {
        "precision": precision_score(y_val, pred, zero_division=0),
        "recall": recall_score(y_val, pred, zero_division=0),
        "f1": f1_score(y_val, pred, zero_division=0),
        "auc": roc_auc_score(y_val, score),
    }
    fitted[name] = pipe
print(pd.DataFrame(validation).T)
# 依据预先约定的验证标准选择模型与阈值,然后才评估测试集。
这段代码得到的是验证集结果,没有预设哪个模型胜出,也没有声称已经执行。运行时应保存数据版本、依赖版本、切分种子、每组样本数和正类比例。若出现未收敛提示,应先处理再比较;若更换特征或调节深度,应在实验记录里增加候选项,不能把反复试验后的最好分数说成首次结果。固定随机种子便于复现,但不保证结论对其他样本划分仍然稳定。
建议在运行前写下选择标准,例如“在 precision 不低于 0.30 的候选中优先选择 recall 较高者”。这个数值只是练习约束,实际要由联系成本和收益确定。然后只在验证集扫描阈值,记录 precision、recall、F1 与 ROC-AUC。选定模型及阈值后,才在测试集报告相同指标及混淆矩阵。若没有候选满足约束,应报告不满足,不能看到测试结果后偷偷放宽标准。
比较的公平性来自共享条件:相同输入字段、相同划分、相同正类定义和评估口径。逻辑回归标准化后训练,树本身通常不依赖标准化,但使用相同流水线有助于减少实现差异。不要把训练时间、预测延迟或解释难度完全排除在选择之外。若 2 个模型效果接近,较易维护的模型常更适合成为起点;若差距明显,也要先检查差距是否来自泄漏或错误处理。
5 过拟合、欠拟合与容量控制
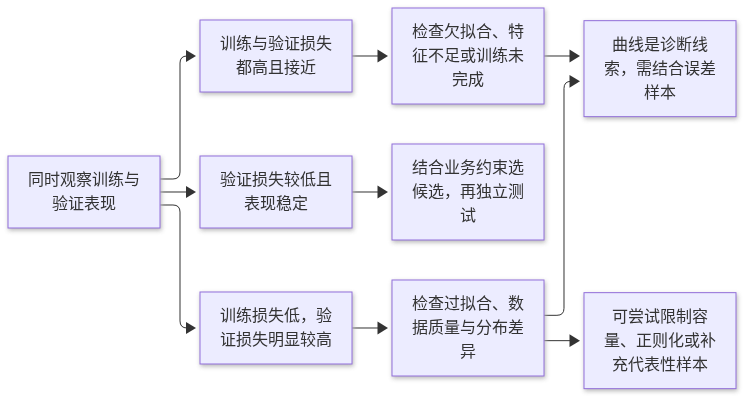
欠拟合是规则过于受限、特征不足或训练未完成,导致训练数据上的表现也不好。过拟合则是模型抓住训练样本的偶然细节,训练表现很好,验证表现却变差。例如深树可以为少数特殊客户增加很多分支,这些分支在训练集中似乎解释得通,在新客户上却不再成立。判断时需要同时看训练与验证表现,不能只看到验证分数低就断定一定是过拟合。
学习曲线帮助区分线索。随着训练样本增加,若训练与验证损失都偏高且接近,应检查特征、模型约束与优化是否足够;若训练损失很低、验证损失明显较高,可考虑降低容量、增加正则化或收集更有代表性的数据。这些都是诊断线索,不是自动处方。标签错误、重复样本、分布差异也可能制造类似图形,必须结合样本审查才能解释。
容量控制可以从限制树深、提高叶节点最少样本数、调整逻辑回归的正则化强度开始。正则化通过对某些复杂规则施加代价,减少模型对局部噪声的依赖。它可能略微降低训练成绩,却改善新样本表现。更多训练轮数不会无限提高泛化能力;训练损失继续下降时,验证损失可能已经回升。选择停止时点也属于模型选择,需要使用验证数据。
滑块展示的是教学用合成曲线:容量从低到高时,训练损失下降,验证损失先降后升。真实曲线可能不平滑,最优位置也随数据变化。把曲线当成理解工具,不能把其形状当成所有模型必须遵守的定律。尤其不能根据某个复杂度名称,直接断言某模型一定过拟合。有效证据应是受控实验中的表现差异与误差样本。
阈值调整与容量调整还解决不同问题。降低流失判定阈值,通常会扩大提醒名单,使召回率上升,同时可能引入更多误报;它没有重新学会新的特征关系,也不能修复数据泄漏。若只关心每天最多联系 100 人,可以评估分数最高的 100 人中的命中率,并说明覆盖率。指标应跟随实际决策方式,不能用漂亮的整体分数掩盖名单容量限制。
6 常见坑:先选酷模型再找问题
先决定使用复杂模型,再寻找能展示它的数据,容易让评估目标跟着结果移动。正确起点是决策问题:预测对象是谁、何时预测、标签怎样产生、错报与漏报各有什么代价。若团队只需要识别合同即将到期且尚未续约的客户,明确规则可能已经足够;若希望预测更早期风险,再检验机器学习能否提供增量。模型复杂度不能替代需求定义。
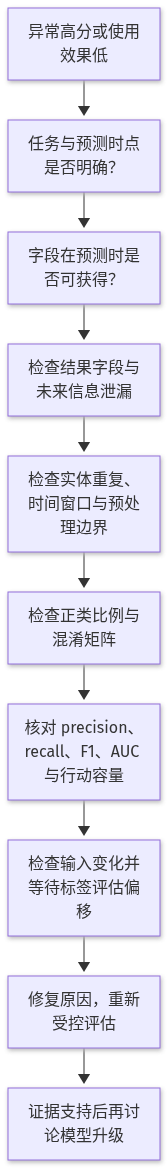
标签泄漏是最容易制造高分的错误。流失后的销户原因、退款完成标记、账户关闭日期,都可能与标签高度一致,却在预测时不可见。Bank Marketing 的 duration 则提醒我们:字段不是天然“安全”或“危险”,是否可用取决于预测时点。每个特征都应写清产生时间和获取延迟,甚至“截至昨天”的统计也可能在今天晚些时候才更新完成。
类别不平衡会让准确率产生误导。若 1000 名客户中只有 50 名流失,始终预测留存就有 95% 准确率,但流失召回率为 0。可以使用类别权重或仅在训练集内进行重采样,再用保持真实比例的验证集评估。若在切分前复制少数类样本,相同记录可能同时出现在训练与测试中。改变训练分布后还应检查分数解释与阈值,不能默认原有概率含义保持不变。
分布偏移意味着使用时的数据不同于训练时期。费用政策改变、客户来源改变、短信措辞改变,都可能让历史规律失效。需要观察输入分布、未知类别、缺失率与预测分数,也需要等待真实标签回流检查效果。仅发现输入变化,不能断定模型已经失效;暂时没有输入变化,也不能保证标签关系没有变化。监控指标与带标签评估应共同提供证据。
最后,反复看测试集再修改方案,会让测试集逐渐变成验证集。即使从未把测试行传进 fit,人工选择也可能利用了测试结果。若已经如此使用,应如实记录,并寻找新的独立评估数据。排查时先核对任务与数据边界,再看类别和分组,再分析误差样本,最后讨论模型升级;直接增加模型规模,可能只会更充分地学习错误信号。
7 案例:复杂模型输给强基线
考虑 1 个教学案例:团队用公开电信客户流失表格设计离线评估,表格记录合同类型、在网月数、月费用及流失标签。这里的数字是示例结果,用于练习判断,不代表对某个公开文件的实测。首先按任务定义排除结果发生后才形成的字段,再固定训练、验证和测试集合。团队比较经过适当处理的逻辑回归与容量更高的树集成,后者的内部机制留待后续课程。
验证阶段,复杂模型的训练 F1 达到 0.96,验证 F1 为 0.54;逻辑回归训练 F1 为 0.62,验证 F1 为 0.60。复杂模型的训练成绩领先,并没有转化为更好的未见数据表现。审查发现,复杂模型对罕见合同与付款组合形成了细碎规则;逻辑回归的约束抑制了部分偶然关系。这里可以提出过拟合假设,但仍需看误差样本和不同划分的稳定性才能增强判断。
在事先选定的阈值下,假设逻辑回归最终测试集有 1000 人,其中 200 人流失,得到 TP = 150、FP = 100、FN = 50、TN = 700。于是 precision = 0.60,recall = 0.75,F1 约为 0.67,准确率为 0.85。提醒名单共有 250 人,服务团队是否能接住这份名单,也是有效性条件。若每天只能处理很少客户,需要重新围绕容量在验证集选策略,而不是直接把阈值搬到业务中。
再假设复杂模型测试时 TP = 120、FP = 80、FN = 80、TN = 720,则 precision 同为 0.60,recall 为 0.60,F1 为 0.60,准确率为 0.84。在这组已锁定的评估中,简单模型覆盖了更多实际流失者。不能从这个结果推出复杂模型永远较差,也不能仅凭差值判断统计上稳定领先。样本有限时,应报告不确定性;需要进一步比较时,使用新的受控实验,而非反复围绕测试集调整。
“强基线”意味着数据处理正确、参数选择合理、比较口径公平,并不意味着故意挑弱模型衬托新方案。团队可以先修复缺失值规则,检查特征时间,再限制复杂模型容量,或收集更多有代表性的样本。只有新证据显示更复杂的方法在相同成功标准下稳定改善,增加维护成本才有依据。基线的作用是把改进变成可检查的增量,而非阻止尝试新方法。
8 把问题类型与成功标准写进方案
方案中的任务描述应能让另 1 位同事独立制作数据。例如:“在每周固定观察日,为仍在使用服务的客户预测未来 30 天流失风险;特征仅使用观察日前已经完成入库的记录。”接着说明流失是主动销户、到期未续约,还是连续停用达到某个条件。不同定义会产生不同标签;把这些行为混在一起,可能让模型同时学习几个机制不同的问题。
评估协议要写明数据单位和边界。每行是客户、客户月份还是通话?同一客户是否跨集合?训练数据覆盖哪些日期,验证数据如何反映使用条件,测试数据什么时候封存?标签需要未来 30 天观察期时,近期样本尚未到期就不能标成“未流失”。必要时在时间划分之间保留间隔,防止观察窗口与标签窗口交叉传播信息。比例只是协议中的 1 项,时间可用性更关键。
成功标准应连接实际动作。例如“每周最多联系 100 人,在验证期内名单 precision 达到预定下限,同时报告对全部流失者的 recall”。同时报告 F1 和 ROC-AUC 可以提供补充视角,但不能让补充指标替代主标准。还应按合同类型、客户年限等合理分组查看样本数与效果,防止整体平均掩盖某些群体的持续误报。分组样本很少时,应标明估计不稳定。
成本也应进入方案。误报会占用服务资源,漏报可能错过挽留机会;但预测到流失不等于联系就能减少流失。离线分类效果只能说明识别能力,干预是否有效需要另行设计受控评估。上线前可先以影子方式生成名单、核对数据和处理容量,再在合适的实验中评估行动收益。不要把相关性的预测直接写成因果性的承诺。
9 从概念图跳到可训练的线性模型(A11)
下一课将把“从特征到分数”展开成可计算的线性模型。对于客户记录,可以把在网月数、标准化后的月费用和合同指示列写成特征向量 x。模型给每项特征分配权重 w,再加上截距 b,得到 z = w·x + b。这里的向量只是把多个数按固定顺序装在一起;相同顺序必须贯穿训练和预测,否则模型会把某个字段误当成另 1 个字段。
例如只取“标准化月费用”和“是否月付”这 2 列,某客户的 x = [1, 1],假设 w = [0.4, 0.8]、b = -0.6,则 z = 0.6。第 1 项贡献为 0.4,第 2 项贡献为 0.8;这些只是示意权重,必须由训练确定。若预测时把月费用从元改成分,却仍沿用原来的标准化参数,费用贡献就会异常放大。即使字段名称正确,也要检查单位和转换规则。权重为正仅表示其他输入固定时该项提高分数,不能据此断言提高费用必然导致流失。
线性并不表示原始世界一定遵守直线规律,而是模型在当前特征表示上采用加权相加的结构。可以将 z 用作回归预测,也可以通过适当函数转换为分类分数;这需要与任务和损失匹配。A11 将解释权重如何依据损失更新、学习率怎样影响更新过程,以及如何观察训练是否正常。本课只要求理解:训练是有目标、有约束地选择规则,评估是检查规则能否推广。
迁移到 Fashion-MNIST 时,像素位置可以形成特征,衣物类别形成标签;迁移到短文本时,词频列可以形成特征,垃圾短信标记形成标签。表示虽然改变,训练、验证、测试的职责仍然相同,泄漏和分布偏移也仍然需要检查。带着“输入是什么、标签何时知道、允许学习哪些规则、怎样判断成功”这组问题进入 A11,比提前记住复杂算法名称更有用。
放进方案里
本方案将客户流失识别定义为监督二分类任务。在每周固定观察日,为仍在使用服务的客户预测未来 30 天是否流失,以客户为评估单位。流失标签采用事先约定的销户或到期未续约规则,并等待完整观察窗口结束后生成。候选输入包括在网月数、合同类型、历史月费用和观察日前已入库的服务记录,每个字段记录来源、产生时间与获取延迟,排除销户结果等预测时不可见信息。
数据按业务时间建立训练、验证和测试集合,同一客户的相关记录遵守分组约束,必要时保留时间间隔。缺失值填补、类别编码与标准化仅在训练集拟合。先比较带正则化的逻辑回归与限制深度的决策树,并保留始终预测留存的参照。模型与阈值仅依据验证集选择,测试集在方案冻结后使用;记录数据版本、字段清单、切分规则、随机种子和实验配置,以便复现。
成功标准围绕每周最多联系 100 人的处理能力确定,在验证阶段约定名单精确率下限,并同时报告召回率、F1、ROC-AUC、正类比例和混淆矩阵。按合同类型及客户年限检查分组表现,并说明小样本的不确定性。未满足主标准时继续诊断数据和特征,不以训练高分作为上线依据。上线前先核对名单可用性与处理流程,持续监控缺失率、未知类别和分数变化,待标签回流后检查效果;是否降低实际流失另设受控评估,出现持续退化则暂停名单使用并重新评估。
验收材料另附固定测试名单及其分数、阈值和最终标签,核对名单人数不超过 100,并能由这些记录重算混淆矩阵。标签观察期未结束的客户单独列为待确认,不纳入本轮效果验收。
10 小结:下一步线性模型(A11)
- 能说明任务属于监督、无监督还是强化学习,并给出输入、输出与反馈。
- 能区分模型族、学到的参数、人工选择的超参数,以及模型的归纳偏置。
- 已定义预测时点和标签窗口,确认每个特征在预测时可用。
- 已隔离训练、验证、测试,预处理只从训练数据学习统计量。
- 已建立强基线,用同一数据和指标公平比较 2 个简单模型。
- 能从 TP、FP、FN、TN 解释 precision、recall 和 F1,也知道 AUC 不等于固定阈值的业务收益。
- 已检查泄漏、类别不平衡、分布偏移与处理容量,并写明未达标时的行动。
自测:若 95% 的客户不会流失,始终预测留存为什么可能获得高准确率?若通话结束后才知道时长,它能否用于通话前预测?若训练成绩提升而验证成绩下降,应收集哪些证据再决定是否增加模型容量?能够解释这些问题,就具备进入 A11 的概念基础。