1 为什么日志是「半结构化文本」
订单 API 在处理请求时会留下访问日志与错误日志。访问日志回答请求何时到达、走了哪个路径、返回什么状态、耗时多少;错误日志补充失败发生在哪个处理阶段。值班时,我们常从「用户说下单很慢」出发,把这些记录缩小到可以解释的范围。文本处理的目标是得到可复查的线索,而不是用几条命令直接宣布根因。
日志看起来有列,却通常没有数据库那样严格的约束。某条记录缺少请求 ID,某次发布新增了字段,错误消息又可能夹着空格、引号甚至换行。因此它是「半结构化文本」:有可利用的重复形状,也允许局部变化。工具只看到字符、分隔符和记录边界,不会自动理解订单、重试或超时。先确认格式,再写命令,是整节课最重要的习惯。
本课使用下面的教学访问日志。每条物理行代表 1 次请求,各字段用 1 个 ASCII 空格分隔;字段内部没有空格,时间统一为 UTC,并固定到秒。路径不带查询串,耗时单位为毫秒。真实系统若不满足这些约定,后面的字段位置与统计方法就必须调整。示例中的日志都是练习数据,实际分享时还要遮盖令牌、用户标识及其他敏感内容。
2026-10-31T09:00:01Z INFO rid=r101 method=POST path=/orders status=201 duration_ms=84 upstream=order
2026-10-31T09:00:02Z WARN rid=r102 method=POST path=/orders status=504 duration_ms=3001 upstream=order
2026-10-31T09:00:03Z ERROR rid=r103 method=GET path=/orders/42 status=500 duration_ms=127 upstream=order
2026-10-31T09:00:04Z WARN rid=r104 method=POST path=/orders status=504 duration_ms=3004 upstream=order
2026-10-31T09:00:05Z INFO rid=r105 method=GET path=/health status=200 duration_ms=2 upstream=local
2026-10-31T09:00:06Z WARN rid=r106 method=POST path=/orders status=502 duration_ms=18 upstream=order
对应错误日志也按行记录,但消息字段允许空格。因此,不能把访问日志的第 8 列规则直接复制到错误日志。请求 ID 是连接两类记录的线索;它通常比搜索「超时」更精确。不过,同一 ID 可能对应入口、业务处理和重试的多条记录,跨系统时也可能丢失。关联之前要知道 ID 由谁生成、在哪些边界传递。
2026-10-31T09:00:02Z ERROR rid=r102 component=order event=upstream_timeout message="payment wait exceeded"
2026-10-31T09:00:04Z ERROR rid=r104 component=order event=upstream_timeout message="payment wait exceeded"
开始前先回答 4 个问题:文件来自哪些实例,覆盖什么时间,记录边界是什么,字段定义来自哪里。只拿到 1 个实例的文件,却把结果写成「订单服务全部请求」,会让命令正确而结论错误。文件名、采集时间、时区、轮转范围与格式版本,应当与命令一起保存。后续每次过滤,都在这些边界内解释结果。
2 管道再回顾:过滤比打开巨型编辑器更安全
S6 已经介绍管道把前一个命令的标准输出交给后一个命令。现在让它承载具体任务:从大量日志中先保留目标记录,再抽出需要的字段,最后计数和排序。大多数过滤命令能够逐行处理输入,不必先把整个文件装进编辑器;这降低误改原始日志的机会,也让筛选规则能够保存、复跑和接受同伴检查。
这里的「更安全」有明确条件:只读源文件,输出写到另一个路径,并控制展示内容。不能写成 grep ERROR access.log > access.log,因为 shell 会先截断输出文件,再启动读取。即使命令完全只读,终端输出仍可能泄露个人信息。先在授权目录选择必要字段,再分享统计与脱敏样本,比直接复制整段生产日志更稳妥。
grep -F ' status=504 ' access.log |
  cut -d ' ' -f 5 |
  LC_ALL=C sort
这条管道先用固定字符串找出状态为 504 的教学记录,再取第 5 个字段,最后按字节顺序排列。输出中的 path=/orders 出现 2 次,表示当前输入有 2 条匹配记录,并不表示有 2 个独立用户。cut 此时仍保留重复行;它只负责抽列。每个工具的责任越小,越容易在结果异常时定位是哪一步改变了含义。

遇到意外结果,不要立刻给管道叠加更多过滤条件。先单独运行前 1 段,观察保留下来的少量脱敏记录,再接抽列与排序。标准错误默认不会沿普通管道传给下一段,文件不存在或权限不足的信息不能当作「没有匹配」。如果使用脚本,沿用 S8 的引用和退出码习惯;开启 pipefail 后也仍要区分预期的无匹配与真正失败。
管道中还存在不同的资源行为。grep、cut 和本课的 awk 用法通常能流式输出;sort 需要看到全部输入才能确定最终顺序,数据量大时会使用临时文件。先缩小时间、实例和字段范围,有助于减少排序负担。不要为了「快点看到结果」把 head 塞到排序之前,那样得到的是输入开头的一部分,已经改变了总体。
3 grep/rg:定位错误与请求 ID
grep 适合在指定文件中筛选行;rg 也能搜索文本,并且便于在目录中定位。日常排查先决定是在找字面字符串,还是在表达字符模式。请求 ID、固定事件名和状态字段通常适合 -F 固定字符串搜索,既容易读,也不会把点号、方括号等字符误解成正则语法。shell 单引号则防止模式先被 shell 展开。
grep -nF 'rid=r102 ' access.log error.log
rg -n -F 'rid=r102 ' access.log error.log
grep -nF 'event=upstream_timeout ' error.log
-n 显示文件中的行号,多文件搜索还会给出文件名,方便返回原始证据。ID 后保留空格,是利用本课字段边界,避免把 r1020 当成 r102。若 ID 可能位于行尾,则要用同时兼容空格与行尾的边界表达式。grep -w 的单词边界不等于业务字段边界,ID 含连字符或其他符号时尤其不能想当然。
当目标是一组状态码时,可以使用有限的正则。本课只需要理解字符集合、重复与边界,不需要学习复杂的正则技巧。下面的扩展正则查找 status= 后恰好为 3 位且首位是 5 的字段,左侧与右侧都限定在字段边界。它会匹配 500、502 和 504,不会因为消息里碰巧写着 5000 就命中。
grep -nE '(^| )status=5[0-9]{2}( |$)' access.log
grep -n -C 2 -F 'rid=r102 ' error.log
-C 2 可以在人工阅读时附带前后各 2 行上下文,帮助观察相邻事件。但这些行可能属于其他请求;并发写入时,时间相邻不代表因果相连。上下文输出还可能包含分组分隔行,不能继续当作原始日志直接计数。用于展示的命令与用于统计的命令应分开保存,避免把辅助信息混入分母。
grep -i 与 rg -i 可以忽略大小写,适用于确认存在大小写差异后扩大搜索。它们无法自动把 timeout、timed out 与中文「超时」理解为同义词。优先搜索稳定事件代码,必要时再列出多个明确模式。无匹配只说明指定输入里没有命中指定规则,不能直接推出系统没有发生过故障。
还有退出状态需要记住:通常 0 表示找到匹配,1 表示没有匹配,大于 1 表示执行错误。脚本若只用「非 0 就报警」会把正常的无匹配与读文件失败混在一起;直接追加 || true 又可能吞掉真正错误。沿用 S8 的条件分支,明确处理这些情况,并保留错误输出。可复查的搜索应同时说明搜了什么、在哪搜、有没有成功读到输入。
4 cut/awk:抽字段与简单聚合
cut 适合字段边界已经明确的文本。cut -d ' ' -f 3,6,7 access.log 会取出请求 ID、状态与耗时字段。这里的分隔符是单个空格,每个连续分隔符都会参与切列;多出空格可能制造空字段,让位置整体偏移。制表符分隔文件可以使用默认分隔方式,但不能把「终端上看着对齐」当作实际分隔规则。
awk 默认按连续空白划分字段,$1 表示第 1 个字段,$0 表示整条记录,NF 表示当前记录的字段数。这足以完成本课需要的抽取与过滤。教学访问日志固定为 8 个字段,因此先验证 NF,再使用 $6 和 $7。字段位置一旦变化,命令不会自动报出「取错了列」,所以格式检查是取列的一部分。
awk 'NF != 8 {print NR, NF}' access.log
awk 'NF == 8 {print $3, $6, $7}' access.log
awk 'NF == 8 && $6 == "status=504" {print $1, $3, $7}' access.log
第 1 条命令输出字段数异常的行号与字段数;在本课完整样本上没有输出。第 2 条负责抽列,第 3 条增加条件,只有状态字段精确等于目标值才打印。NR 是当前输入中的记录序号;若上游已经过滤,它不再是原文件行号。需要返回源文件定位时,应保留原始搜索结果或另外记录来源,不能把中间结果的行号直接引用成证据。
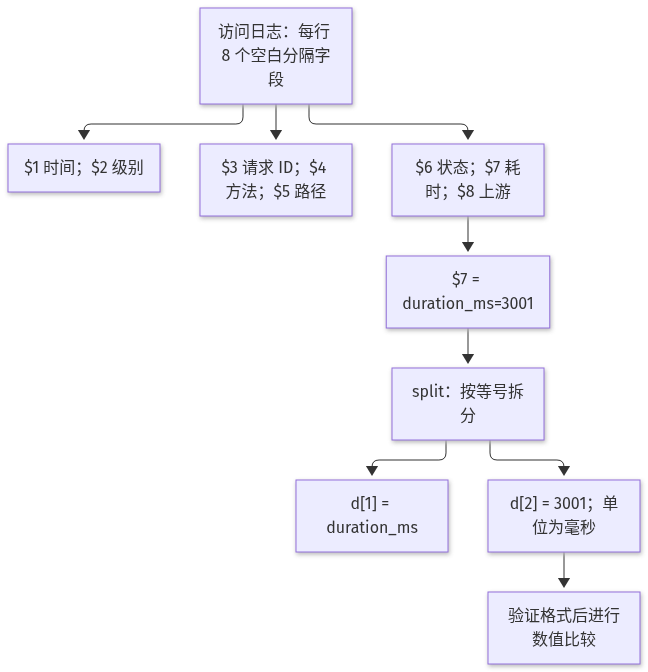
字段内部还有 key=value 这层结构。下面用 split 将耗时字段按等号拆成 2 段,把右侧用于数值比较。格式检查要求其内容是非负整数,避免把缺失值或带单位的字符串静默当成数字。+0 显式表达数值比较;单位仍由日志约定保证,不能仅凭字段名猜测。超过 3000 毫秒是本次筛选阈值,不是通用故障标准。
awk 'NF == 8 && $5 == "path=/orders" && $7 ~ /^duration_ms=[0-9]+$/ {
  split($7, d, "=")
  if (d[2]+0 > 3000) print $1, $3, $6, $7
}' access.log日常还会需要简单计数与平均值。下面只统计创建订单请求中耗时字段有效的记录。n 累加条数,sum 累加耗时,END 在读完输入后输出摘要,并处理没有有效样本的情况。在教学样本中,有效请求为 4 条,平均耗时为 1526.75 毫秒。平均值可以提供概览,但不能代表最慢请求,更不能替代延迟分布。
awk 'NF == 8 && $4 == "method=POST" && $5 == "path=/orders" && $7 ~ /^duration_ms=[0-9]+$/ {
  split($7, d, "=")
  n++; sum += d[2]
}
END {
  if (n > 0) print "requests=" n, "avg_ms=" sum/n
  else print "no_valid_samples"
}' access.log
到这里就足够了:抽字段、写清条件、累加少量指标。不要为了处理变化的结构继续堆叠复杂脚本。含引号的 CSV、嵌套 JSON、允许空格的消息字段,都应使用理解其格式的解析器。尤其不要用空格切分 JSON 后声称拿到了某个键;转义、字段顺序与嵌套结构都可能破坏这种假设。
5 sort/uniq:频率与 Top N
值班经常需要知道「哪种错误最多」或「哪个路径最常失败」。uniq 只合并相邻的相同行,不会替你寻找远处的重复项;因此常见顺序是先抽字段,再 sort,再 uniq -c,最后按计数排序。顺序不能随意交换:先对原始日志去重,时间戳与 ID 的差异会让几乎所有记录都被保留。
awk 'NF == 8 && $6 ~ /^status=5[0-9][0-9]$/ {print $5}' access.log |
  LC_ALL=C sort |
  uniq -c |
  LC_ALL=C sort -k1,1nr -k2,2
对教学样本,结果是 path=/orders 有 3 条、path=/orders/42 有 1 条。第 1 次排序把相同路径放在一起;uniq -c 给每组加计数;第 2 次排序对第 1 列做数值降序,并以第 2 列作为并列时的稳定规则。若只做普通字符串排序,计数 9 可能排在 80 前面。排序选项应与列的含义一起解释。

若要保留至少出现 2 次的路径,并展示前 10 项,可以在最终排序后追加 awk '$1 >= 2' 与 head -n 10。阈值控制哪些项目有资格进入结果,Top N 控制展示多少项,两者回答不同问题。交互中调整它们时,输入总体保持固定,原始计数也保持固定;消失的行只是没有展示,不能解释为对应请求已经消失。
统计的单位必须在输出旁边说明。按访问日志行数统计,得到的是请求尝试次数;客户端重试会让同一订单产生多条访问记录。若目标是受影响订单数,需要可靠的订单标识与去重规则。日志缺少该字段时,应明确说明无法从当前数据得出这个指标,不能随手对请求 ID 去重来代替。
路径粒度同样影响频率。/orders/42 与 /orders/43 分开计数会造成大量低频项,掩盖同类接口的总量;最好使用应用提供的路由模板字段,例如 /orders/:id。自己改写路径时必须保留规则和原始证据,防止误把其他数字片段归并。汇报中同时保留总请求数与目标请求数,才能区分「错误条数上升」和「流量上升但错误比例稳定」。
6 sed:小范围改写与危险点
sed 适合对已知格式做局部替换,例如在分享样本前把请求 ID 改成占位符,或统一某个展示字段。本课使用 s/模式/替换/,默认每行替换第 1 处匹配;末尾加 g 才替换该行全部匹配。先输出到终端检查少量脱敏样本,再写入新的文件。不要把初次尝试直接配上原地改写选项。
sed -E 's/(^| )rid=[^ ]+/\1rid=REDACTED/g' access.log
sed -E 's/(^| )rid=[^ ]+/\1rid=REDACTED/g' access.log > access.redacted.log
这里 (^| ) 约束字段起点,[^ ]+ 只延伸到下一个空格,替换中的 \1 保留捕获到的行首或空格。规则依赖本课「字段内无空格」的约定;它只遮盖 rid 字段,绝不代表整份日志已经完成脱敏。真实样本还可能在路径、消息、请求头中带有敏感值,发布前应检查这些具体位置。
危险往往来自范围过大。正则中的 .* 通常会尽可能多地匹配;如果某行有 token=abc user=u7 token=def,使用 token=.* 会从第 1 个 token 吞到行尾。对明确的字段,应写出字段边界;对复杂消息,不要依靠「看起来能匹配」的规则自动清洗整批文件。改写前后都要能解释哪些字符会变化。
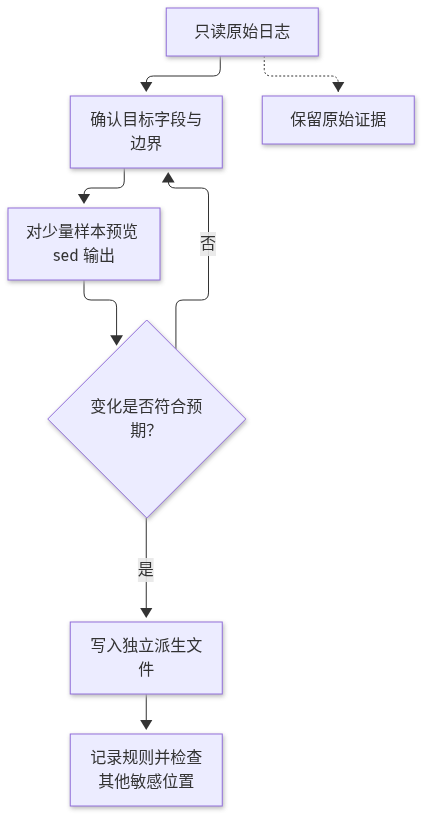
还要分清文本改写与业务事实。把 status=504 替换成 status=200 只会改变文件内容,不会让请求成功,反而污染排查证据。原始日志应保持只读,派生文件清楚命名,并记录变换规则。sed -i 的行为在不同实现上存在差异;它适合已有备份、已核对范围的明确维护任务,不适合临时探索生产日志。
7 常见坑:编码、贪婪匹配、把管道当数据库
终端能显示文字,不代表文件编码一致。日志可能使用 UTF-8,也可能混入旧编码、非法字节或不同换行。搜索中文「超时」没有结果时,要先确认采集链路是否改变了字节,不能马上把问题归因于正则。LC_ALL=C 可以让排序按字节规则进行,便于重复得到相同顺序;它并不会修复编码,也不保证适合按中文语义排序。
Windows 风格的 CRLF 换行会在行尾留下回车字符,导致严格行尾匹配不符合预期。对少量已授权样本,可以使用 sed -n '1,5l' suspect.log 显示转义形式,观察是否有 \r 等异常。只有确认输入是此类文本后,才在派生副本上移除行尾回车;不要全局删除所有控制字符,因为它们也可能属于有效消息内容。
另一个坑是搜索范围。rg 搜索目录时通常遵循忽略规则,并跳过隐藏文件;默认也有二进制检测。明确列出的文件与目录递归的行为不能混为一谈。轮转后的压缩日志也不应假定会自动按文本展开。需要时先明确文件清单,再用适合压缩格式的读取方式,例如 gzip -cd access.log.1.gz | grep -F 'rid=r102 ',同时检查读取是否成功。
贪婪匹配之外,还要警惕把正则当成语义理解。点号代表任意字符,[0-9] 代表单个数字,模式两端有没有边界会直接改变命中范围。请求 ID 来自变量时,优先把变量作为固定字符串模式传给 grep -F -- "$rid",其中 -- 防止以短横线开头的内容被解释成选项。变量仍要加引号,避免 shell 先拆词。
管道也没有数据库的事务快照。边写边读的文件可能在处理中继续增长,轮转时还可能漏掉某段记录。需要复现统计时,应使用注明时间与来源的稳定导出文件,说明采集是否完整。把多个文件直接拼接,也可能重复包含采集器已经复制过的记录。去重前必须知道唯一键与重复形成原因,否则可能把真实重试一并删掉。
时间比较尤其容易给人错觉。只有时区、精度与格式统一时,固定宽度时间戳的字符串顺序才适合直接比较。跨时区偏移、缺少补零或混合小数秒,都需要先规范解析。管道擅长缩小问题与生成证据;跨大量来源做持续关联、保留复杂状态或要求严格完整性时,应采用合适的日志查询与存储方案,而不是无限扩展临时命令。
8 案例:从 access log 抓订单超时线索
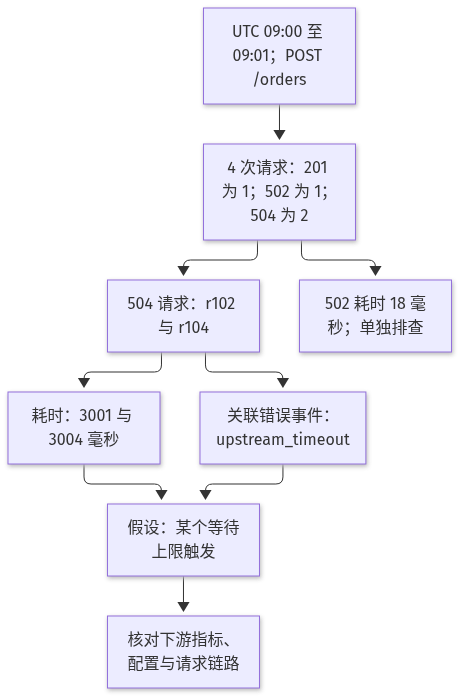
现在收到告警:「09:00 左右创建订单变慢」。先把问题改写为可检查的范围:UTC 的 09:00:00 至 09:01:00,入口访问日志,POST /orders。先保留这段时间内的全部目标请求作为分母,再统计状态与耗时。下面使用前闭后开的时间区间,避免相邻窗口在边界上重复计数;它只适用于本课统一格式的时间戳。
awk 'NF == 8 && $1 >= "2026-10-31T09:00:00Z" && $1 < "2026-10-31T09:01:00Z" && $4 == "method=POST" && $5 == "path=/orders"' access.log > orders.window.log
awk '{print $6}' orders.window.log | LC_ALL=C sort | uniq -c
awk '$6 == "status=504" {print $3, $7}' orders.window.log
样本里有 4 条创建订单请求:201 为 1 条、502 为 1 条、504 为 2 条。当前记录中的 504 占比是 2/4,即 50%;若把全部 5xx 视为失败,则失败比例为 3/4,即 75%。这两个指标口径不同,不能都简称「错误率」。样本非常小,数字只描述这段教学输入,不足以代表全天情况,更不能直接外推损失金额。
随后检查 504 对应的请求 ID:r102 与 r104,耗时分别为 3001 与 3004 毫秒。它们靠近 3000 毫秒,提示可能存在某个等待上限。此时可以提出待验证假设「请求在等待某个下游时超时」,但还不能断言下游一定故障。网关等待、连接排队、应用自身阻塞都可能呈现相似的总耗时。
grep -nF 'rid=r102 ' error.log
grep -nF 'rid=r104 ' error.log
错误日志都出现 component=order event=upstream_timeout,消息提到等待支付处理。线索因此收敛到订单处理中的相关等待阶段,下一步应核对同一时间窗的下游指标、超时配置以及对应请求链路。与此同时,r106 的 502 只有 18 毫秒,不能被塞进相同的超时解释,应作为另一组失败单独检查。
交接记录应能让另一个值班人员复跑:注明 UTC 窗口、文件来源、字段格式、筛选命令与统计口径,附上少量脱敏 ID 的关联证据。结论可以写为「当前样本中 2 条 504 均伴随等待上游超时事件,需核对支付调用阶段」,避免写成「支付服务已确定是根因」。保留未解释的 502,也是对证据边界负责。
9 排查案例:同样关键字为何漏报
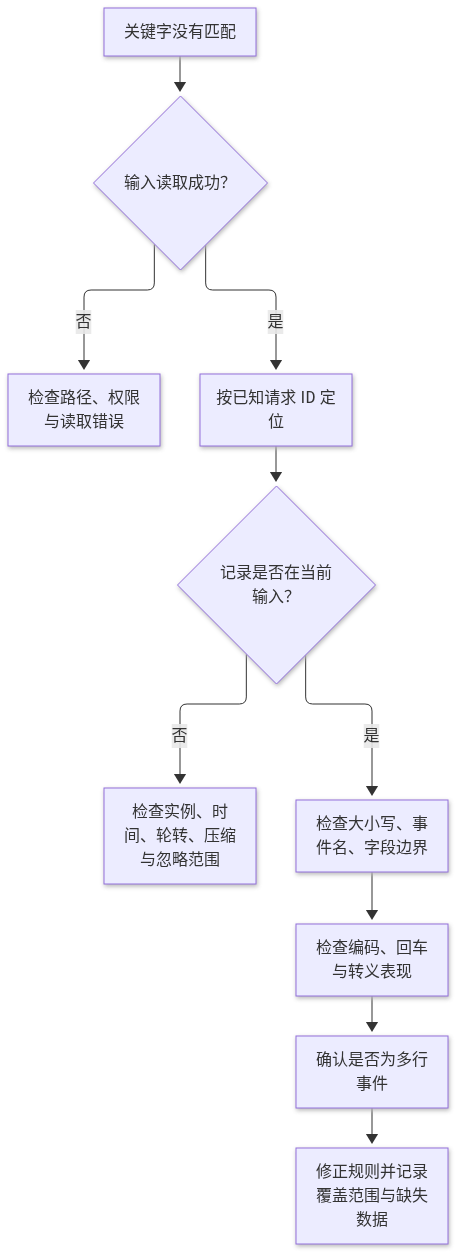
另一位同事搜索 grep 'timeout' error.log 得到 0 条,却在界面上看到超时事件。先检查命令是否成功读取文件,再比较双方的输入范围、时间与搜索表达式。不要先给出「工具不可靠」的解释。很多漏报来自文件选错、轮转文件未读、大小写不同,或者界面展示了格式化后的中文说明,而原始记录使用稳定事件代码。
按层缩小差异:先在明确的文件中找已知请求 ID,确认记录在不在;找到后观察事件字段的真实拼写,再决定使用固定字符串、忽略大小写或多个候选模式。如果 ID 在当前文件里也不存在,就回到采集与文件范围,而不是继续修改 timeout 的正则。每次只改变 1 个条件,才知道是哪项变化找回了记录。
grep -nF 'rid=r104 ' error.log
grep -niF 'timeout' error.log
grep -nF -e 'event=upstream_timeout' -e 'event=deadline_exceeded' error.log
sed -n '1,5l' suspect.log
这组命令分别检查关联标识、大小写、明确事件变体与字节表现,不保证每条都能命中所有系统。假设旧版本写 event=TIMEOUT,新版本写 event=deadline_exceeded,单纯加 -i 只能解决前者。修正后的规则应记录覆盖哪些版本与事件名,并对已知样本说明预期命中。不要用不断放宽的 .* 替代字段定义。
还有多行错误:首行带请求 ID,后续堆栈才带关键字。逐行工具不会自动把它们当作同一事件。人工上下文可帮助确认,但正式统计需要先按记录规则恢复完整事件,或改用应用已有的结构化事件字段。否则搜索命中的是堆栈行数,而你报告的却可能是请求数,两者完全不同。
最后在交接中同时写明已覆盖与未覆盖的输入:例如已查当前访问日志与指定轮转文件,尚未取得某实例的错误日志。缺数据本身就是排查结论的一部分。可复现的文本处理不要求每次立刻找到根因,但要求其他人知道怎样得到相同结果,以及结果在哪些边界之外不能成立。
收尾时固定 3 步证据法:先按时间窗切片,再按请求 ID 串联 access 与 error,最后用字段抽取核对耗时落在哪一段。若关键字漏报,优先怀疑编码与分隔符漂移,而不是立刻扩大匹配面;把「0 命中」也记进工单,说明假设已被证伪。对大文件先抽样 2000 行验证管道,再全量跑,避免一次扫盘拖垮值班机。
文本处理还有一层常被忽略的成本:每次全盘扫描都会抢磁盘带宽。订单高峰时若在应用盘上跑沉重管道,可能把写库延迟一起抬高。更稳的做法是把原始日志落到专用只读卷或对象存储副本,分析机用流式过滤;需要跨天对比时,先按小时分区再合并 Top N。团队约定统一时间格式与请求 ID 字段名,能减少一半「同一关键字漏报」的扯皮。把这些约定写进 runbook,比临时发明 8 种 grep 写法更重要。
最后提醒:管道再强也不能替代结构化日志改造。当字段频繁漂移时,推动应用侧输出 JSON 或固定列,比继续堆正则更划算;文本课的目标是让你在过渡期仍能救命,并有证据去推动长期改进。
把文本处理写进容量与值班方案时,建议同时给出「工具路径」和「证据模板」。 工具路径写清:在只读日志副本上执行的管道示例、预计耗时、以及禁止在生产写库盘上全量扫盘的红线。 证据模板写清:时间窗、请求 ID、命中行数、关键字段原句、以及结论是上游慢、本机等待还是关键字假设错误。 大促前用昨天的高峰日志做一次彩排,记录从接到告警到定位首条证据的耗时;若超过 10 分钟,说明索引或分区策略要先改,而不是只加人手。 对多主机场景,先用主机名或实例 ID 收窄,再抽字段;跨主机合并时统一时区,避免把 8 小时偏移误判成「同一分钟的尖刺」。 若业务已规划结构化日志,仍保留本课管道作为兜底,并在 runbook 里写明退役条件:字段稳定率连续 14 天高于 99% 后再减少临时正则。
放进方案里
在订单 API 的值班方案中,增加「日志文本处理」步骤卡。先规定入口日志的字段顺序、分隔符、耗时单位、时区与请求 ID 传播规则,明确访问日志每行代表请求尝试,错误日志可能每个事件包含多行。每次发布若改变格式,需同步更新示例与筛选规则。把格式约定当作接口维护,才能避免值班人员在故障中猜测列号。
步骤卡先登记输入:告警时间、换算后的 UTC 窗口、实例清单、文件范围、轮转情况与采集完整性。使用稳定导出副本开展统计,保留原始文件;派生结果写到独立目录,记录生成时间与命令。为导出文件设定访问权限和清理期限,分享时只保留必要字段,并按实际内容检查脱敏效果,不能把单条替换命令当作完整审查。
随后固定排查顺序:先按时间和路由筛选目标请求,再按状态与耗时缩小范围,使用请求 ID 关联错误事件,最后查看路径或事件的频率。每项统计附上单位、分母、阈值及 Top N,并保留未展示项目的数量。无匹配、读取失败和字段异常分别报告;字段异常超过可接受范围时,先修正解析与采集,再解释业务比例。
交接物包括可复跑命令、脱敏样本、已确认事实、待验证假设与缺失数据。定期用包含正常、超时、缺字段和格式变更的已知样本检查规则。容量评估应在多个可比时间窗观察请求量、错误比例及延迟变化,并与 CPU、内存和下游指标对照。日志出现更多超时,只能触发进一步核查;扩容或调整超时需要额外证据与回退安排。将本次发现补回步骤卡,下一次值班才能从已有边界继续推进。
10 小结:文本处理清单接到值班与容量
文本处理可以按 6 个动作记忆:确认输入边界,定位记录,抽取字段,统计频率,小范围改写,保留复查证据。grep/rg 负责找行,cut/awk 负责取列与明确条件,sort/uniq 负责分组频次,sed 负责受控替换。工具越简单,越要把字段、时间与统计单位说清楚。
值班前可以自查:是否覆盖了轮转文件?无匹配和读取失败能否区分?抽列是否依赖已经变化的格式?Top N 前是否完成全部计数?超时比例的分母是否一致?原始日志是否保留?如果这些问题答不清,优先补充证据,再把结果接到容量或故障判断。
最后想 3 个问题:为什么 uniq -c 前通常需要排序?为什么搜到 2 条超时日志不等于影响了 2 个订单?为什么 3000 毫秒附近的耗时只能支持假设?能用本课样本解释它们,就已经掌握了从文本走向可核查运维线索的基本方法。
下一课转向 S10 Shell 脚本:把本章验收过的结论带进后续主题,写成可检查的方案约束。