1 消息系统要解决什么
某台 Linux 主机不断收到待扫描文件,接收进程要把路径交给扫描进程,再把结果交给审计进程。直接启动子进程可以完成小规模工作,但扫描耗时突然从 100 毫秒变为 5 秒时,接收进程可能堆满内存;扫描进程退出后,尚未处理的路径也可能随之消失。消息系统把“接收工作”和“完成工作”拆开,让工作先进入可管理的缓冲区,再由消费者按能力处理。这里传递的消息可以很小,例如消息 ID、文件标识、文件版本和任务类型;文件内容仍由文件系统保存。
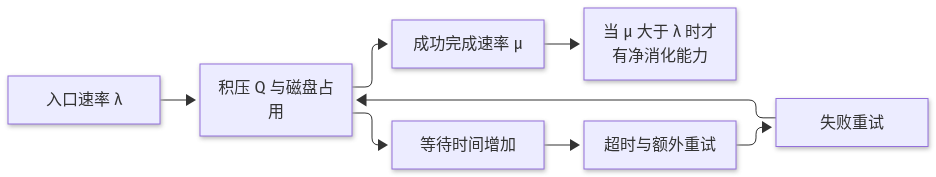
消息系统首先解决速度不匹配:生产者生成任务的速度会波动,消费者处理速度也会波动。它还提供故障后的交接位置:生产者何时可以认为任务已被接收,消费者失败后哪些任务需要再来。缓冲只能争取时间,不能凭空增加处理能力。如果持续入口为 800 条/秒,成功完成只有 600 条/秒,积压就会持续增长。把同步调用改成异步消息,只是把等待从调用栈搬到了队列和磁盘上,仍要面对容量边界。
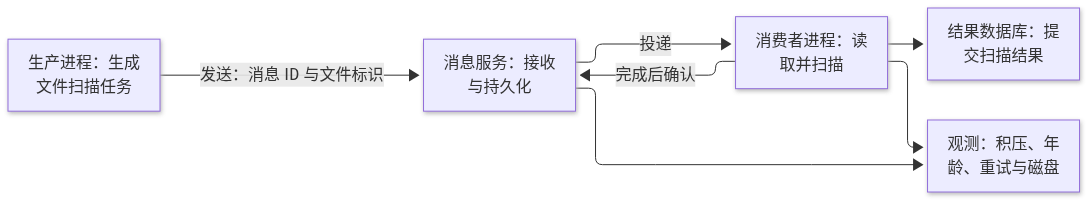
从操作系统角度看,消息服务也是进程:监听网络端口,使用内存缓存,打开数据文件,通过文件系统占用磁盘。消费者同样是普通进程,可能因为权限错误读不到文件,因为网络超时访问不到结果库,也可能被运维人员终止。消息服务能重新投递任务,并不代表它能修好文件权限或恢复已经删除的文件。设计时必须把“消息仍存在”和“消息引用的数据仍可读取”分别考虑。
shell 管道也在传递数据,例如 producer | scanner,但普通匿名管道通常依附进程生命周期,缓冲容量有限,不负责持久保留与独立重放。消息系统增加的是跨进程、跨主机的交接协议和保留规则。它也有成本:需要运行额外服务、处理重复、监控积压,并接受任务不会立即完成的事实。只有确实需要缓冲、解耦或独立恢复时,这些成本才有明确收益。
本课沿用文件扫描场景。生产者发布 scan-001,消息中包含文件的稳定标识与版本;消费者读取指定版本,提交扫描结果后确认完成。路径只是定位线索,不能天然代表文件身份,因为同一路径的内容可能被覆盖。先把交接与故障边界讲清楚,再讨论吞吐,比先记住某个产品的命令更容易迁移到不同消息系统。
2 队列、日志与消费模型
队列模型把消息看作待完成的任务。同一消费组中的多个扫描进程竞争任务,通常由某个成员取得某条消息并处理;处理成功后确认,失败或失联时可能重新投递。这里的“由某个成员处理”描述正常分配,并不保证故障期间只会收到 1 次。队列是否立刻删除消息、是否支持延迟投递,都取决于具体接口,不能只根据“队列”这个名称推断。
日志模型把消息看作按位置追加的记录。消费者保存读到哪里,也就是消费进度;扫描订阅和审计订阅可以分别推进。扫描进度前进,并不会自动推进审计进度。记录是否删除通常由时间、容量或其他保留规则决定,不以所有订阅是否处理完作为唯一条件。因此消费者离线太久,可能发现自己需要的位置已经过期。可重放能力始终受保留范围约束。
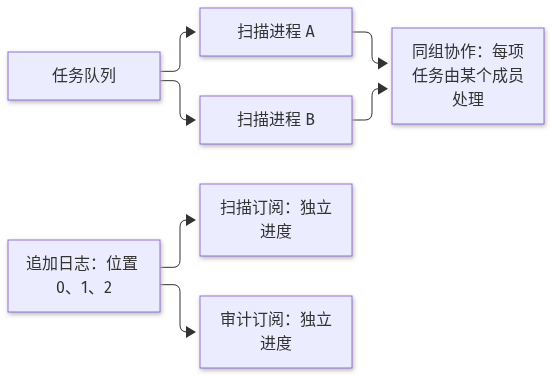
同一条记录交给扫描和审计 2 类用途,需要表达成 2 个独立订阅或消费组;把它们放进同一个竞争消费组,可能导致扫描拿走的消息没有交给审计。反过来,如果 4 个扫描进程各自建立独立订阅,它们可能把全部文件各扫 1 遍。选择模型时先回答“这些进程是共同完成同一批工作,还是每类用途都要看到全部记录”,再决定组和订阅的关系。
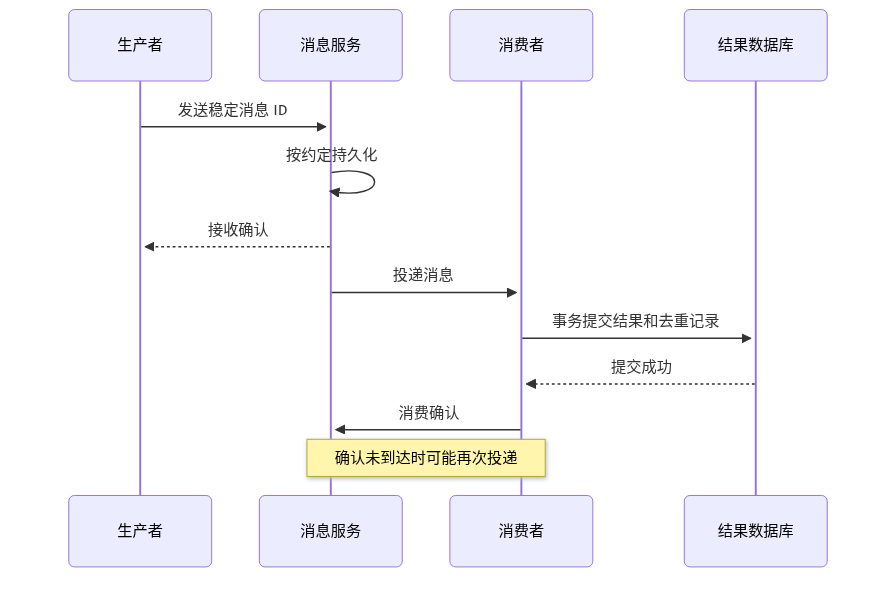
生产确认与消费确认属于不同交接。生产确认回答消息服务是否按约定接收了消息,消费确认回答消费者是否声明本次处理结束。前者到达时,扫描结果可能还不存在;后者到达前,结果却可能已经提交。发送接口返回成功也要核对含义:是写入客户端缓冲、服务端内存,还是达到约定的持久化条件。接口文档中的成功条件才是恢复依据。
消费者通常采用拉取或由服务端推送的方式接收消息,入门阶段关注的是背压:消费者能否限制尚未确认的数量。当每个消费者预取 10000 条任务时,服务端可见的“待投递数”可能下降,但任务只是搬进消费者内存,尚未完成。判断工作量应同时查看待投递、已投递未确认和已成功完成,并了解这些指标是否存在重叠。不能随意相加不同系统定义的计数。
3 至少一次与恰好一次边界
至少一次投递允许重复:在消息已被可靠接收、仍处于保留期且系统最终恢复等前提下,通过重试争取让消费者收到消息。最多一次通常避免重投,但故障窗口可能造成漏处理。两者都不是“永远成功”的保证。尤其是至少一次,只约束投递行为时,并不能保证文件扫描最终成功;文件永久不存在,重试再多次也没有结果。
考虑最常见的窗口:消费者先把扫描结果写入数据库,再发送消费确认。数据库提交成功后,进程立刻退出,确认没有发出。消息服务只能看到未确认,稍后重投是合理行为。若把顺序反过来,先确认再写结果,则确认后退出可能让任务被视为完成,结果却从未保存。简单交换这 2 个动作,无法同时消除重复与丢失。
幂等让重复执行具有可接受的结果。扫描任务可以使用稳定的任务 ID,将“此 ID 已处理”和扫描结果放进同一个数据库事务,并用唯一约束阻止重复写入。同一任务重投时,消费者识别已有记录,返回已有结果并正常确认。若生产者发送超时后重新生成消息 ID,消费者就无法仅凭消息 ID 识别重复。因此还要约定逻辑任务的身份,例如文件标识、版本与扫描规则版本的组合。
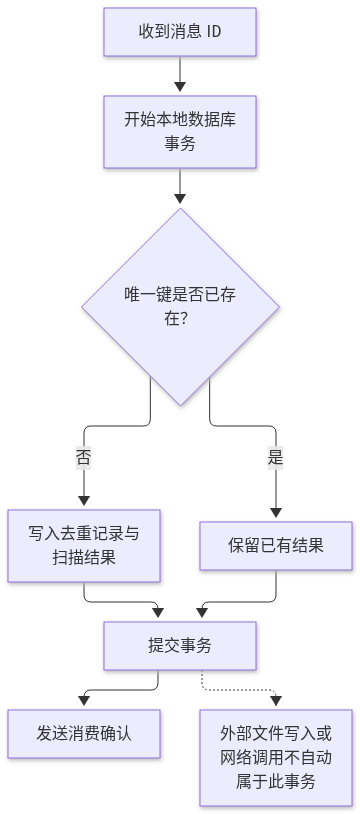
只在内存集合里记录已处理 ID,进程重启后会忘记历史;只先写去重记录、后单独写结果,可能在中途退出后留下“已处理但无结果”。唯一键也不是自动完成全部工作:去重记录和实际修改要共同提交或共同回滚。若处理包含调用外部接口、修改文件和提交数据库,这些动作通常不在同一个本地事务内,需要分别设计幂等接口或恢复步骤。
“恰好一次”必须带上边界。某些系统能保证内部读取与写回的事务效果,但不能由此推导出外部 shell 命令只执行 1 次。把消息交给 sh 后发送通知、移动文件或调用远端接口,都要检查各自的故障窗口。本课把目标写成“允许重复投递,但指定数据库内的结果修改最多生效 1 次”,比笼统写“全链路恰好一次”更容易证明和验收。
去重记录也有生命周期。若消息可保留 7 天,而去重记录只保存 1 天,旧消息重放时可能再次修改结果。保留期限应覆盖正常重试与允许的重放范围;超出范围的历史恢复,要明确是否使用新的任务身份,以及是否允许再次产生结果。这里暂不展开分布式事务,只记住:跨越更多独立存储,承诺就需要更多协调依据。
4 动手:复现一次重复消费与幂等
下面用 Python 标准库和 SQLite 复现“结果提交后退出,确认尚未发生”的窗口,不需要安装消息服务。固定的 scan-001 代表同一条重投消息,重复运行脚本代表恢复后的再次投递。脚本中的结果计数代表一次扫描结果的数据库修改,不直接执行文件扫描。确认用最后 1 行输出表示,因此它是故障模型实验,不能替代真实消息服务的集成测试。
在有 python3 的 Linux shell 中创建临时目录并保存脚本。实验只写入该目录中的数据库;不要把数据库路径换成生产文件。mktemp -d 返回的目录路径保存在变量中,后续命令应在同一个 shell 会话执行。
demo_dir=$(mktemp -d)
cat > "$demo_dir/consume.py" <<'PY'
import os
import sqlite3
import sys

db_path, mode = sys.argv[1:]
if mode not in ("raw", "safe"):
    raise SystemExit("mode must be raw or safe")
db = sqlite3.connect(db_path)
db.execute("CREATE TABLE IF NOT EXISTS results (name TEXT PRIMARY KEY, n INTEGER NOT NULL)")
db.execute("CREATE TABLE IF NOT EXISTS seen (id TEXT PRIMARY KEY)")
db.commit()
message_id = "scan-001"
with db:
    apply_result = True
    if mode == "safe":
        cursor = db.execute("INSERT OR IGNORE INTO seen(id) VALUES (?)", (message_id,))
        apply_result = cursor.rowcount == 1
    if apply_result:
        db.execute("INSERT INTO results(name,n) VALUES ('scan-result',1) "
                   "ON CONFLICT(name) DO UPDATE SET n=n+1")
count = db.execute("SELECT n FROM results WHERE name='scan-result'").fetchone()[0]
print(f"result_count={count}", flush=True)
db.close()
if os.environ.get("CRASH_BEFORE_ACK") == "1":
    print("exit after commit, before ACK", flush=True)
    raise SystemExit(23)
print("ACK scan-001", flush=True)
PY
先运行无去重模式。第 1 次运行在提交后以退出码 23 结束,第 2 次运行处理同一消息。若当前 shell 已启用 set -e,下面的 if 结构也能接住预期的失败,继续展示退出码。
if CRASH_BEFORE_ACK=1 python3 "$demo_dir/consume.py" "$demo_dir/raw.db" raw; then
  printf 'unexpected success\n'
else
  printf 'consumer exit=%s\n' "$?"
fi
python3 "$demo_dir/consume.py" "$demo_dir/raw.db" raw
预期先看到 result_count=1 和退出码 23,且没有 ACK;再次运行看到 result_count=2 和 ACK scan-001。这证明重复投递会让非幂等修改重复生效。进程退出码只能说明进程怎样结束,不能撤销退出前已经完成的持久化写入。排查时不能看见失败退出,就断言数据库没有结果。
接着换用新的数据库运行事务去重模式。seen 的唯一键与结果修改处于同一个 with db 事务中;重复消息不能插入相同 ID,因此跳过结果修改。
if CRASH_BEFORE_ACK=1 python3 "$demo_dir/consume.py" "$demo_dir/safe.db" safe; then
  printf 'unexpected success\n'
else
  printf 'consumer exit=%s\n' "$?"
fi
python3 "$demo_dir/consume.py" "$demo_dir/safe.db" safe
这次运行 2 次都应看到 result_count=1,第 2 次正常 ACK。不要把 raw.db 复用于安全实验,因为其中已有的结果没有对应去重记录。这里使用不同数据库,才能比较相同初始条件。实验结束后可保留临时目录检查结果;重新实验时重新创建目录,即可获得全新状态。
真实消费者还应记录消息 ID、投递次数、提交结果和确认结果,使这段窗口可被定位。实验只覆盖单机数据库效果,没有验证服务端持久化、网络确认、多个消费者并发或磁盘故障。迁移到真实消息服务时,保留同样的故障注入位置,再观察是否重投、ID 是否稳定,以及重复消息能否被正常确认,才算验证了完整接入链路。
5 吞吐与顺序取舍
提高吞吐通常依赖并发,但并发会改变完成顺序。消息按 A、B、C 到达,3 个消费者同时处理,B 可能先完成。即使服务端按序投递,处理完成和外部可见结果也未必按序。对文件任务而言,不同文件可以独立扫描;同一文件的版本更新若要求按序生效,就应使用稳定文件标识选择分区,并明确要求的是投递顺序、处理顺序还是结果生效顺序。
分区把较大的记录流拆成若干局部有序的流。同一分区若采用串行处理,可以保住该范围内的顺序,却也可能被 1 条慢消息挡住后续消息。严格顺序下,不能一边跳过失败任务,一边宣称后续任务仍按原顺序完成。增加分区能扩大并行度,但会影响键到分区的映射与运维约定;本课只使用固定分区,不展开在线扩分区协议。
用 λ 表示入口速率,μ 表示成功完成速率。在相同统计口径下,积压每秒大约变化 λ - μ 条。若已有积压 120000 条,入口为 600 条/秒,完成为 700 条/秒,净消化仅为 100 条/秒,理想排空需 1200 秒。把 120000 除以 700 会漏掉恢复期间仍不断到达的新消息。失败重试、负载波动和保留规则还会使实际时间偏离该估算。
交互中最多只有 4 个消费者同时负责 4 个分区,下游还把成功完成率限制在 700 条/秒。将消费者从 4 个加到 12 个,不会继续提高完成率。生产环境还可能受单条消息大小、文件读取速度、数据库锁等待和网络带宽影响。扩容前先确认瓶颈,否则会增加连接数、内存与下游竞争,甚至把原本稳定的依赖压垮。
批量接收或批量提交可以减少每条消息的固定成本,但会延长部分消息的等待时间,故障后也可能重放更大的批次。确认位置不能越过尚未完成的记录;若并发处理使后面的记录先完成,应按系统接口维护可安全提交的连续进度。入门方案优先选择能清楚解释的并发与确认规则,再用测量决定批量大小,不要直接追求最大吞吐数字。
6 常见坑:无死信却无限重试
扫描器收到格式错误的任务,缺少文件版本字段,每次解析都会失败。若立即重新投递,它会占用 CPU、产生重复日志,并阻挡有用任务。这类稳定触发失败的消息常被称为毒消息。网络短暂超时可能值得重试,永久的格式错误通常需要隔离;权限错误则应结合权限是否正在修复判断。仅凭“失败”这个共同标签,很难选择正确处理方式。
有限重试要约定次数、间隔和终点。例如初次失败后最多重试 5 次,间隔逐渐增加,并加入小幅随机扰动,避免大量消费者同时重试。应明确“5 次”是否包含初次投递,次数是跨进程持久保存还是仅存在内存中。若每次重启计数都清零,所谓有限重试仍可能变成无限循环。超时也不是失败的充分证据:下游可能已经提交,只是回复未到达。
死信是保存无法继续正常处理消息的隔离位置,不是自动修复器。应保留原始消息、稳定 ID、失败类型、首次与最近失败时间、累计次数和来源位置;敏感文件内容不必复制进错误日志。消费者只有在隔离写入按约定成功后,才能结束原任务。否则,先确认原任务再保存死信,中途退出就可能丢掉排查与恢复的唯一线索。
死信路径本身也会失败:没有写权限、目标磁盘满、网络不可达,都会让隔离无法完成。这时要限制入口、降低拉取或暂停相关消费者,并产生可见告警。不能为了让监控图变绿,直接确认所有失败消息。没有死信设施的简单系统,可以采用受控的错误表或隔离文件,但必须同样约定持久化、容量、访问权限和恢复责任。
修复解析逻辑或补齐文件后,重放应先选少量样本,再限制速率逐步放大。重放通常保留原任务 ID,让幂等逻辑继续起作用;若业务上确实要求重新扫描,应显式创建新的任务身份。还要标记重放来源,防止死信再次失败后又被自动搬回,形成无人注意的循环。隔离解决的是正常流量不再被坏消息反复挤占,处理责任仍然存在。
7 案例:积压拖垮磁盘与消费者
某扫描系统原本每秒接收 600 条任务,能成功完成 800 条。结果库响应变慢后,完成率降到 300 条/秒,消费者仍不断预取。待确认任务增多,扫描超时又触发重试;与此同时,消息服务的数据文件持续增长,消费者日志也开始大量记录相同错误。此时看到的是磁盘告警,起因却可能在下游。只扩磁盘会延缓耗尽,并不会恢复净消化能力。
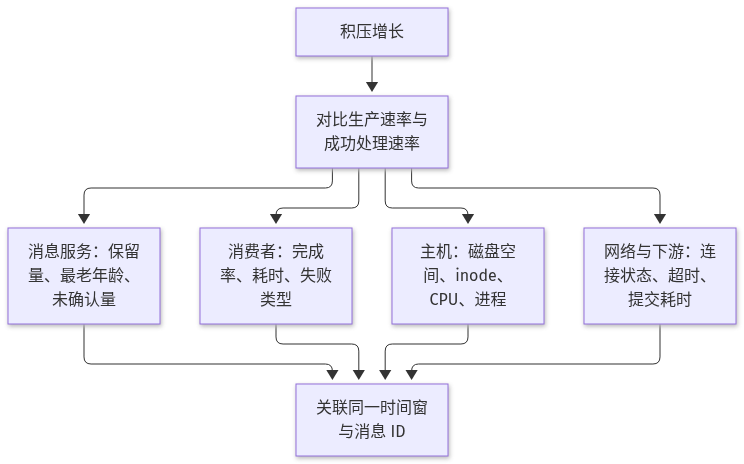
先对齐同一时间窗中的入口速率、成功完成率、最老未完成消息年龄、未确认量和重试量。最老年龄持续上升说明有任务等待越来越久;只有队列条数还不够,因为消息大小不同,磁盘占用也不同。日志模型中,消费者追上进度后,磁盘仍可能按保留规则保存已消费记录;因此“积压归零”与“磁盘立即回收”不是同一事件。
主机层面先做只读观察,以下路径与进程名要替换为实际部署值。df -h 检查空间,df -i 检查 inode;ps 查看进程状态与资源,ss 查看相关连接;若服务由 systemd 管理,再读取对应单元日志。命令能提供主机证据,队列深度和消费位置仍应从消息系统的管理接口或监控指标获取。
df -h /var/lib/msgdemo
df -i /var/lib/msgdemo
ps -eo pid,comm,stat,%cpu,%mem
ss -tnp
journalctl -u scan-consumer --since '15 minutes ago' --no-pager -n 200
ss -tnp 展示 TCP 连接状态及可见的进程信息,部分进程信息需要相应权限。连接存在只能证明当前有连接状态,不能证明某条消息已持久化或某次结果提交成功。日志中的超时也要关联消息 ID 与数据库结果,避免把“回复超时”误判为“操作未发生”。若服务运行在容器内,还要确认命令观察的是哪个网络与进程环境。
处置先保护恢复所需的数据:限制新任务入口,降低预取和并发,把确定的毒消息隔离,再恢复下游能力。不要手动删除消息服务的数据文件;它们可能同时承载未处理记录、索引与恢复信息。若需要释放空间,应按服务支持的保留或归档流程执行,并先确认会失去哪些重放范围。消费者日志也应有轮转和容量限制,防止错误日志与消息数据争抢磁盘。
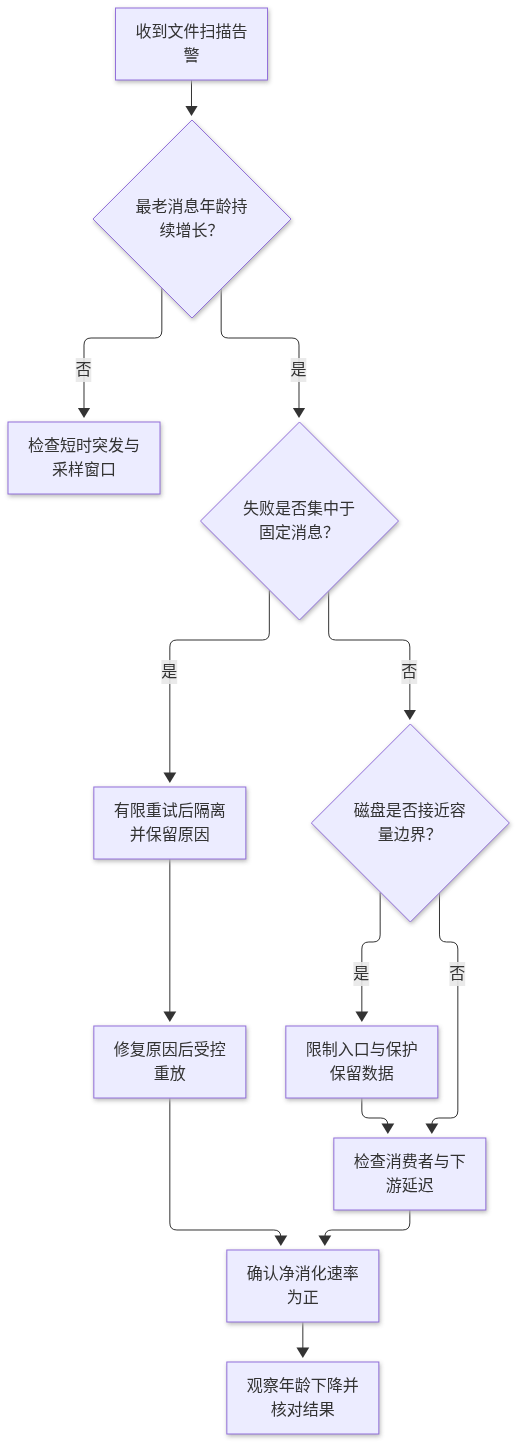
恢复后观察成功完成率是否持续高于入口,估算排空时间,并确认最老年龄逐步下降。还要抽查扫描结果、死信和重复处理记录,避免只是把任务提前确认造成表面恢复。即使增加消费者后 CPU 利用率升高,也不能证明完成能力提高。最终验收应使用成功提交的有效结果,而不是拉取次数、线程数或日志中的“开始处理”条数。
8 把投递语义写进集成方案
接口方案先写消息契约:任务 ID 如何生成,文件标识与版本怎样表达,消息结构如何标记版本,哪些字段必填。消费者遇到不支持的结构版本,必须有可观测的拒绝或隔离行为。消息大小也要有限制;大文件通常放在文件存储中,通过可验证的引用读取,并让文件保留时间覆盖任务等待和恢复窗口。否则消息保留得再久,消费者拿到的也可能只是失效路径。
然后分别写出生产成功和消费成功的条件。生产者超时后以相同任务身份重试,消费者完成本地事务后才确认;确认超时后的重复投递由幂等逻辑吸收。业务结果如果还要调用远端服务,应单列该调用的幂等键与查询方式。不能把消息服务的确认成功,当成文件操作、数据库写入和远端调用全部成功的证明。
顺序与容量也要落到可检查的范围。例如约定“相同文件标识进入同一分区,按版本顺序处理;不同文件允许并行”,比写“保证有序”清楚。容量记录中至少包含正常入口、突发持续时间、实测完成率、平均消息大小、保留窗口和磁盘余量。估算积压占用还要给复制、索引、已消费但仍保留的数据留出空间,不能只用任务条数乘消息正文大小就决定磁盘规格。
最后写运行责任:谁接收最老年龄与磁盘告警,谁判断失败类型,谁能暂停入口,谁审批或执行历史重放。验收可以选择 3 个故障窗口:发送后未收到生产确认、结果提交后未发送消费确认、死信写入失败。每个窗口都应有预期的消息状态、结果状态、恢复动作与证据。这样“可靠”才能变成可重复检查的行为。
9 从消息系统走向数据库内核(S57)
本课反复遇到同一个问题:进程说“完成”时,哪些事实已经留在可恢复的存储中?消息服务需要在接收确认前达到约定的持久化条件,消费者需要把去重记录和扫描结果一起提交。操作系统提供进程、文件与写入接口,但“程序调用了写入”并不天然等于“任何故障后都能恢复”。应用必须依赖明确的存储保证,而不是凭日志打印的位置猜测。
数据库把许多相关修改组织为事务,使实验中的去重记录与结果能够共同成功或共同撤销。唯一约束让重复身份有可检查的冲突,持久化与恢复机制则让进程重启后仍能辨认已提交事实。下一课 S57 将从这些需求走向数据库内核,解释数据库为何需要记录修改、组织页面和恢复状态;本课不提前展开日志刷盘、索引结构与并发控制算法。
迁移时保留 3 个问题:提交成功具体承诺什么,崩溃后依据什么判断状态,重试如何避免重复修改。消息系统让这些问题发生在生产者、服务和消费者之间;数据库内核则把视角收进存储内部。能说清任务交接和本地事务的边界,就已经具备理解下一课的入口,而无需先背完所有内部组件名称。
放进方案里
文件扫描链路采用可持久保留的消息服务,消息包含稳定任务 ID、文件标识、文件版本与扫描规则版本。文件引用必须在正常等待、有限重试和允许重放期间有效;消息不承载完整文件。生产者以接口约定的持久化接收确认为成功条件,遇到超时使用相同任务身份重试,并记录发送状态供核对。
消费者在结果数据库的同一个事务内写入去重记录与扫描结果,提交成功后才确认消息。重复投递命中唯一约束后读取已有结果并正常确认。该约定覆盖本地数据库效果;外部文件修改或远端调用分别约定幂等键与恢复方法。相同文件的任务按固定键进入同一分区并串行处理,不同文件允许并行;重放沿用原 ID,主动重新扫描则创建明确的新任务身份。
上线前测量正常入口、突发持续时间与成功完成率,结合保留窗口、复制与索引开销安排磁盘余量。监控待处理量、未确认量、最老年龄、有效完成率、重试与死信数量,同时观测磁盘空间、inode 和下游提交耗时。持续积压时先限制入口与预取,再修复瓶颈,恢复期间以净消化速率估算排空时间。
格式错误直接隔离,暂时性错误最多重试 5 次,不含初次投递,采用递增间隔与随机扰动,次数跨重启保留。死信保存原消息、错误与时间,隔离持久化成功后才结束原任务;隔离失败必须告警并限制继续拉取。运维负责容量与限流,扫描服务维护者负责错误修复及受控重放。验收覆盖确认丢失、提交后退出和隔离失败,并核对结果、任务状态及恢复证据。
10 小结:下一步数据库内核(S57)
消息系统管理异步交接、缓冲与恢复。队列与日志决定如何分配任务和保留进度,确认时机决定故障窗口,事务幂等把重复投递收敛为可接受的结果。顺序限制并发,持续积压消耗磁盘,重试必须有终点和责任人。
自测时试着解释:结果提交后退出为何会重投?同组消费者为何不能代表 2 类独立订阅?完成率高于入口后,磁盘为何仍可能不下降?如果能沿消息状态、结果状态和保留规则回答,就可以进入 S57,继续研究数据库如何守住提交与恢复的边界。