1 内核调优要回答什么
同 1 台 Linux 主机,交互式 shell 很流畅,接入突发连接时却出现超时;文件读取很快,批量写入时请求尾部延迟却突然升高。这些现象都可能与内核管理资源的方式有关,但不能据此直接判断“内核参数太保守”。应用没有及时处理连接、进程忙于计算、文件系统所在设备响应缓慢,也会产生相似症状。内核调优首先要回答:哪个可观察的限制,在什么负载下,影响了哪个目标?
内核负责在进程之间分配 CPU 时间,管理内存与文件访问,并为程序提供网络接口。可调整参数是这些管理行为暴露出的控制入口。入口可以改变排队容量、资源限制或处理时机,却不能凭空增加 CPU、存储吞吐和应用处理能力。扩大等待区能够容纳短时突发,也可能只是让更多工作等待更久。把“参数更大”理解成“系统更快”,会把容量问题变成延迟问题。
调优目标必须写成可以判定的句子。例如:“固定服务版本,在每秒 300 次新连接、持续 60 秒的负载下,连接失败率低于 1%,请求延迟的 p95 低于 100 毫秒。”p95 表示按耗时排序后,约 95% 的请求不超过这个值。这个目标同时约束成功率和响应速度,避免把超时隐藏在平均值里。数值只是实验示例,实际目标应来自服务约定和已有测量。
还要明确观察对象。某个进程的文件描述符上限,某个网络命名空间里的连接队列上限,以及整台主机的 CPU 利用率,属于不同范围。改动主机可见的值,不代表容器内服务一定采用了该值;调整当前 shell 的限制,也不会自动改动已经运行的服务。实验记录应包含主机、服务进程、监听端口和执行命令的位置,让“改了哪里”能够被复核。
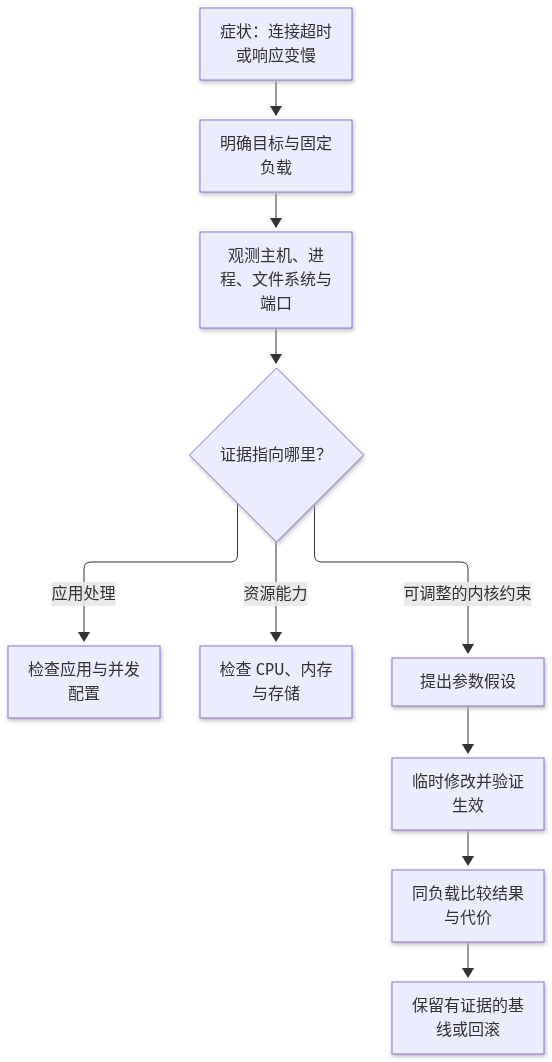
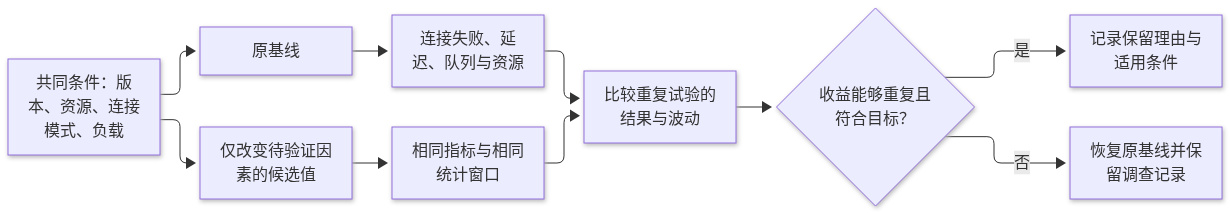
可以把调优分为 3 类动作:先测量症状,再改变可解释的约束,最后用相同负载比较。每次只改变 1 个待验证因素,其他条件尽量固定。假如同时换服务版本、增加进程、修改队列容量,即使结果变好,也难以判断哪个动作有效。这样的结果可以作为容量扩展的记录,却不足以成为某个参数有效的证据。
本课以 Linux 的 sysctl 和监听连接排队为主要入口,也会观察进程、文件系统和 shell 限制。命令中的端口 18080 只用于本机实验,实验应在允许重启、没有真实流量的独立主机或虚拟机中完成。不同内核版本和工具版本可能显示不同字段,因此既要记录值,也要记录环境。遇到系统没有提供的接口,应说明缺项,不能用猜测填补结果。
最后,内核调优应该产出可以交接的结论:为什么改、改前是什么、改后发生什么、何时撤销。没有发现值得修改的参数,也可以是有效结论。如果证据指向应用处理过慢,应把改进交给应用;如果设备已达到能力边界,应讨论资源配置。调优的价值是缩小不确定性,而不是让配置文件变得更长。
2 sysctl、限流与调度参数
Linux 把部分运行参数呈现在 /proc/sys/ 下,sysctl 提供按名称读取和写入的命令接口。例如 net.core.somaxconn 对应 /proc/sys/net/core/somaxconn。执行 sysctl net.core.somaxconn 是读取当前值;在有权限的环境里执行 sudo sysctl -w net.core.somaxconn=256 是修改运行值。命令成功只说明这次写入被接受,不能证明应用吞吐提升,也不能证明重启后仍然保留。
uname -r
sysctl net.core.somaxconn
cat /proc/sys/net/core/somaxconn
以上是课内供学习者执行的命令示例。读取 2 个入口可以帮助理解名称与路径的对应关系,日常记录通常保留其中 1 种即可。并非所有内核设置都属于 sysctl,也不是所有值都能写。有的接口取决于内核构建,有的需要额外权限,有的在当前环境中受限。出现“文件不存在”或“权限不足”时,应先核对环境与范围,不要为了让命令通过而放宽整台机器的权限。
运行值与持久化配置需要分开理解。直接写 sysctl 的效果通常不会跨越主机重启;常见系统可从 /etc/sysctl.conf 或 /etc/sysctl.d/ 中加载设置,但加载工具、顺序和覆盖关系要以实际系统为准。实验阶段先做临时修改,确认有效再进入配置管理。不要把试过的每个候选值都写进持久化文件,否则下次启动可能恢复的是未通过验证的组合。
“限流”与“队列容量”也不是同义词。限流约束单位时间内允许进入或处理的工作量,超过部分可能被拒绝或延后;队列约束可以保存多少等待中的工作。到达速度持续高于处理速度时,增大队列只会延后溢出。限制并发、请求超时和重试通常还涉及应用配置,不能期待某个 sysctl 统一控制所有入口。参数名称相似,也不能替代对接口语义的确认。
文件描述符提供另 1 个范围清晰的例子。进程打开文件和网络连接都需要描述符,当前 shell 可用 ulimit -Sn 与 ulimit -Hn 查看软、硬限制,已经运行的服务可查 /proc/PID/limits。这里的 PID 应替换为真实进程号。系统总量限制、进程限制和服务管理器配置是不同层面的约束;只改系统总量,进程仍可能报告 Too many open files。
调度方面,本课只建立“资源由竞争者共享”的直觉。nice 值可以影响常规调度下的相对优先关系,但不承诺给进程固定比例的 CPU,也不能解决存储等待。ps -eo pid,ni,stat,comm 能帮助查看进程状态与优先级。没有证据时,不要修改内核调度参数或把服务改成实时调度;这些操作可能损害主机的可响应性,细节留到后续专门学习。
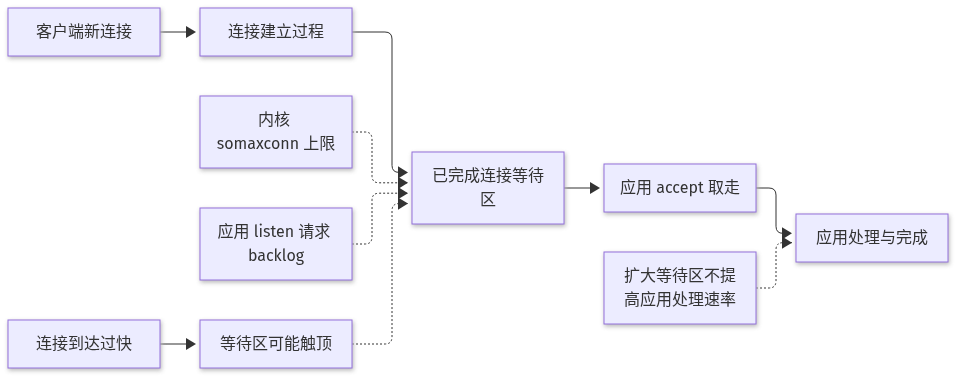
对每个准备修改的参数,至少先说清楚它限制什么、作用在哪个范围、由谁读取、何时生效。以监听队列为例,内核上限与应用请求的 backlog 都参与决定有效容量。sysctl 中出现了新值,并不意味着已经运行的监听端口采用了期望容量。把这些边界画出来,比背诵某份“性能参数大全”更适合入门,也更容易解释后面的实验结果。
3 观测先于调参的证据链
证据链从用户能感受到的失败开始:连接建立失败、请求超时、处理变慢,或者文件操作报错。记录开始与结束时间,再把症状与主机、进程、端口指标放到同 1 个窗口里。只截取故障结束后的 CPU 空闲图,不能否定故障期间发生过拥塞;只看到队列变大,也不能判断用户是否受影响。时间对应是把观察结果连接起来的前提。
主机层先判断资源压力。vmstat 1 10 可以观察运行队列、内存活动和等待情况,分析时注意首行可能是自启动以来的平均值;df -h 与 df -i 分别帮助发现空间或 inode 耗尽。文件系统写入失败时,先处理容量和权限,再讨论缓存参数。若安装了相关工具,iostat -xz 1 10 可辅助观察块设备负载,但单个百分比不能替代对实际读写延迟的判断。
进程层确认“谁在使用资源”。ps 能定位进程,top -p PID 可持续观察指定对象,/proc/PID/limits 可以核对限制。服务日志中的 EMFILE、连接超时或工作线程阻塞,应与同窗口指标对照。CPU 利用率低不一定表示处理能力充足,进程可能正在等待文件读写、锁或外部服务。本课不展开这些内部机制,但要保留“忙于计算”和“等待完成”的区别。
date -Is
vmstat 1 10
df -h
df -i
ss -lnt 'sport = :18080'
nstat -az TcpExtListenOverflows TcpExtListenDrops
监听端口可通过 ss -lnt 查看。对 Linux 上处于 LISTEN 状态的 TCP 套接字,Recv-Q 通常表示等待应用接收的已完成连接数,Send-Q 表示该监听套接字的 backlog 上限。必须结合状态理解字段,不能把建立连接状态下的队列字段解释直接搬过来。如果工具输出与预期不符,先核对版本和完整表头,再下结论。
ListenOverflows 与 ListenDrops 等计数能提供辅助证据,但通常是所在网络命名空间内的累计值,并不是当前端口的专属计数。应该记录负载前、负载后的读数并计算增量,同时确认没有其他监听服务产生干扰。nstat 的选项与计数显示依版本而异,示例中 -a 请求绝对计数,-z 保留零值。计数增加支持继续调查排队问题,不能单独证明某个应用应当扩大队列。
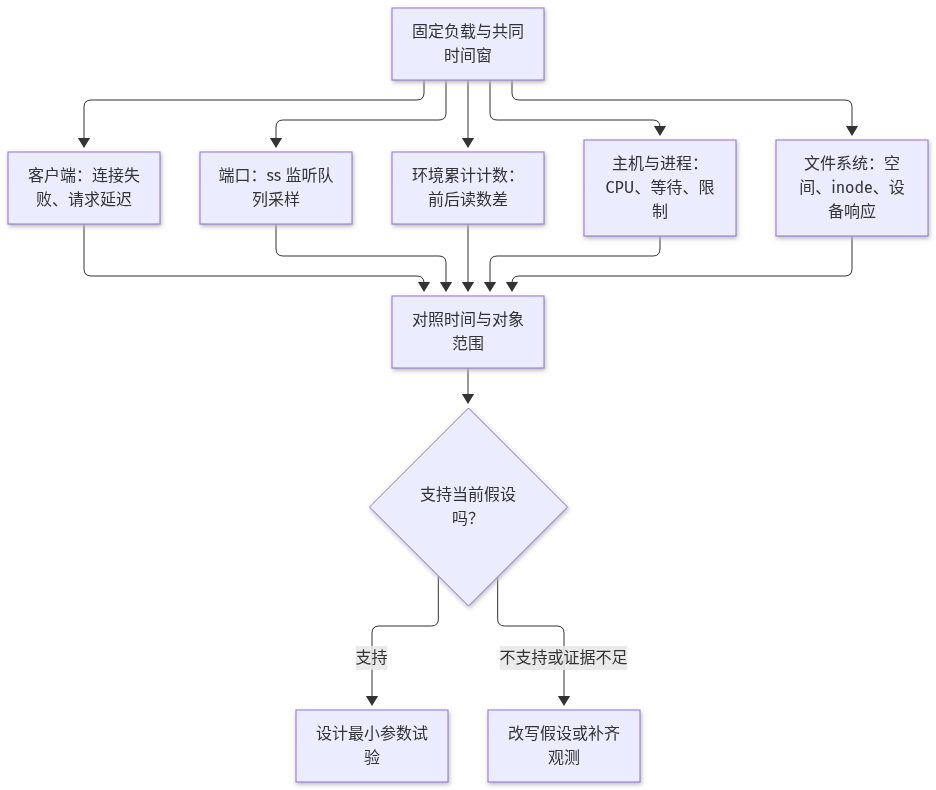
基线还包括负载条件。记录发起端位置、连接速率、并发连接数、持续时间、超时设置,以及应用是否复用连接。每秒请求数与每秒新连接数不是同 1 个量;长连接上的大量请求未必持续消耗监听队列。负载工具自身达到 CPU 或连接限制,也可能让目标主机看起来很轻松。至少检查发起端错误,避免把“没有发出足够负载”记成服务承受能力很强。
最终把证据组织成可反驳的假设:“在固定到达速率下,应用短时取连接偏慢,已完成连接队列触顶,随后客户端连接超时;提高有效队列可能减少短时失败。”这个句子同时给出了条件、路径和预期。假如队列始终很短,或超时主要发生在连接建立后,那么假设就需要改写。观测先于调参,意思正是允许证据否定最初的直觉。
4 动手:用一次负载验证参数生效
本实验只验证监听队列容量的关系,不能当作服务吞吐基准。准备 2 个终端运行服务与检查命令,再用另 1 个终端发起负载;所有连接都指向 127.0.0.1:18080。先确认端口没有被占用,并记录 sysctl net.core.somaxconn 的原值。需要修改内核值时,使用独立实验环境;端口冲突时先改用空闲端口并同步修改所有命令,不要停止未知进程。
下面的 Python 程序显式请求 backlog 为 128。它每接收 1 个连接就休眠 0.05 秒,故意降低取连接的速度,让短时排队容易观察。这个休眠是实验负载条件,不是实际服务应采用的实现方式。程序把监听地址绑定到本机回环接口,并把 backlog 作为启动参数,以便在后续试验中只改变明确的变量。
# 保存为 slow_accept.py
import socket
import sys
import time

backlog = int(sys.argv[1])
with socket.socket() as server:
    server.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
    server.bind(("127.0.0.1", 18080))
    server.listen(backlog)
    print("listening", backlog, flush=True)
    while True:
        conn, address = server.accept()
        time.sleep(0.05)
        conn.close()
先临时把实验环境中的 somaxconn 设为 32,再运行 python3 slow_accept.py 128。如果原值已经是 32,也应记录它。用 ss -lnt 'sport = :18080' 查看监听状态;在常见 Linux 环境中,应用请求的 128 会受内核上限约束,显示容量应体现这个限制。若没有观察到预期,先停止实验,核对命令所在环境与监听进程,不要继续叠加改动。
负载程序建立 96 次连接尝试,使用 96 个工作线程,每次连接超时为 1 秒。输出中的成功仅表示 connect 返回成功,失败表示这次连接尝试发生异常;它不测量应用请求完成,更不代表后续处理成功。每次连接关闭都会产生后续状态,重复实验应留出安静间隔,确认监听队列回落,且主机没有其他明显压力。
# 保存为 connect_burst.py
import socket
from concurrent.futures import ThreadPoolExecutor

def attempt(_):
    try:
        with socket.create_connection(("127.0.0.1", 18080), timeout=1):
            return True
    except OSError:
        return False

with ThreadPoolExecutor(max_workers=96) as pool:
    results = list(pool.map(attempt, range(96)))
print({"connected": sum(results), "failed": len(results) - sum(results)})
运行 python3 connect_burst.py 前后记录监听状态和累计计数,并在负载期间用另 1 个终端持续采样 ss。可以用 watch -n 0.2 "ss -lnt 'sport = :18080'",但短时峰值仍可能落在采样间隔中。第 1 轮可能看到排队增长和连接失败,具体数量受调度与时序影响,不能要求所有机器都产生相同数字。保留完整结果,允许实验不符合预期。
接着停止服务,临时设置 somaxconn=256,仍以 backlog 128 启动同一程序,保持连接尝试数与超时不变,再运行负载。读取 sysctl 验证运行值,读取 ss 验证监听端口容量,比较连接失败与队列变化。为了使结论更稳妥,每个条件可运行 3 轮并记录波动;这里的“一次负载”指固定的验证负载,不意味着单个样本就足够代表所有运行情况。
预期现象是有效队列扩大,短时连接成功数可能增加;每次接收后固定休眠的服务并没有因此获得更高处理速率。实验结束先停止服务,再把 somaxconn 恢复为记录的原值并读取确认。不要写持久化配置。若失败率没有改善,应保留结果,检查实际队列、负载时序和其他限制;这比为了得到“成功截图”不断加大参数更有学习价值。
5 激进调优与可回滚取舍
设想应用每秒只能稳定处理 100 个连接,外部连续以每秒 150 个连接到达。只要这种差距持续存在,任何有限队列最终都会满。较大的队列可以吸收短时突发,却不能解决持续超载。假如额外排队 200 个连接,且处理速度维持每秒 100 个,仅消化这些等待就需要约 2 秒;这个估算忽略了新到达和其他开销,但足以提示等待时间的代价。
因此,“失败更少”不是唯一目标。队列变大以后,客户端可能先等到超时,再进行重试;原请求仍在等待,重试又带来额外工作。需要同时观察连接成功、请求完成、延迟、超时和资源使用。若只统计连接是否建立,就可能把压力从连接阶段搬到处理阶段,让面板上的成功率变好,而用户实际等待更久。
交互中的参数只表达容量与等待之间的关系,不推荐任何生产数值。拖动队列容量时,应先问突发持续多久,再问服务恢复正常后能否及时清空等待。如果可接受等待只有 300 毫秒,能够排很长的队列未必有意义。若入口已经实施明确拒绝与客户端退避,较小队列反而可能让系统更快恢复;如何选择取决于服务目标与实际测量。
资源占用同样要进入取舍。排队连接及其关联状态会使用资源,具体成本依内核、协议状态和应用行为而变化,不能简单写成固定字节乘以队列容量。扩大文件描述符限制也不会自动给程序更多内存;允许更多并发后,程序可能更早遇到内存压力。每次放宽限制,都应检查之前被挡住的工作将在哪里继续消耗资源。
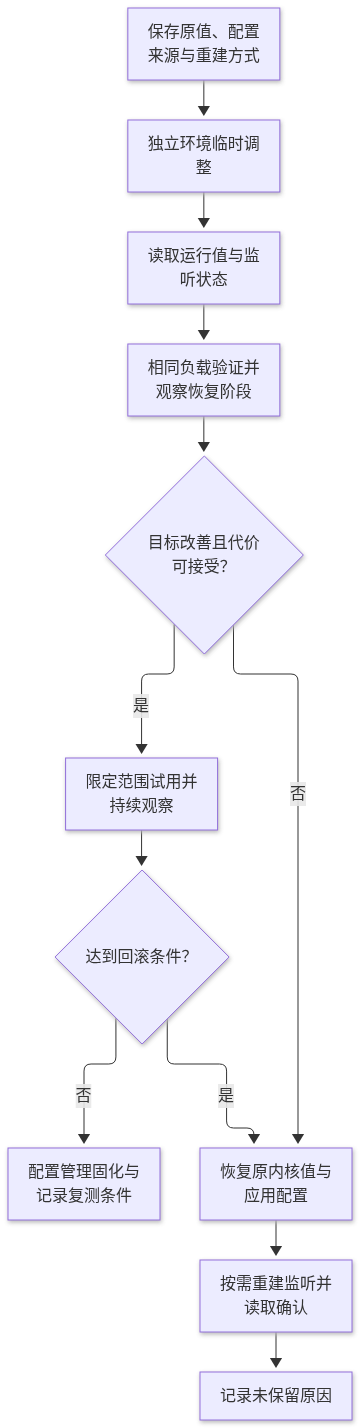
可回滚需要提前设计。修改前记录原值、持久化来源、应用启动参数、服务重建方式和执行账号。对监听队列,回滚不能只把 sysctl 写回去,还要恢复应用配置,并按实际服务管理方式重建监听、再次读取端口状态。由于既有监听状态不应被假定会自动随上限变化,回滚验证与正向验证应采用同样严格的标准。
在真实运维中,先选择影响范围明确的主机或实例,在可控窗口施加可比较负载,再根据服务目标判断是否扩大范围。观察窗口应覆盖典型突发和恢复阶段,不能刚看到错误下降就结束。提前约定撤销条件,例如请求 p95 超过目标、内存持续增长或失败率未改善;达到条件时恢复已知基线,而不是临时再改几个参数寻找补救。
有些场景更适合不改内核:应用取连接过慢,先检查工作进程是否阻塞;文件写入耗时变长,先确认设备与文件系统状态;CPU 竞争明显,先识别竞争进程与资源配置。内核调优不是最后的万能手段,而是有明确适用边界的改动。愿意保留默认值、写清证据不足,也是对稳定性负责的技术判断。
6 常见坑:复制网贴参数不验证基线
网上的参数清单经常省略环境:没有内核版本,没有负载类型,也没有原值和失败表现。清单中的某个值也许解决过特定问题,但换到当前主机可能已经低于默认值,或者对应接口已不再适用。把整段内容加入配置,相当于同时改变许多未知条件。故障发生后,很难区分是原问题恶化,还是新配置带来了另外的问题。
第 1 个常见坑是把“写入成功”当成“调优成功”。sysctl -w 返回新值,证明的是运行接口接受了设置;还需要验证作用范围、应用是否采用,以及相同负载下目标指标是否改善。如果服务在容器里,而命令在宿主机执行,应通过受管理的容器工具核对其实际环境。某些参数受命名空间隔离,某些限制属于进程,不能把宿主机读数直接当成服务的全部状态。
第 2 个坑是没有基线。仅提供修改后的失败率 0.5%,不知道修改前是否也是 0.5%,无法判断收益。改前后如果负载速率、连接复用、数据规模或后台任务不同,也不能直接归因。应保存相同格式的记录,明确每轮开始时间、持续时间和实际发送量。出现偶然好结果时,要看重复运行的波动是否足以解释这次变化。
第 3 个坑是混淆临时配置和启动配置。有的值被手工修改后运行正常,重启却恢复;有的值在多个配置文件中重复出现,后来加载的内容覆盖了前面的设置。不要为了“确保生效”到处追加同名键。应先确认当前系统的加载规则,把最终配置收敛到明确来源,再按规定方式验证加载结果。实验命令记录与正式配置应当能够相互对应。
第 4 个坑是把不同故障归到同 1 个“网络慢”。Connection refused、连接建立超时、已连接后读取超时,指向的检查入口不同。前者应先确认端口监听和拒绝来源,连接超时还需要检查可达性与入口排队,读取超时则要查看应用处理。文件系统空间耗尽导致服务写日志失败,也可能拖慢服务,却不是增大网络队列能解决的问题。
第 5 个坑是忽略观测工具的边界。看到监听 Recv-Q 为 0,不能断言整个窗口都没有排队,因为采样可能错过峰值;看到累计丢弃计数很大,也不能说明刚才发生过丢弃,因为它可能来自过去。要比较增量,记录采样间隔,并结合客户端结果。工具未安装时应记录观测缺口,不要把“没有读到指标”写成“指标正常”。
更好的做法是把外部建议当成待验证假设。先用自己的话写出机制预期,再挑出最小改动,最后准备能推翻假设的观察项。如果无法解释某个参数的作用,就先不改它;如果收益落在测量波动内,就不宣称已经优化。配置的可信度来自与当前主机的证据匹配,而不是来自参数数量或看似激进的数值。
7 案例:somaxconn 调大却应用未听
某个 TCP 服务在短时连接高峰出现连接超时。运维人员把 net.core.somaxconn 从 128 调到 1024,读取也确认是 1024,但失败率没有明显变化。应用日志没有崩溃,CPU 也不高。这里不能立即推断“内核参数无效”,更不能继续把数值翻倍。首先要确认:失败发生在连接阶段还是业务处理阶段,修改发生在哪个环境,端口实际采用多大队列。
检查 ss -lnt 'sport = :18080',发现对应 LISTEN 行的 Send-Q 仍然是 128。继续查看服务启动配置,发现框架显式请求 backlog 128,而且修改 sysctl 后并未重建监听。这个案例里,“应用未听”指应用监听配置没有采用期望值,并非端口完全没有监听。若根本没有 LISTEN 行,应先定位进程启动或绑定失败,那是另一条排查路径。
对本课讨论的 Linux 已完成连接等待队列,可以用“应用请求的 backlog 受内核上限约束”理解容量。应用只请求 128 时,内核上限提高到 1024,不会替应用主动请求 1024。反过来,应用请求 1024,但内核上限仍是 128,也不能据此得到期望容量。这个关系是入门模型,不能拿它去推断所有连接阶段和其他队列的行为。
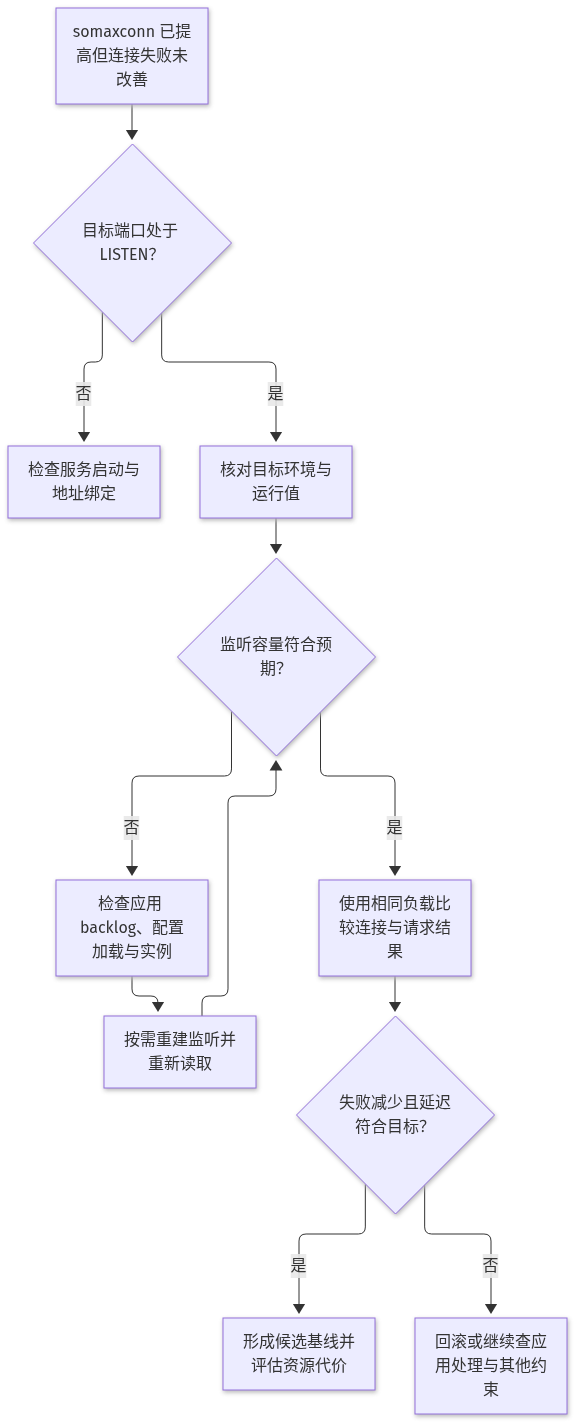
排查人员先保存原应用配置,再在实验副本中把 backlog 请求值设为 512,并按服务管理方式停止、启动,使监听套接字重新建立。随后核对新进程号与启动时间,检查 sysctl 仍为 1024,检查端口显示的容量是否符合预期。若端口仍是 128,应继续查配置是否被实际加载、是否命中了正确实例,以及是否还有默认值覆盖;此时不应进入负载结果比较。
确认容量变化后,使用同样的连接突发负载再次测量。如果队列触顶次数减少,连接失败率下降,而请求完成延迟仍在目标内,可以支持“短时排队容量不足”的判断。若连接成功增多但处理超时也增多,则只是把等待向后转移。此时应回到应用接收与处理能力,检查是否有阻塞操作或并发限制,不能仅凭连接成功就批准长期保留改动。
还要检查证据的归属。主机可能同时有多个监听服务,累计的 ListenOverflows 增量未必都来自目标端口;连接发起端也可能因为自身资源不足而失败。案例结论应同时引用目标端口队列、明确的负载窗口与客户端结果。缺少其中的对应关系时,只能说“观察到相关变化”,不能把所有改善都归功于这次队列调整。
这次案例的关键修正不是找到更大的数,而是补齐生效链:运行参数写入、应用配置加载、监听状态建立、实际负载验证。最终方案还应记录回滚应用 backlog 与内核值的顺序,并说明是否需要重建监听。这样下次遇到相同现象时,接手者可以逐段检查,而不会重复执行同 1 条 sysctl 命令等待结果改变。
8 把调优基线写进主机方案
主机方案中的基线既包含参数值,也包含这些值成立的条件。只写 net.core.somaxconn=512,不能说明适合什么服务;还要写内核版本、服务版本、监听配置、资源规格和测试负载。运行在不同规格主机、不同应用版本或不同连接模式下的服务,可能需要重新验证。基线是可复用的起点,不是跨环境永久有效的最佳答案。
建议用 1 张简洁记录表连接“理由”与“动作”。参数名称与单位帮助准确执行,原值与候选值支持回滚,作用范围与生效方式避免改错对象,目标指标与结果说明是否值得保留。没有发生改变的相关限制也可以记录,例如进程文件描述符上限,用于解释为什么实验没有碰到另外的瓶颈;但不必收集与假设无关的大量配置。
| 记录项 | 本课案例中的内容 |
|---|---|
| 目标与症状 | 固定连接突发下减少连接失败,并守住延迟目标 |
| 环境与范围 | 内核版本、目标服务进程、网络命名空间、18080 端口 |
| 原值与候选值 | somaxconn 原值、应用 backlog 原值、各自候选值 |
| 生效证据 | 读取运行值,核对重建监听后的 ss 输出 |
| 收益与代价 | 失败率、请求延迟、资源变化、重复试验波动 |
| 撤销方式 | 恢复内核值与应用配置,重建监听并重新读取 |
正式配置应进入团队使用的配置管理流程,避免只存在于某个管理员的 shell 历史里。先检查现有来源,再决定由哪个文件或模板负责,避免同名参数在多个位置竞争。与服务启动相关的设置应和服务配置一起交付;与主机初始化相关的设置则进入主机配置。交接文档需要描述实际采用的加载机制,不能假定所有 Linux 系统都使用同样的启动工具。
还应把“何时重新测量”写进方案。服务升级、连接复用策略改变、主机规格变化,或者负载突发持续时间变长,都会影响原结论。参数没有变,不代表假设仍然成立。可以在变更检查中保留端口容量、进程限制和关键结果指标,让基线漂移更早被发现;如果观察到新瓶颈,应新建验证记录,而不是在旧结论后面不断追加数字。
观测命令本身也需要交付。记录使用 ss 查看哪个端口、用哪个窗口比较累计计数、客户端如何统计连接失败,并说明字段含义与限制。命令应尽量只读、输出范围明确,避免把整台主机无关信息大量收集进报告。日志中若含有账号、路径或连接地址,应按实际管理要求保留必要信息,使方案可用而且便于共享。
验收时不能只问“值对不对”,还要问“结果是否满足目标”。运行值正确但请求延迟变差,说明改动尚未通过验收;结果暂时变好但无法解释负载差异,也不能认定有效。允许结论写成“本次不保留,恢复原基线,原因是收益不稳定”。这种记录能避免后续人员再次投入同样的试验,并为将来条件变化后的重新评估提供参考。
把这些内容放进方案以后,调优就成为可审阅的运维变更:有范围、有执行入口、有结果、有撤销条件。即使原执行者不在场,接手者仍然能判断参数为什么存在,以及是否可以安全恢复。对入门学习者而言,这种可交接性比记住更多参数更重要,因为它把命令操作连接到了长期运行的主机管理。
9 从内核调优走向eBPF(S46)
到这里,我们已经能用现有工具建立基本证据链:客户端告诉我们是否失败,进程与主机指标提示资源压力,端口状态展示监听排队,运行参数和应用配置说明容量边界。对许多常见问题,这些信息已经足够。无需因为存在更强的工具,就把每次故障都变成复杂观测工程。先用成本低、含义清楚的证据缩小范围,通常更有效。
但普通采样也有边界。每隔 1 秒读 1 次指标,可能遗漏持续几十毫秒的突发;累计计数告诉我们发生过变化,却未必指出具体进程或发生位置。假如确认服务在某个时间窗里频繁等待,却仍无法判断等待集中在哪里,就需要更细的运行证据。这个需求应由尚未回答的问题提出,而不是由工具的新颖程度提出。
S46 将介绍 eBPF 作为进一步观测的入口,本课只预告它能帮助把部分运行事件与对象联系起来,不展开程序结构、挂载点或内核实现。学习重点仍然是从明确问题出发选择证据,并解释观察边界。更细的记录也不是自动得到原因;时间上同时发生的事件,需要结合负载和系统行为才能形成可靠判断。
进入后续学习前,可以整理 1 张“问题缺口卡”。例如:已知连接失败在突发后升高,已知端口采样偶尔接近容量,但还不知道应用何时停止及时取连接。卡片应列出现有证据、无法确定的部分,以及如果获得新证据会如何改变决策。这样下一课的观测动作就有具体目标,不会变成收集大量事件后再寻找故事。
也要保留对开销和权限的意识。任何持续采集都可能消耗 CPU、内存或输出空间,工具所需权限也取决于系统配置。后续选择观测方式时,应优先明确采集范围和停止条件,再确认环境是否允许。这里不提供绕过限制的做法,也不把复杂工具当成调参的前置门槛;本课的只读检查和可回滚实验已经可以独立使用。
在转换工具之前,先复述当前结论的强弱。如果仅知道“队列曾经接近容量”,就不能宣称“所有连接失败都由队列引起”;如果只验证了本机突发,结论就应限定为该负载和环境。清晰描述未知部分,可以帮助后续决定是增加采样、检查应用日志,还是引入新的观测手段。承认证据边界,会让工具选择更加节制。
本课留下的工作方法可以继续沿用:明确目标,定位范围,保存基线,形成假设,用固定负载验证,再决定保留或回滚。eBPF 不会替代这些步骤,而是可能让其中的观测更精细。带着已经写好的主机基线和问题缺口进入 S46,才能把更丰富的事件信息转化为可靠的运维判断,并继续避免“看到参数就改”的习惯。
放进方案里
在主机方案中增加“内核调优基线”条目,先用业务可验收的指标说明目标,再列出服务版本、内核版本、主机规格、监听端口与执行环境。明确本次处理的是连接建立阶段的短时排队,还是其他已证实的资源约束。没有证据指向内核参数时,方案应保留默认配置,并记录继续调查的方向。
为每个候选项写清原值、候选值、作用范围和生效方式。以 somaxconn 为例,同时记录应用请求的 backlog、服务如何重建监听,以及使用哪条 ss 命令核对实际容量。先在独立环境临时试验,验证通过后再进入明确的持久化来源,避免把手工运行值与启动配置混为一谈。
验证部分写明负载来源、连接速率、并发量、持续时间、超时和重复轮次,保持改前改后条件一致。结果至少包含连接失败率、请求延迟、队列变化与资源压力,并说明累计计数的增量窗口。不能只附参数截图,也不能把连接建立成功直接写成业务请求成功。负载或采样存在缺口时,结论应标明限制。
上线范围和回滚条件应提前约定。先在影响范围明确的实例观察,覆盖突发与恢复阶段;若延迟超过目标、资源持续增长或收益无法重复,就恢复原内核值与应用配置,按需要重建监听,再读取确认。记录撤销执行者所需的权限与操作入口,使回滚不依赖原调优人员在场。
最后写明保留结论与复测触发条件。服务升级、主机规格变化、连接模式改变后,应重新检查假设。方案中每个长期保留的参数都要能回答:它解决什么问题,证据保存在哪里,代价是否可接受,什么时候可以撤销。这样的基线才能成为后续观测与 S46 学习的可靠起点。
10 小结:下一步eBPF(S46)
内核调优把明确的运行问题转换成有证据的配置取舍。sysctl 运行值、进程限制和应用配置属于不同入口;参数写入、监听生效与负载改善也需要分别验证。队列可以吸收突发,持续处理能力仍然受实际资源和程序行为约束。
请自查 3 个问题:somaxconn 已提高而监听容量未变时,下一步查什么?累计丢弃计数为什么要比较同窗口增量?连接成功率改善、请求延迟恶化时,是否应该保留改动?能够解释这些问题,再带着尚未回答的观测缺口进入 S46,学习 eBPF 的基本用途。