1 eBPF 要解决什么观测问题
在 Linux 主机上,用户报告“读取配置偶尔很慢”,你先运行 top、ps 和 vmstat 1:CPU 没有持续繁忙,进程还活着,内存也没有明显耗尽。应用日志只记录了整个操作耗时,没有说明时间花在哪个系统调用。此时的问题很具体:哪个进程在什么时候进入内核,执行了什么操作,多久以后返回?eBPF 提供了靠近这些事件的观测位置,让排查不必完全依赖应用预先留下的日志。
系统调用是用户态程序请求内核服务的接口。进程读取文件可能调用 read,建立连接可能调用 connect,执行新程序可能调用 execve。同样的接口背后,等待原因可能不同:read 的文件描述符既可能指向普通文件,也可能指向管道或套接字。因此,“某次 read 很慢”描述了现象,还没有证明磁盘慢、网络慢,或者其他进程没有及时写入数据。
eBPF 的核心做法,是把受约束的小程序加载到内核允许的位置,在事件发生时执行。程序可以检查少量上下文、计算时间差、累计计数,再把汇总或选定事件交给用户态工具。你通常通过 bpftrace、已有观测工具或专用加载器使用这些能力,不必从编写底层指令开始。本课集中讨论观测用途;eBPF 也能参与网络处理,但本课不展开那些执行路径。
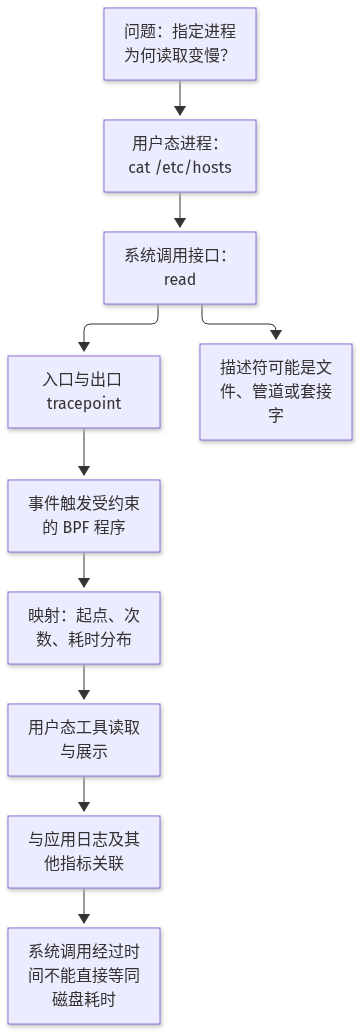
与周期性查看进程状态相比,事件探针能捕捉发生在 2 次刷新之间的短暂行为。与在每个函数里增加应用日志相比,它还能观察部分已有程序与内核接口。但探针也受挂载位置限制:挂在系统调用入口能看到请求发生,不能直接知道应用业务意图;挂在出口能看到返回值,不能凭空恢复入口时没有保存的信息。选择位置,就是选择证据能回答的范围。
例如,shell 中执行 cat /etc/hosts,表面上只是打印文件内容,实际可能涉及启动程序、打开文件、读取内容、向标准输出写入等事件。动态链接器也可能读取库文件。你看到的 read 次数不一定等于“读取 hosts 的次数”,更不能把系统调用数量直接当作磁盘访问数量。文件内容可能来自缓存,程序也可能采用其他读取接口。
网络排障同样需要约束结论。连接建立耗时与数据接收耗时属于不同问题;进程在 read 内等待数据,可能只是远端暂时没有发送。观测到本机某个网络事件,也不表示已经测到了跨主机的完整往返过程。先写清“观察本机哪个进程、哪个接口、哪个时间区间”,比先铺满网络栈探针更容易得到能验证的答案。
开始实验前,把问题缩成可核对的句子:“观察指定进程的 read,从系统调用入口到出口,记录完成次数和耗时分布。”这里已经限定了对象、操作、起止点与输出。后续若发现耗时确实异常,再补充文件描述符类型、应用阶段或更靠近等待位置的证据。eBPF 的价值在于增加可定位的观察点,结论仍要由多种证据共同支持。
2 探针、映射与程序生命周期
探针是事件与程序的连接点。tracepoint 是内核预先设置的事件接口,通常比直接依赖某个内部函数名称更适合作为入门起点。kprobe 可以探测部分内核函数,uprobe 可以探测用户态程序中的位置;它们对符号、版本和程序构建方式有不同依赖。本课使用系统调用 tracepoint,只需先理解“发生某类事件时执行观测程序”,不展开这些机制的内部实现。
单次执行的局部变量不会自然跨越入口和出口事件。要计算耗时,需要把入口时间保存到后续仍可访问的位置。BPF map,即映射,是程序与程序之间、内核与用户态之间共享数据的常见结构。它可以表现为按键查找的表,也可以承载计数、直方图等聚合结果。bpftrace 的 @started[tid] 就表达了按线程编号保存状态的意图,具体底层布局由工具处理。
为什么使用线程编号?进程中可能有多个线程并发执行系统调用。若只按进程编号保存入口时间,线程甲尚未返回,线程乙就可能覆盖它,得到看似合理但实际错误的差值。对于本课这种同步系统调用入口与出口配对,按 tid 记录起点更合适。异步请求可能在其他线程或其他时刻完成,不能直接照搬这个配对方法,需另行确认请求标识与完成语义。
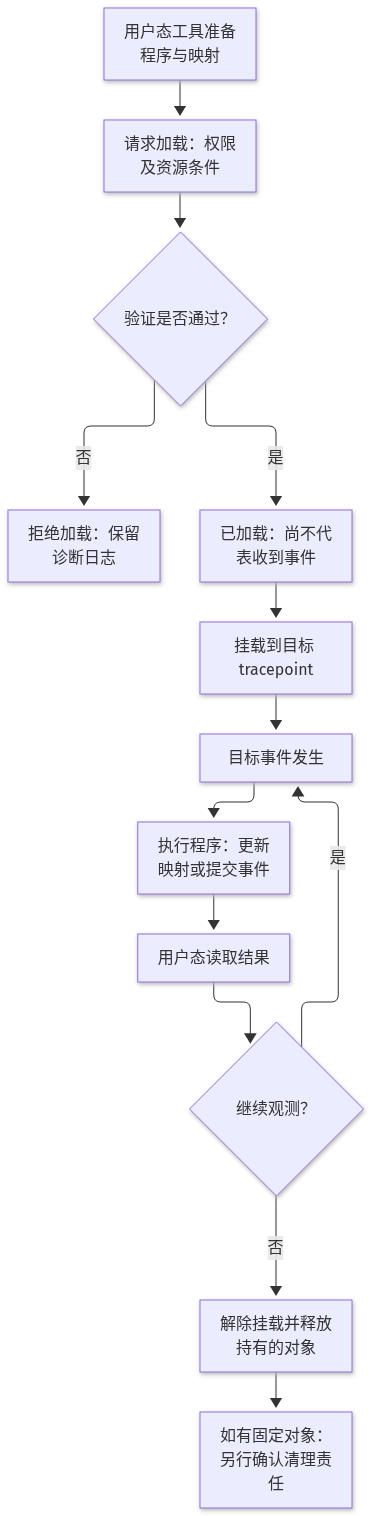
生命周期从用户态开始:工具准备程序和映射,向内核请求加载;验证通过后,程序才有机会被挂载到事件上。事件发生时,内核执行对应程序,程序更新映射或输出事件,用户态再读取并展示结果。加载成功与挂载成功是不同阶段:已经通过验证的程序,如果没有连接到目标事件,也不会因为目标系统调用发生就自动运行。
入口和出口构成了本课最重要的数据流:入口用 tid 写入时间,出口用相同键取回时间,计算差值并累计到直方图,最后删除该键。删除不是装饰步骤。遗留的入口记录会占用容量;如果后续误用旧值,还会污染结果。程序应明确处理没有起点的出口事件,而不是把默认值误当作有效时间,制造接近系统运行时长的巨大延迟。
映射也不是无限大的记事本。按线程记录起点,状态规模主要随同时在途的调用变化;按完整路径、每个文件描述符、每个返回长度都建统计键,状态可能迅速增加。容量耗尽时,更新可能失败,部分样本随之缺失。排查时既要看业务指标,也要看记录失败、事件丢失等观测系统自身的状态,否则可能把“没有收集到”理解为“没有发生”。
停止普通前台 bpftrace 观测后,工具通常会解除挂载并释放它持有的资源。其他工具可以把对象固定到 BPF 文件系统中,使其在加载进程退出后继续存在;这称为 pin。固定对象有实际用途,也意味着“关掉终端”不一定等于“停止观测”。交接时应记录谁负责解除挂载、谁负责释放映射;不要靠删除不明路径来试探资源是否仍在使用。
3 安全加载与权限边界
把程序放到内核执行,首先要回答它会不会进行非法访问。验证器会分析程序路径、寄存器状态、内存访问与允许调用的辅助函数等条件。程序必须满足内核能够确认的约束,例如读取的位置有合法来源、访问范围没有越界、执行能够在规则允许的范围内结束。验证器无法证明安全的程序会被拒绝,即使编写者确信某个分支实际不会发生。
这种检查与传统的“运行后捕获异常”不同。拒载意味着程序尚未进入正常的事件执行阶段,不能期待触发事件以后再输出错误。验证通过也只说明程序满足相关安全规则,不说明它统计正确、过滤条件正确,或开销可以忽略。例如,把纳秒错误地当作微秒输出,完全可能通过验证,却把观测结果放大 1000 倍。安全性和测量有效性必须分别检查。
权限检查则回答“谁可以创建、加载或连接这些对象”。实际要求取决于内核版本、程序类型、挂载位置与系统策略,可能涉及 CAP_BPF、CAP_PERFMON,部分环境还依赖更宽的管理能力。不要把某个版本中的能力组合当成所有机器都通用的规则。本课命令用 sudo 展示常见管理员实验方式,正式授权仍应按目标环境提供完成任务所需的权限。
可以先查看 uname -r,再运行 sudo bpftrace --info 了解工具报告的能力,并用 sudo bpftrace -l 'tracepoint:syscalls:sys_*_read' 查询目标事件。不同发行版、内核配置与工具版本可能提供不同输出。某条查询没有结果,只能说明当前可见条件下没有匹配事件;要继续区分事件未提供、跟踪接口未暴露与权限限制,不能立即认定内核损坏。
容器内的 root 也不一定具有宿主机加载 BPF 所需的能力。容器的能力集合、系统调用策略与挂载可见性都可能限制操作,进程编号还可能来自不同的 PID 命名空间。若宿主机工具中填写了容器内部看到的 PID,过滤对象可能错误。先核对观测端使用的编号,再判断“没有事件”;不要用不断扩大权限来掩盖对象选择错误。
观测权限还关联数据边界。系统调用参数可能涉及文件名、连接地址,甚至用户缓冲区中的内容。排查读取延迟通常只需要线程编号、时间和返回值,收集完整缓冲区并不会自动提高定位能力。先限制进程与持续时间,再决定是否需要额外字段;记录输出保存在哪里、谁能读取、何时清理。这些约束同时降低数据暴露与观测开销。
遇到 Operation not permitted 时,先保留执行命令、内核版本、工具版本和完整错误上下文。若工具已经给出验证日志,应沿验证问题处理;若调用在权限检查阶段被拒绝,则先核对授权和系统策略。某些环境还可能因为资源限制导致创建映射失败。不同阶段都可能表现为“加载失败”,但修改程序、调整资源和申请权限解决的是不同原因。
4 动手:跟踪一次系统调用延迟
下面观察由 bpftrace 启动的 cat /etc/hosts。实验前提是 Linux 环境中已安装 bpftrace,并且可以使用系统调用 tracepoint。我们选择短小、容易重复的文件读取,目标是理解测量链路,不是制造磁盘压力。系统调用的入口到出口经过时间包含执行和等待;它既不等于 CPU 实际执行时间,也不等于设备完成某次物理读取的时间。
把以下内容保存为 readlat.bt。cpid 表示通过 -c 启动的直接子进程编号,过滤条件让本次实验聚焦该进程。这里不按名称过滤,因为系统里可能同时运行多个 cat。tid 用于入口与出口配对;示例不跟踪目标后来创建的其他进程。若以后换成 shell 脚本,必须重新考虑实际执行读取的进程是否仍是这个编号。
tracepoint:syscalls:sys_enter_read
/pid == cpid/
{
  @started[tid] = nsecs;
}

tracepoint:syscalls:sys_exit_read
/pid == cpid && @started[tid]/
{
  $elapsed = nsecs - @started[tid];
  @read_us = hist($elapsed / 1000);
  @calls = count();
  if (args.ret < 0) {
    @errors = count();
  }
  delete(@started[tid]);
}

END
{
  clear(@started);
}
在脚本所在目录运行:
sudo bpftrace -c 'cat /etc/hosts' ./readlat.bt命令会同时显示 cat 打印的内容与工具的统计输出;目标结束后,工具通常随之退出并显示聚合结果。不同版本的提示文字可能不同。若 cpid 或其他语法不被当前工具支持,应核对该版本文档,不能删除过滤条件后直接在繁忙主机上继续。也不要随手把命令改成通过 shell 再启动 cat,那会改变被观测的进程关系。
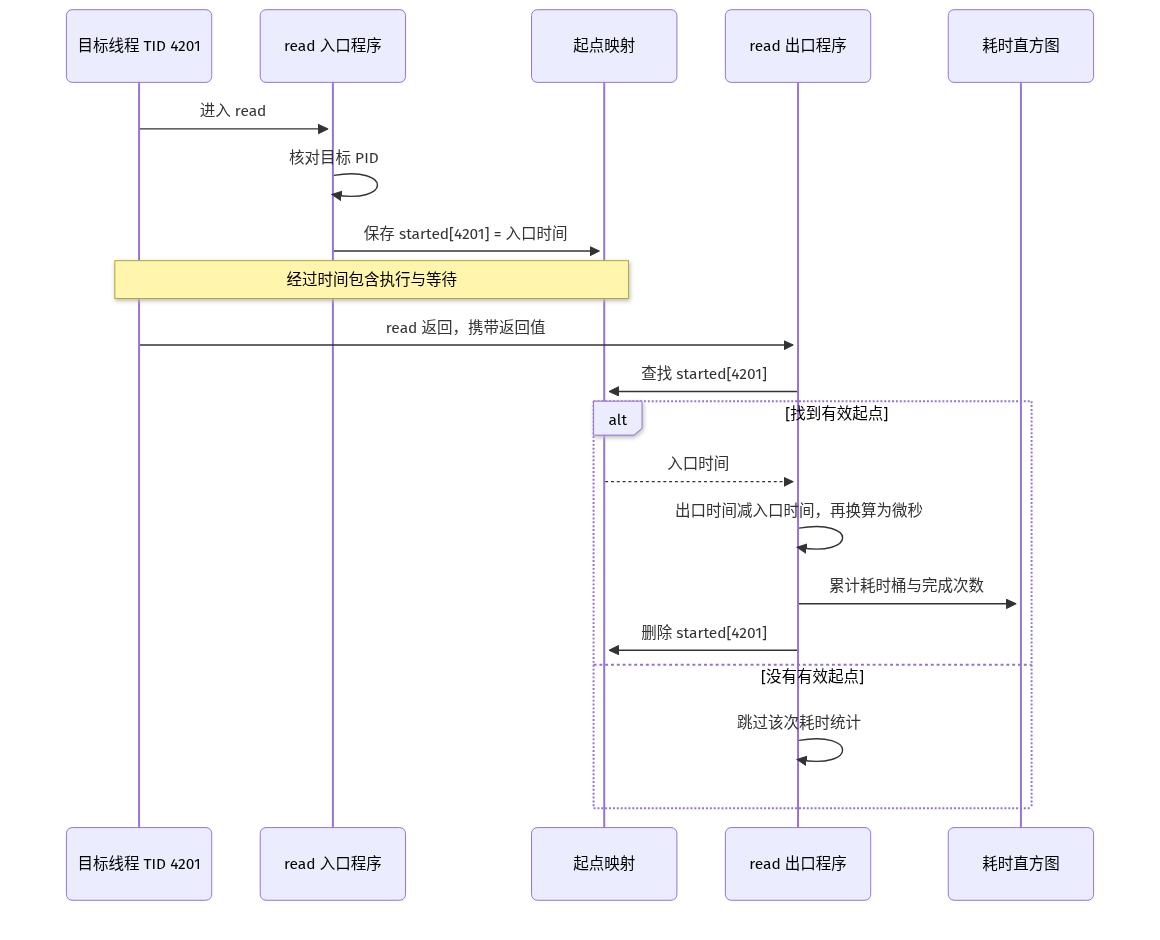
nsecs 提供用于计算间隔的纳秒时间值,相减后除以 1000,才得到这里标注的微秒。整数除法会截去不足 1 微秒的部分,极短调用可能进入 0 对应的桶。hist 输出的是按区间聚合的分布,通常使用 2 的幂附近的桶边界;桶中的计数表示落入这个范围的调用数量。不能把桶标签直接当成每次调用的精确耗时。
args.ret 是这次 read 的返回值:正值通常表示读到的字节数,0 通常表示读到文件末尾,负值表示系统调用失败。脚本只累计负返回值的次数,没有把错误码转换为名称。正常读取结束时出现 0 不属于失败。如果没有负返回值,@errors 可能根本不显示;这与工具显式打印 errors=0 的呈现方式不同,需要在报告中说明。
初次输出往往只有少量样本。@calls 可能包含程序启动时读取其他文件的调用,不能据此断言目标文件被读取了多少次。重复实验时缓存、调度和输出目标都会影响结果;若要比较 2 组结果,应保持命令、输入、系统负载和采集方式一致。少量调用形成的直方图适合验证脚本工作,不适合报告稳定的 p99 或推断偶发故障已经消失。
如果没有统计结果,先确认进程是否实际启动、脚本是否成功挂载,再核对事件是否存在以及目标是否使用 read。其他程序可能通过 pread64、内存映射或其他接口取得数据。脚本中 END 清理尚未配对的起点,避免把内部状态当作结果打印;它不会补回缺失的出口。没有完成的配对意味着没有该次耗时样本,需要保留这个测量边界。
5 深度可见性与开销取舍
观测越靠近事件,往往越容易获得细节,也越需要考虑执行频率。每次探针触发都可能执行过滤、读取上下文、查找映射或输出事件。单次成本很小,乘上高频率以后仍可能可见。尤其在网络包处理、频繁的小块读写等热路径上,成本跟事件数量增长,而不是只跟进程数量增长。先估计事件率,才能判断观测方案是否合适。
应区分聚合与逐条输出。只想知道每秒完成次数,可以在内核累计计数;想知道耗时分布,可以维护直方图。若每次调用都输出 PID、路径、时间和返回值,数据还要经过缓冲区、用户态读取、文本格式化与终端显示。此时最忙的可能是采集程序本身。屏幕没有刷满,不等于内核侧没有额外工作;缓冲区满时,还可能发生丢失。
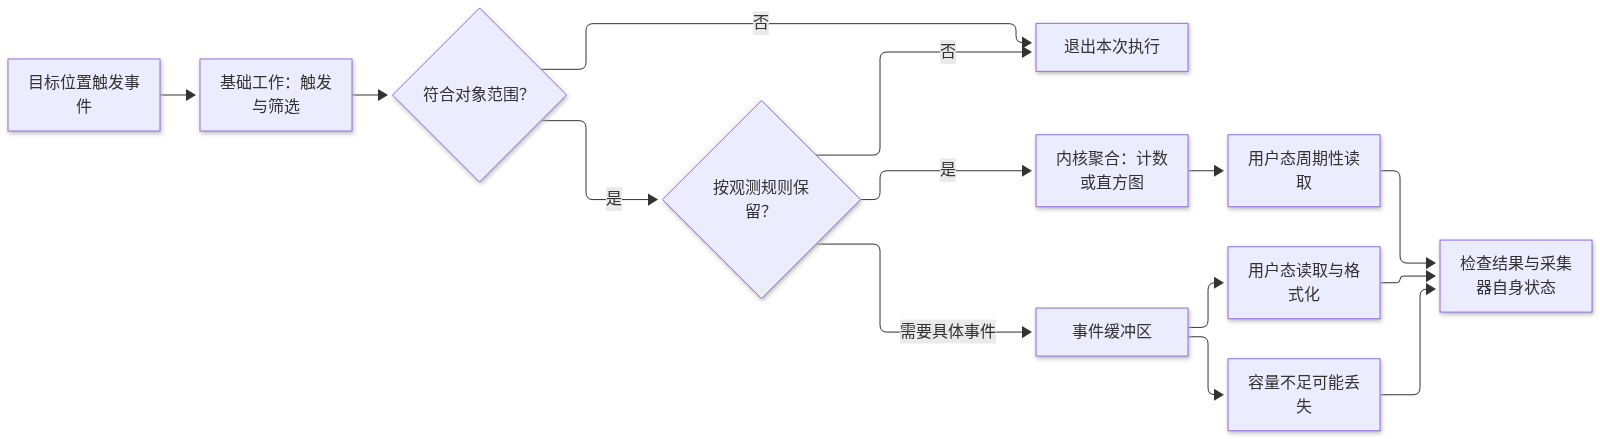
过滤要尽早表达,但不能把它理解成完全免费。即使程序发现 PID 不匹配后立即退出,触发和判断仍有基础成本。类似地,进入探针以后再决定只保留 10% 样本,会减少后续记录成本,却不保证减少 90% 的总开销。采样放在哪里、映射何时更新、结果怎样输出,都会影响实际收益,需要结合测量判断。
交互中的数值是教学估算:事件率乘以单次处理成本,得到每秒消耗的 CPU 时间,再与 1 秒比较。它不预测真实机器性能,也不覆盖多核争用、缓存影响或输出阻塞。拖动保留比例时,注意基础成本仍然存在。把样本保留率调到 0,也不等于解除探针挂载;要结束这部分触发成本,需要停止相应观测。
采样也会改变证据的完整程度。如果随机保留 10% 的事件,某个只发生 1 次的异常可能恰好没有留下记录。若每 100 次固定保留 1 次,周期性负载还可能与选择规则相互影响。对耗时测量,必须保证入口与出口配对一致:入口没有保存时间,却在出口尝试统计,会造成无效结果。可以在入口做选择并保存标记,出口仅处理已经选中的调用。
更细的探针可以帮助缩小范围,但语义也可能更接近内部实现。系统调用总耗时适合确认用户请求是否在内核接口处等待;某个内部函数耗时只能解释该函数覆盖的阶段。更换内核后,函数名称或执行路径可能变化。选择稳定接口通常有助于长期维护,而临时深入探测则应记录内核版本、符号来源与解释范围,避免把某次实验脚本当作永久指标。
比较开销时,至少保持工作负载一致,记录未启用与启用观测时的完成量、延迟、CPU 和采集器状态。顺序执行也会受缓存或背景任务影响,不能把任何微小差值都归因于 eBPF。若已有明显扰动,优先缩小对象、缩短时段、减少字段和逐条输出,再判断是否值得增加探针。观测的目的是帮助解释系统,测量本身也需要接受检查。
6 常见坑:在热路径打过多探针
某次网络读取排障中,操作者同时挂了系统调用、多个内核函数和高频事件探针,每次触发都打印文本。最初只是想找出偶发等待,随后却发现采集器 CPU 增高、终端滞后、应用延迟进一步上升。这个变化不一定代表找到了故障位置,也可能是观测制造了新的负担。此时应先减少观测,再判断原始症状是否仍然存在。
热路径上的探针数量不能单独说明成本。1 个每秒触发 100000 次的探针,可能比 10 个偶尔触发的探针更值得关注;入口和出口分别执行,也要分别计算事件率。如果多个工具同时监听相同路径,它们产生的工作可能叠加。交接时只说“我只开了 1 个脚本”没有意义,还应说明挂载点、触发频率、输出量和并行运行的其他采集任务。
逐事件 printf 是常见放大器。内核侧准备数据,用户态解释并格式化,输出又可能经过管道、日志进程和存储设备。若把文件读取事件写入磁盘日志,日志写入本身还会增加系统 I/O。即使过滤避免了把采集器自己的事件算入目标统计,这些资源消耗仍然存在。改成计数或直方图通常能显著减少输出,但实际效果仍需观察。
高基数键也容易被忽略。以 PID 和调用类型分组,通常比把每个时间戳、完整路径都作为键更容易控制容量。若每个事件都生成不同键,所谓“聚合”就退化成保存大量独立记录。应先确定希望比较的分组,再限制键空间与容量,并决定容量不足时如何报告。不能为了让输出看起来完整,就把映射容量无限调大。
字符串读取还涉及额外成本和准确性限制。缓冲区可能被截断,用户态地址可能在读取时无效,相对路径也需要进程工作目录才能解释。排查 read 延迟时,直接增加路径字段不一定能得到可靠文件身份,因为 read 的主要输入是文件描述符。要关联路径,需要额外的打开、关闭和描述符复用信息;本课先保留这个边界,避免用不完整关联制造错误归因。
减少探针应有顺序:先保留能回答主问题的入口与出口,再去掉重复覆盖的内部位置;保留目标进程过滤,把连续文本改为周期性汇总;最后才考虑是否需要采样。每次调整后,都记录条件变化与结果变化。若同时改变探针位置、采样规则和负载,即使开销下降,也很难知道是哪项调整发挥作用,其他人也无法复现实验。
还有 1 类坑是只看成功输出。采集器可能报告丢事件,映射更新可能失败,入口与出口可能因为中途启动或停止而无法配对。这些缺口不总会使工具退出,却会使结果偏向被成功记录的事件。报告中应同时说明完成配对的数量、可见的丢失情况与采集窗口。没有提供丢失计数的工具,不能因此被认定为“零丢失”。
7 案例:验证失败的 BPF 程序被拒载
设想维护者准备了 1 个 tracepoint 程序,打算在读取事件上返回某个数值,却把普通整数当成地址读取。加载器报告失败,应用仍照常运行,观测结果没有出现。这个案例首先要划分阶段:程序没有成功加载,也就不会产生预期的挂载与执行效果。此时调整应用负载、反复读取文件,无法让尚未通过检查的程序开始工作。
下面是便于理解的伪指令,不能直接当作 C 或 shell 命令执行。它们表达的关键错误是:把值为 0 的普通标量当成可读取的内存地址。此处只借用寄存器名称说明日志,不要求掌握完整 BPF 指令集。
r2 = 0
r0 = *(u64 *)(r2 + 0)
exit
验证器知道 r2 是普通数值,没有证据表明它指向允许读取的内存区域。于是内存读取被拒绝。示意日志可能包含 R2 invalid mem access 'scalar';不同内核和加载器的文字与位置会变化。这里的重点是寄存器类型与访问来源不满足要求,而不是把某段固定英文当成所有拒载问题的唯一特征。
若已经有用于隔离实验的 bad.bpf.o 对象文件,可以用以下形式请求更详细的加载诊断。该命令不是生成示例对象的方法,也不要求为了理解案例先编译底层程序;目标路径应事先确认未被其他对象占用。
sudo bpftool -d prog load ./bad.bpf.o /sys/fs/bpf/s46_bad type tracepoint预期的拒载情况下,不应出现由这次成功加载而固定的新程序。若错误来自目录不可用或权限不足,观察到的就不是本案例的验证器拒绝。诊断时保留完整输出,先识别失败阶段,再寻找与非法访问关联的指令和状态说明。只截取最后 1 行“permission denied”,可能漏掉前面已经给出的关键原因;有些加载错误的最终呈现并不能单独解释根因。
修复方向是回到程序意图:如果只是返回常量,应直接产生允许的返回值;如果确实需要读取事件字段,应从该程序类型允许的上下文或规定的访问方式取得数据,并满足边界条件。把指针强制转换成另一种类型,或删去能让验证器理解范围的判断,并不会自动获得访问资格。也不应通过关闭相关防护来让错误程序进入内核。
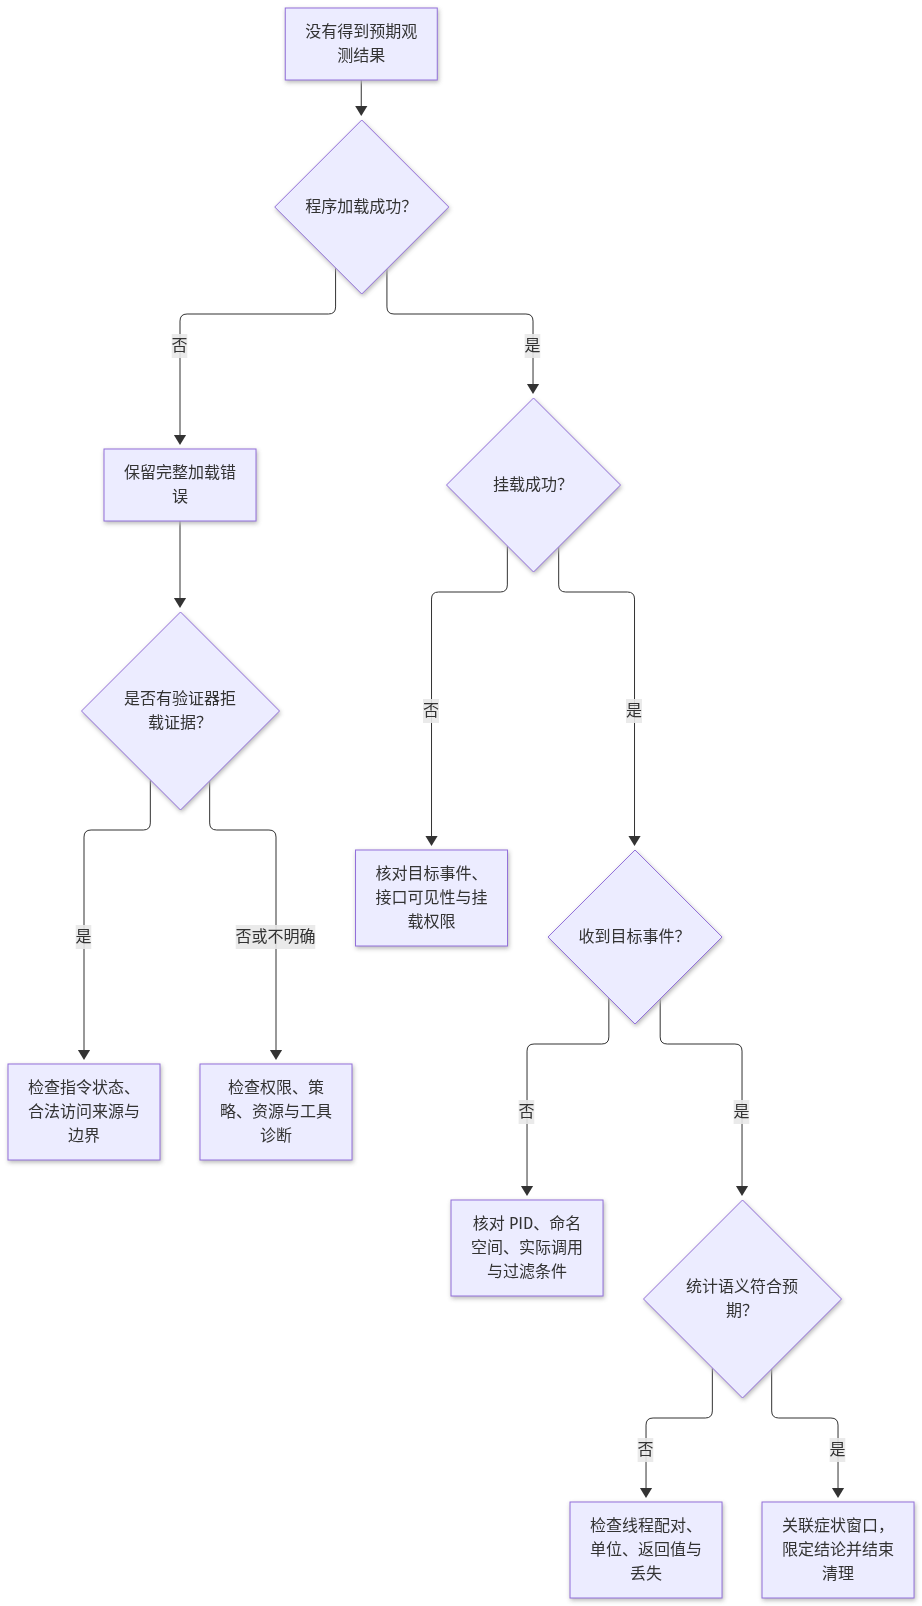
重新构建并加载后,还要单独确认挂载与事件输出。验证通过不能替代功能验证;修复非法访问时,也可能不小心读取了错误字段。反过来,目标 tracepoint 不存在通常属于事件选择或挂载问题,不是这个非法内存读取案例。把“加载成功、挂载成功、收到事件、统计符合预期”分别记录,能让后续排障定位在正确阶段。
这个案例的可迁移结论是:拒载本身是明确的诊断事件。它表明安全边界阻止了无法确认合法的访问,而不是证明机器无法使用 eBPF。把源程序意图、编译对象、程序类型、加载命令与验证日志关联起来,才能修复具体原因。不要把全部失败归为“内核太老”,也不要仅凭某段程序在另一台主机通过,就省略当前环境中的加载检查。
8 把 eBPF 观测写进排障方案
可执行的排障方案先写假设:“指定进程的响应变慢,可能与 read 的等待有关。”随后说明证据标准:在症状窗口内,目标进程完成的 read 耗时分布是否明显变化;若没有变化,应转向其他接口或用户态阶段。这样的写法允许假设被否定,也防止采集结束后只挑选符合直觉的图。观测问题要比“把内核发生的事全抓下来”更窄。
对象范围应包括主机、进程身份与时间范围。仅写 PID 容易遇到进程退出后编号被复用,至少还应核对命令行与启动时间;使用 ps -p 目标PID -o pid,lstart,args 可以辅助记录。长期运行的服务如果有多个工作进程,还要列清覆盖关系。容器场景则说明编号来自哪侧,避免值班人员用另一个命名空间中的编号复现脚本。
方案中的测量定义必须足够具体。本课测的是完成配对的 read 从入口到出口的经过时间,单位为微秒,输出为直方图与计数。它没有分离 CPU 执行和等待,没有覆盖其他读取接口,也没有自动把描述符还原成文件。把这些边界写在指标旁边,读者才不会把“read 长尾增加”改写成“磁盘延迟增加”,进而跳过必要的关联检查。
实际操作需要包含启动前检查、启动命令、采集窗口与结束方式。先查询事件与工具能力,确认没有同类采集器造成明显负担,再开始目标观测。前台长时间采集可用 Ctrl-C 正常结束并查看汇总;像本课使用 -c 的短命令,通常随子进程结束。若采用固定对象的加载器,还需另外记录解除挂载与资源释放步骤,不能套用前台工具的退出行为。
停止条件同样应能执行。例如观察 30 秒后汇总;若发现采集器持续占满预留 CPU、丢失提示明显增加或业务延迟恶化,就提前结束并保留当时状态。具体阈值应由服务已有基线和资源预算决定,不存在适用于所有机器的固定安全比例。停止后检查残留观测资源,并记录结束是否正常,避免下一位操作者在已有探针之上继续叠加。
结果关联要围绕同一时间窗口展开。可以把应用日志中的慢请求时间与 read 分布变化对齐,再结合已有进程状态、文件系统或连接证据判断下一步。如果应用变慢而 read 分布稳定,就不能继续只盯着这个接口;如果两者同时变化,也仍需区分共同原因与直接原因。时间上的相邻提供线索,不能独自建立因果关系。
交付物不应只有截图。保留脚本、实际命令、工具和内核版本、原始输出、持续时间、过滤条件以及可见的丢失信息,另附简短结论与后续验证动作。对很短的实验,写“完成了 8 次配对,其中某个桶有 2 次”比写“p99 正常”更诚实。样本量与测量范围决定结论能走多远,报告的语气也应随证据强度调整。
9 从eBPF走向存储栈深入(S47)
本课从系统调用边界观察读取,留下了 1 个自然问题:为什么同样调用 read,有时很快,有时等待明显?仅靠入口和出口无法回答,因为这个区间可能覆盖检查、数据复制、等待与调度等过程。普通文件的读取还可能命中内存中的缓存,也可能需要进一步访问存储。下一课 S47 将沿存储路径补上这层解释,本课先掌握外部边界与证据限制。
首先要确认描述符对应的对象。对仍在运行且有权限检查的进程,readlink /proc/目标PID/fd/目标FD 可以提供描述符当前指向的线索,例如文件路径、管道或套接字标识。它查询的是检查时刻的状态;描述符可能已经关闭并被复用,所以不能把稍后看到的目标无条件套到先前的 read 上。短命令结束后,相应的 /proc 项也会消失。
若确认是普通文件,可以继续用 findmnt -T /实际文件路径 查看文件所属挂载,或通过 df -T /实际文件路径 获取文件系统层面的基本信息。这些命令帮助确认接下来研究的对象,不提供某次读取的耗时分解。网络文件系统、内存文件系统和本地块设备支持的文件系统,后续需要关联的证据可能不同;仅凭文件名后缀无法判断实际路径。
还要区分应用读取、系统调用读取与设备读取的统计口径。应用可以先把数据放入自身缓冲区,后续逻辑读取未必再次进入内核;进入内核也可能取得已缓存的数据,未必产生设备请求。因此,应用操作次数、read 次数和设备请求次数没有简单的逐次对应关系。对照多个工具时,先问各自在哪层计数,比急着解释数量为何不相等更有效。
同理,read 返回的字节数并不直接说明设备实际传输了相同数量的数据。预读、缓存与文件系统组织都会影响下面发生的工作,这些机制留给 S47 逐步展开。本课只需要避免 1 个跳跃:看到读取了 4096 字节,就认定设备恰好完成了 1 次 4096 字节请求。要建立这种联系,必须有对应层的观测和清晰的关联方法。
从网络方向来的慢读取,也应先识别对象,再选择后续路径。套接字上的 read 等待数据,与普通文件读取等待存储并不是同一种证据链。若不先分类,就可能因为函数名称相同而去检查无关设备。eBPF 帮助你看见接口行为,理解接口背后的对象与语义,仍然依赖操作系统基础和其他观测手段。
进入 S47 前,可以保留本课的 3 项准备:明确读的是哪类对象,写出当前耗时测量的起止点,列出尚未被观测的阶段。下一步再学习文件系统、缓存与存储设备之间的关系,并选择对应层的证据。这样,新探针会围绕已经缩小的问题增加,而不是因为工具支持更多位置,就一次性把整个存储路径都挂满。
放进方案里
在排障文档中建立“目标进程读取延迟”条目,写明待验证假设:症状期间,指定进程完成的 read 耗时上升。登记主机、进程编号、启动时间、命令行与采集时段;容器环境注明编号来自宿主机还是容器。先查询系统调用事件和工具能力,确认当前授权允许这次观测,再填写实际使用的脚本与启动命令。
指标定义为入口到出口的经过时间,以微秒汇总直方图,同时记录完成配对数与负返回值次数。注明 0 返回值通常表示文件末尾,未显示错误映射不等于工具显式报告了 0。范围只覆盖所选进程的 read,不覆盖其他读取接口,也不把系统调用延迟直接解释成设备延迟。
初始采集采用目标进程过滤与内核聚合,避免逐事件打印内容。约定 30 秒的观察窗口,并按服务基线填写 CPU、业务延迟与事件丢失的提前停止条件。若需要采样,记录选择位置和保留比例,保证入口与出口配对,说明罕见异常可能没有入样。
加载失败时保存完整错误,分别检查权限、资源与验证日志;挂载失败则核对事件是否存在。没有输出时先核对进程身份和实际接口,不通过取消过滤来盲目扩大范围。把拒载程序作为独立问题处理,不用反复触发业务请求代替加载诊断。
结束后确认工具退出、挂载解除及资源释放,归档版本、脚本、命令、原始结果和丢失提示。结论与应用日志按同一窗口对齐:有相关变化就继续确认描述符类型与等待位置,无相关变化则转向其他接口。交接时列明已证实事实、测量边界和下个验证动作,让后续人员能够复现并推翻假设。
10 小结:下一步存储栈深入(S47)
eBPF 观测由事件位置、受检查的程序、映射与用户态读取共同组成。入口保存起点,出口按线程配对,能得到系统调用的完成耗时;权限、验证、挂载与执行则构成需要分别判断的阶段。过滤、聚合和有限窗口帮助控制成本,不能代替对丢失与扰动的检查。
自测时尝试回答:为什么不能只按进程编号保存并发调用的起点?为什么 read 返回 0 不应算失败?为什么验证通过后仍可能没有事件?为什么将保留比例调为 0 不等于解除挂载?如果你能同时说出观察点和结论边界,就已具备继续排查的基础。
下一课 S47 进入存储栈:沿普通文件读取向下理解文件系统、缓存与设备之间的关系,再判断该在哪层补充证据。