1 隔离与限额要解决什么
在 Linux 主机上启动 2 个服务,只要它们的监听地址相同,就不能同时占用同 1 个 TCP 端口。进程还可能读取相同目录、看到相同进程列表,并争用 CPU 和内存。把启动命令分别放进 2 个 shell,不会改变这些事实。shell 是命令解释器,不会自动给后代进程建立独立的系统视图,也不会自动限制它们的资源消耗。
容器希望解决的核心问题可以拆成 2 句:进程能看到什么,以及进程能使用多少。namespaces 主要改变进程看到的对象集合,例如进程编号、挂载点和网络设备。cgroups 主要把进程组织成资源管理组,对资源使用进行计量、限制或分配。前者像给不同工作区安排各自的门牌和目录,后者像给工作区设置电力额度;两者经常配合使用,却不能互相代替。
假设主机运行日志采集进程和图片转换进程。我们希望图片转换进程只看到自己的目录与进程,不影响日志采集的端口;还希望它在处理异常大文件时,内存增长能在自己的组内被处理。如果只建立 namespaces,转换进程仍可能持续申请内存,拖累整台主机。如果只设置 cgroup 限额,它可能仍看见共享的网络接口和目录。设计部署时必须分别回答可见性与资源预算。
这些机制没有给每个容器启动独立的 Linux 内核。宿主机内核仍负责执行系统调用,管理进程、文件和网络。容器里显示的发行版名称通常来自容器文件系统中的用户空间文件,不能据此判断它拥有独立内核。这个共享关系解释了容器为什么容易启动,也解释了为什么内核漏洞、过大的权限和错误挂载会影响隔离效果。
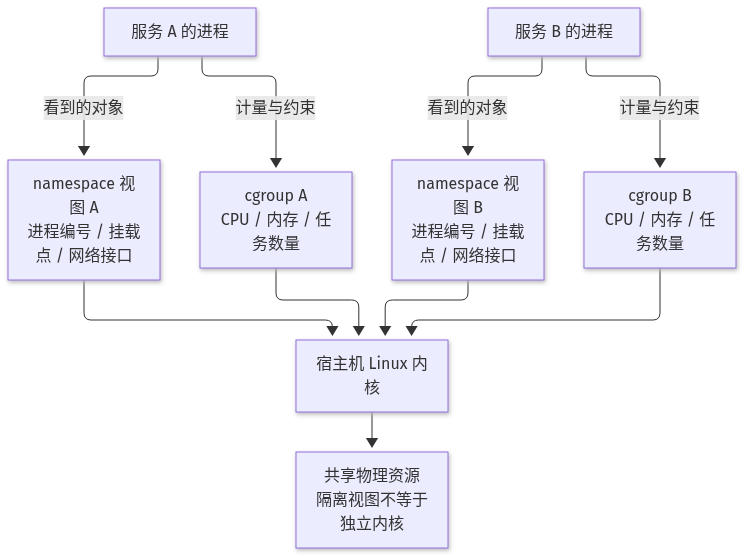
观察时也要区分 3 类故障。端口冲突常是网络视图或绑定地址问题;读取文件失败常与路径、挂载或权限有关;程序突然退出则可能来自信号、应用错误或内存限制。看到“容器异常”就直接增加资源,会绕过真正的问题。本课会把这些现象分别接到可读取的接口上,让判断有证据可查。
2 namespaces 的边界与类型
namespace 是内核维护的某类对象的可见范围。进程总是处在相应的 namespace 中;多个进程可以共享同 1 个 namespace,也可以只共享其中部分类型。因此,“属于同 1 个容器”是运行时组织出来的整体,不是内核提供的单个万能隔离开关。判断边界时,要具体说出正在讨论哪类对象,以及哪几个进程共享了它。
PID namespace 隔离进程编号与可见的进程集合。容器内的主进程可能显示为 PID 1,而宿主机用另 1 个 PID 标识同 1 个进程。PID namespace 具有层级关系,宿主机可以观察后代范围内的进程,容器里通常看不到宿主机全部进程。容器内 PID 1 还承担接收终止信号、回收已退出子进程等职责;把任意 shell 脚本放在这里,需要确认它能正确转发信号并处理子进程。
mount namespace 决定挂载点视图。进程访问 /data/report.txt 时,路径最终落到哪个文件系统对象,取决于它所在的挂载视图。相同路径文字不保证指向相同文件;不同路径也可能经由绑定挂载指向同 1 份宿主机数据。mount namespace 本身不会复制文件内容,也不会自动撤销写权限。只读挂载、文件的 uid/gid 与权限位仍要分别检查。
network namespace 包含各自的网络接口、地址、路由和端口空间。处在不同 network namespace 的进程,可以分别监听自己的 0.0.0.0:8080。其中的 127.0.0.1 指向当前网络视图里的回环接口,容器访问这个地址并不等于访问宿主机服务。要连接外部网络,还需要接口配置、路由和相应的转发安排;建立 namespace 不会自动完成联网。
UTS namespace 隔离主机名等标识,IPC namespace 隔离部分进程间通信对象。user namespace 提供用户与组标识的映射:内部显示的 uid 0 可以映射到外部普通用户,但是否启用、如何映射,都取决于运行环境。cgroup namespace 则改变 cgroup 路径的可见视图,它不会凭空给进程增加资源额度。time namespace 与时间相关的部分视图有关,本课只识别名称,不展开配置。
/proc/<pid>/ns/ 提供 namespace 的观察入口。执行 readlink /proc/self/ns/net,可能得到 net:[4026533001] 这样的标识。在同 1 台正在运行的主机上,同类型 namespace 的标识相同,说明它们共享对应视图。不同类型的编号不要互相比较,也不要把某次看到的编号写成长期配置:对象销毁后,编号不再是稳定业务身份。
3 cgroups 资源控制直觉
cgroup 把进程放入资源管理层级。这里主要使用 cgroup v2 的接口名称;旧环境可能使用 v1,文件名称与组织方式会不同,不能把下面的路径原样套用。v2 通常在 /sys/fs/cgroup 挂载统一层级,CPU、内存、进程数量等控制器在这个层级中工作。资源文件存在,不代表当前账户有权修改,也不代表所有控制器已经向子组开放。
先看 CPU。cpu.max 的 50000 100000 表示每个 100000 微秒的配额周期,组内进程合计可以消耗 50000 微秒的 CPU 执行时间,长期上限约为 0.5 个逻辑 CPU 的算力。它没有指定进程必须在哪个 CPU 上运行;多线程可能短时间并行消耗配额,再一起等待下个周期。CPU 很忙时延迟升高,可能是配额耗尽,也可能是主机竞争,不能只凭瞬时使用率下结论。
cpu.weight 表达竞争时的相对份额,作用和硬配额不同。空闲时,较低权重的组仍可能使用可用 CPU;发生竞争时,权重才影响分配。设置 CPU 上限也不等于预留同样多的算力。若主机本来就过载,即使某组尚未达到自己的上限,也可能得不到期望的响应速度。需要预留或放置约束时,应在部署层另外表达。
再看内存。memory.current 是当前组及其后代的内存计量,不能简单等同于应用堆大小;文件缓存等也可能计入。memory.max 设置硬上限,max 表示此处没有有限的本级上限,祖先组仍可能有限制。达到上限时,内核会尝试回收;无法满足分配时可能发生组内 OOM,终止其中进程。memory.high 更适合作为施加回收压力的阈值,不能把它当作与硬上限完全相同的开关。
pids.max 限制组内任务数量,线程也会计入,所以它不是“允许启动多少个服务”的直接对应值。达到限制后,创建新进程或线程可能失败,shell 可能报告资源暂时不可用。io.max 可对指定块设备的读写速率施加限制,但设备、缓存和存储路径会影响观测,入门阶段先确认文件确实经过受控设备。资源限制必须与实际访问路径对应。
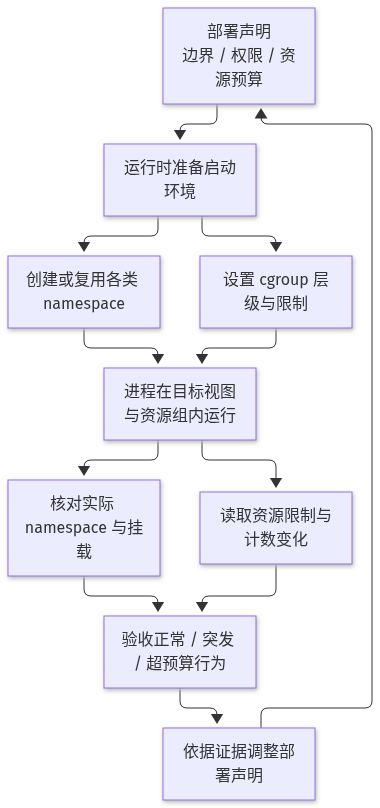
交互中的预算只用于理解余量:应用基线、突发需求、同节点其他负载和系统开销共同影响结果。把内存上限压到刚好等于平时用量,往往会在启动、缓存预热或批量处理时触发故障;把所有组都设成很大,也没有创造物理内存。应结合观测调整限额,并为节点本身保留预算。图里的 2 个轴需要同时检查,任何单独的“已隔离”标记都不够。
4 动手:观察一个容器的 ns/cgroup
下面以已有的 Linux 容器为对象,使用 Docker 命令取得宿主机 PID。需要能访问相应运行时;其他运行时可通过自己的检查接口得到同样的信息。先选择普通测试容器,避免把试验命令放进生产服务。这里仅观察,不创建高内存负载,也不改写运行时管理的 cgroup 文件。
# 在宿主机执行;将 demo 换成已有容器名
pid=$(docker inspect --format '{{.State.Pid}}' demo)
printf 'host pid=%s\n' "$pid"
readlink "/proc/$pid/ns/pid"
readlink "/proc/$pid/ns/mnt"
readlink "/proc/$pid/ns/net"
readlink /proc/self/ns/net
cat "/proc/$pid/cgroup"
应先确认 PID 是存活容器对应的正整数。停止状态可能返回 0,重启又可能更换 PID,因此不要复用很久以前保存的数值。如果读取失败,先查容器状态、当前权限以及 /proc 的可见性。Permission denied 不等于 namespace 不存在;No such file 也可能只是进程恰好退出。这个竞态提醒我们,观察结果必须附带时间与对象身份。
在 v2 环境,cgroup 输出通常类似 0::/system.slice/example.scope。冒号后的路径是相对于当前可见 cgroup 根的路径,不一定是全局绝对位置。在宿主机初始视图且采用常规挂载时,可将它接到 /sys/fs/cgroup 后面读取。先用 findmnt -t cgroup2 确认挂载,再根据实际输出填写目录,不要根据容器名称猜目录名。
# 在宿主机执行;替换为刚刚观察到的实际目录
cg=/sys/fs/cgroup/system.slice/example.scope
cat "$cg/cgroup.controllers"
cat "$cg/cpu.max"
cat "$cg/cpu.stat"
cat "$cg/memory.current"
cat "$cg/memory.max"
cat "$cg/memory.events"
cat "$cg/pids.current"
cat "$cg/pids.max"
cpu.stat 中的节流计数与时间可以提示 CPU 配额是否造成等待。memory.events 中的 max、oom、oom_kill 等计数提供内存压力和终止事件线索;计数应比较故障前后的变化,单次读到非 0 不能证明刚才的请求触发了它。某个文件缺失时,应确认控制器、层级和版本,而不是马上创建同名普通文件。
接着在容器里执行 ps -ef、cat /proc/self/cgroup 和 ip addr,与宿主机观察对照。精简镜像可能没有 ps 或 ip;缺命令只说明用户空间工具不足。具备相应权限时,可以在宿主机使用 nsenter -t "$pid" -n -- ip addr,让主机上的 ip 进入目标网络视图查看接口。这里仅进入 network namespace,不能因此声称同时进入了目标文件系统或用户身份。
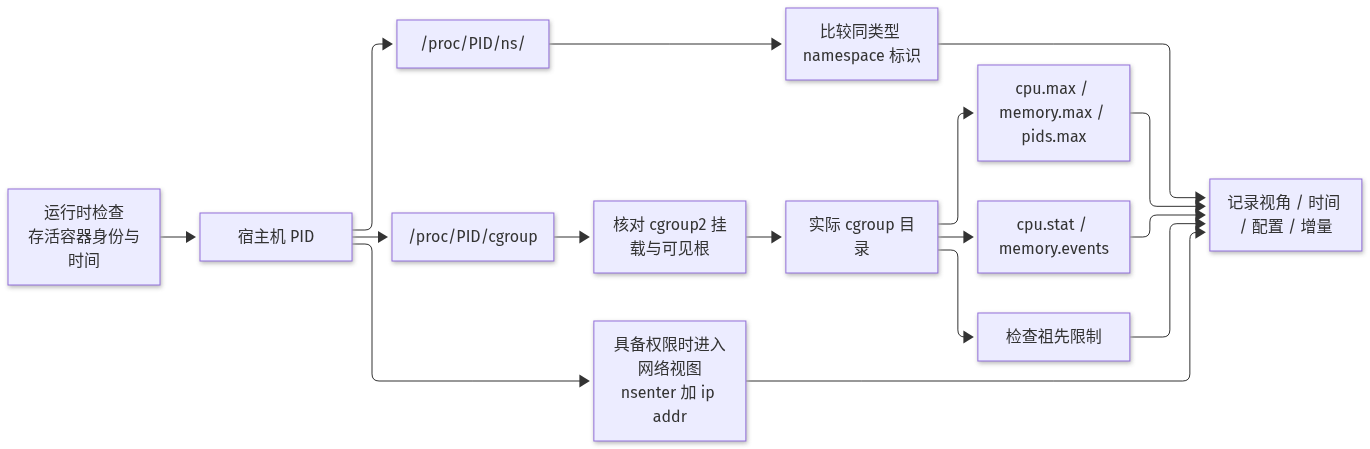
记录实验时,写下容器名、宿主机 PID、namespace 标识、cgroup 路径和读取时间,再附关键配置及计数变化。不要只截图容器内的 top:工具可能按不同口径展示 CPU 或内存总量,也可能无法正确反映当前限额。将原始接口与运行时配置一起保存,才能解释“应用说还有内存,但分配失败”这样的表面矛盾。
5 层级、委托与权限
cgroup 是树形层级,限制会沿祖先作用到后代。假设父组内存上限为 2 GiB,下面 2 个子组各配置 1536 MiB;这不意味着子组可以同时稳定使用总共 3 GiB。它们仍共同受父组预算约束。排查局部配置看似宽松、实际却发生回收或失败的问题时,需要沿父目录检查有效约束,而不能只盯住最深的叶子目录。
CPU 也有类似现象。子组的 cpu.max 显示 max 100000,只能说明子组这里未设有限配额,父组仍可能限定总量。资源治理因此包含 2 个层面:谁能在什么层级设置政策,以及子组能在获准范围内怎样分配资源。应用负责人可以调整本服务预算,但不能通过创建子组绕过上级限制。
委托是把某段子树的管理职责交给另 1 个管理者。上级为它提供合适的控制器和文件权限,受委托者再管理自己的后代。v2 中,cgroup.controllers 用于观察可用控制器,cgroup.subtree_control 关系到向子组启用哪些控制器;同时还存在进程放置等规则。本课不要求手工搭建完整委托树,实际部署优先使用服务管理器或容器运行时提供的接口。
不要为了让脚本写入成功,就把整个 /sys/fs/cgroup 改成可写,也不要与运行时同时手工迁移它正在管理的进程。这样既可能放大权限,也可能让运行时的配置与内核状态脱节。若采用 systemd 管理独立测试服务,可以通过服务属性设置 MemoryMax=、CPUQuota= 和 TasksMax=,再到实际 cgroup 文件观察结果;属性值应由变更流程管理。
namespace 的权限也不能只看容器内显示的用户名。检查 id 可以知道当前视图中的身份,读取 /proc/self/uid_map 可以了解用户标识映射,但宿主机权限、Linux capabilities 和挂载暴露范围还会影响实际能力。容器里的 root 不是天然无害,也不是在所有配置下都等同于宿主机 root。判断时要把身份映射与被授予的操作能力放到一起。
进入 namespace 是管理操作,不是权限绕过。nsenter 失败时,应确认目标是否仍存活、当前用户是否拥有所需能力,以及目标 user namespace 的关系。不要把关闭权限控制当作调试的常规步骤。生产上应保留受控的观察入口,并明确谁可以读取配置、谁可以修改限额、谁可以进入目标网络或挂载视图。
6 常见坑:把隔离当安全边界完备
最常见的误解是“看不见宿主机目录,所以不可能影响宿主机”。如果将宿主机敏感目录绑定到容器中,并给予写权限,进程就可能通过这条明确暴露的路径修改真实数据。mount namespace 改变的是挂载视图,不会把绑定挂载变成副本。审查时应逐项列出源路径、容器路径和读写属性,特别关注配置、凭据、设备和运行时控制接口。
第 2 类误解是“有独立网络地址,所以网络访问已经受控”。network namespace 使端口空间和路由视图分开,但不会自动制定允许访问哪些目标的策略。容器仍可能通过已配置的网络访问其他服务;发布端口也可能把内部服务暴露到超出预期的地址。应检查监听地址、端口发布、路由和访问策略,把实际可达性测试写进验收。
第 3 类误解是“设置了内存上限,就不会再影响节点”。内存只是资源中的 1 类。大量创建线程会消耗任务名额,持续输出日志会填满存储,频繁读取共享磁盘可能拖慢邻居,过多连接也会造成压力。资源文件的覆盖范围各不相同,不能把单个限制描述成完整防护。应按工作负载行为识别主要风险,分别给出资源预算与观察指标。
第 4 类误解是“进程退出码 137 就能证明内存不足”。137 通常表示进程被 SIGKILL 终止,但管理员操作、超时强制终止和其他机制也可能发送该信号。需要把运行时的终止原因、memory.events 增量和内核日志时间线相互印证。相反,未看到应用打印错误也不能排除 OOM,因为被强制终止的进程没有机会完成日志刷新。
容器通常与宿主机共享内核,因此权限收缩与内核维护仍是必要工作。避免无理由授予高权限、避免暴露管理套接字,并结合 capabilities、系统调用限制和强制访问控制等机制形成多层约束;这些机制的详细配置留到专门内容。这里的要求是知道 namespace 只解决特定可见性问题,无法从“用了容器”直接推出安全结论。
还有更隐蔽的操作问题:容器内 PID 1 没有正确处理终止信号,部署停止时服务迟迟不退,最终被强制终止。它看起来像资源问题,实际与进程生命周期有关。应让服务以合适方式接收信号,或者使用能转发信号、回收子进程的入口程序,并给正常退出留出时间。故障分类越具体,修复动作越容易验证。
7 案例:漏配 memory 导致节点 OOM
某台 8 GiB 的测试节点运行日志采集服务和批量文本处理服务。部署者给处理服务设置了独立 PID、mount 和 network namespace,也配置了 CPU 配额,却遗漏内存硬上限。普通文件处理正常;遇到异常大的输入时,应用把完整内容和中间结果同时放进内存。节点可用内存持续下降,日志采集延迟上升,随后某个进程被内核终止。
处理服务重启后恢复,不能说明问题已经消失。如果输入再次触发同样路径,故障会重复。运维先记录故障时间、容器重启时间和受影响进程,再检查运行时资源配置。处理服务所在 cgroup 的 memory.max 显示 max。继续沿祖先检查,确认没有可将它约束在合理预算内的有限组上限。这里才能得出“缺少服务级硬限额”的配置结论。
随后关联内核日志中的 OOM 记录与节点内存曲线。节点级 OOM 的受害进程不保证就是最初增长最快的应用,日志采集也可能受影响;具体选择与当时状态有关,不能仅凭谁退出就认定谁泄漏。对于组内 OOM,也要检查相关组和祖先的事件与日志。应分别建立资源增长来源和被终止对象的证据,避免把两者混为一谈。
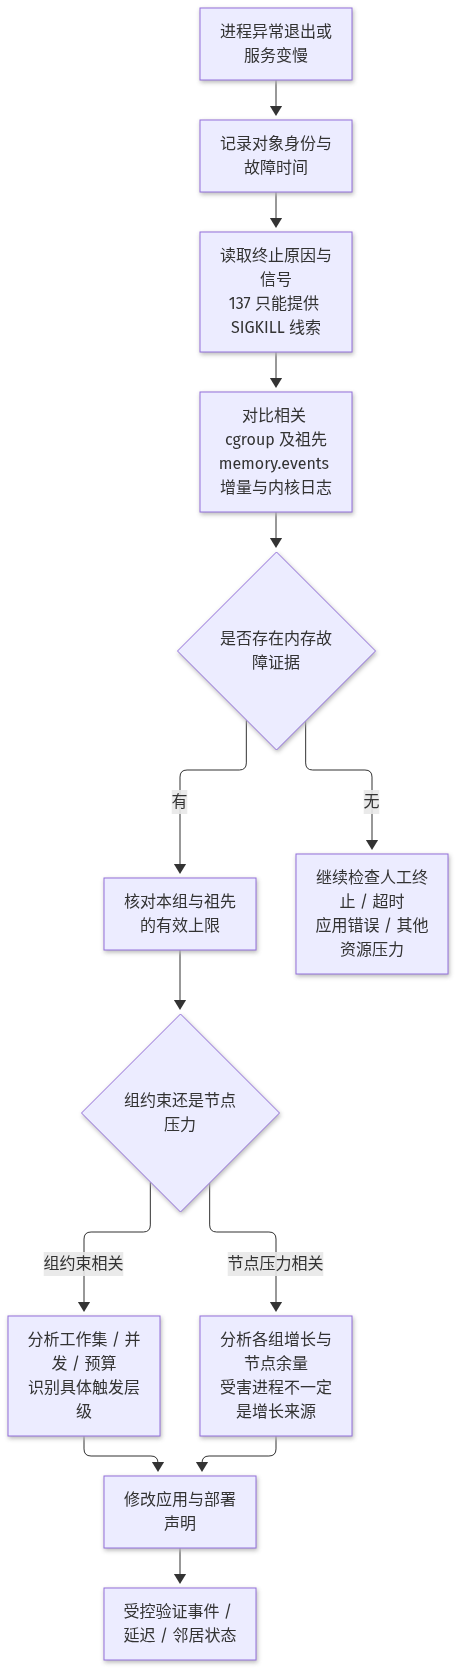
修复包括应用和部署 2 部分。应用改为按块读取,限制同时处理的输入数量,并在输入超出约定时返回明确错误。部署侧根据测试工作集为处理服务设置例如 1536 MiB 的硬上限,保留合适余量,同时限制任务数量,并为日志采集与操作系统预留预算。这个数值只是本案例起点,不能复制成所有服务的默认答案。
验收使用受控测试输入,观察处理服务的峰值、事件计数和重启行为,同时检查日志采集延迟与节点可用内存。若限额下仍然持续 OOM,应判断是预算过紧、并发过大还是应用仍有无界增长;单纯自动加大限额可能把问题重新推回节点。测试要有停止条件,不能在共享生产节点上故意制造全局 OOM。
最终记录应包含触发输入特征、未限制时的增长路径、约束生效位置、应用修改以及对邻居服务的影响。事件中即使没有进程被终止,只要持续回收造成明显停顿,也应视为容量风险。内存保护的目标不只是“没有退出”,还包括在约定负载下维持可接受的延迟,并让超预算时的失败范围可预测。
8 把隔离与配额写进部署规范
部署规范应将“隔离”展开为可核对的事实:哪些进程共享 PID 视图,哪些目录被挂载,是否使用宿主机网络,用户标识如何映射,以及有哪些额外能力。默认选项也需要记录,因为运行时版本、部署工具或启动参数变化都可能改变默认行为。审查者应能依据声明重建实际边界,而不是只看到“容器运行”这类笼统描述。
资源部分至少说明 CPU 配额或权重的目的、内存正常工作集与硬上限、任务数量预算,以及日志和临时文件的存储安排。单位必须明确,例如 MiB、GiB、微秒和百分比,避免把 1536 MB 与 1536 MiB 当作完全相同。还要写清限制属于哪个层级,父组有多少预算,所有服务同时达到预期峰值时是否仍留有节点余量。
配置应从部署入口下发,再由内核接口验收。比如运行时声明内存上限后,检查实际 memory.max;声明 CPU 配额后,检查 cpu.max 和压力期间的节流变化。不能只凭配置文件里出现了字段就宣告生效,也不要直接改内核文件后忘记更新部署声明,否则服务重建可能悄悄恢复旧配置。
规范还要描述故障时由谁接手。应用负责人解释输入、并发和工作集;平台负责人确认层级、限制和节点容量;运维保留事件和日志证据。报警可覆盖内存接近预算、OOM 事件增量、任务数量接近上限和持续 CPU 节流,但阈值与持续时间应根据服务特性确定。瞬时峰值与持续异常需要不同处理,避免报警噪声掩盖真正故障。
验收包含正常、突发和超预算 3 类情形。正常负载下检查延迟与错误率;突发时检查余量、回收和节流;超预算时检查错误是否清楚、重启是否受控、邻居是否仍可运行。把命令、采样时间和预期现象写进记录,并给配置调整设定回滚入口。这样,隔离与配额才从口头约定变成可以复查的部署条件。
9 从容器隔离走向性能分析(S30)
理解边界后,性能问题的提问方式也会改变。看到服务响应变慢,先问它的工作发生在哪个 namespace、资源记在哪个 cgroup、上级给了多少额度,再问应用自身是否需要更多计算。否则,主机 CPU 看似空闲时,你可能错误地排除 CPU 瓶颈,而实际上服务已经耗尽自己的配额,正在等待下个周期。
内存同样如此。主机还有可用内存,不代表受限组能继续申请;组内 memory.current 尚未达到硬上限,也不代表没有回收压力,可能已经触及 memory.high 或受到祖先约束。反过来,内存使用较高也不自动意味着泄漏,其中可能包含可回收缓存。必须结合时间变化、应用负载、事件与延迟,才能判断资源使用是否异常。
进入 S30 时,我们会把“慢”拆成可测量的问题:请求在消耗 CPU、等待资源,还是等待外部响应。这里先掌握观测纪律:选择固定时间窗口,记录相同对象的计数增量,把工作量、耗时和资源变化放在同 1 条时间线上。累计值适合比较差值,瞬时值适合观察状态,两者都需要明确采样口径。
工具输出也有视角。宿主机看到的 PID 与容器内看到的 PID 不同,容器里的文件路径与宿主机的路径可能不同,CPU 百分比的分母也可能不同。转交排查材料时,应附上 namespace 与 cgroup 身份,以及工具运行位置。这样接手者才能知道 2 份记录是否描述同 1 个进程、同 1 段负载和同 1 份资源预算。
本课先停在可见边界、有效限额和基础证据,不进入调度器算法、内核协议栈或复杂跟踪机制。掌握这些入口后,就能在更深入的性能分析中先排除配置与视角误差,让后续测量回答明确问题,而不是因为工具输出很多就误以为已经找到原因。
放进方案里
给批量文件处理服务制定部署方案时,先写清运行边界:服务使用独立的 PID、mount 和 network namespace;输入目录以只读方式挂载,结果目录单独授予写权限;进程以约定的普通用户身份运行,并记录是否启用 user namespace 及其映射。说明需要访问的目标地址与端口,以及服务的监听地址,让网络验收能检验真实可达范围。
资源预算依据受控样本确定。记录正常输入、最大约定输入和目标并发下的内存峰值,再给出包含余量的 memory.max。同时说明 CPU 配额、任务数量上限和临时文件预算,列出父组限制与节点预留。若采用 1536 MiB 作为起始内存上限,应注明样本与负载依据,禁止仅因其他服务使用该数值就照搬。
上线验收由部署配置与实际状态共同完成:取得宿主机 PID,对照 namespace 标识,定位 cgroup,读取 CPU、内存和任务数量的有效约束,并检查祖先层级。测试正常处理、短时突发和超过约定输入的行为,确认服务能够明确拒绝或受控失败,日志采集与其他关键服务仍然可用。
边界验收要留下反向测试证据:在容器内尝试写入只读输入目录,应失败且宿主机文件保持不变;从指定客户端验证发布端口,只允许约定来源访问。若配置共享宿主机网络,应明确端口冲突与回环地址语义的变化。保存测试位置、目标地址、返回结果及对应挂载信息,避免仅凭 namespace 编号不同就判定边界合格。
运行期间保存资源曲线、事件计数增量、重启原因和关联日志。出现内存故障时,应用负责人检查输入与并发,平台负责人检查组级及节点级约束;调整限额前先解释增长来源,并评估节点剩余预算。方案同时写明回滚配置、测试停止条件和责任人,使下一次复盘可以依据同样的接口重现判断。
10 小结:下一步性能分析方法(S30)
namespaces 决定进程看到的系统对象,cgroups 组织资源计量与约束,权限配置决定进程能够执行的操作。它们配合构成容器运行条件,但不能相互替代。观察时,从宿主机 PID 连接 /proc/<pid>/ns/ 与 /proc/<pid>/cgroup,再核对实际资源文件和祖先限制。
进入 S30 前,试着用自己的话回答:为什么 2 个容器可以监听同 1 个端口?为什么主机还有内存,服务仍可能发生 OOM?为什么退出码 137 需要额外证据?能分别给出边界、限额和事件链,就具备了进一步分析 CPU 时间、等待与延迟的基础。