1 进程调度深入要解决什么
在 Linux 主机上执行 top,看到 CPU 使用率只有 45%,并不意味着交互命令总能立即响应。某个 shell 可能迟迟得不到运行机会,网络服务的少数请求可能明显变慢,而后台压缩仍在持续前进。进程调度深入要回答的是:已经能够运行的线程,何时获得哪个逻辑 CPU,以及获得运行机会后,为什么仍可能很快停下来。这里讨论 Linux 的常见行为,具体工具字段和策略支持以目标系统为准。
调度的直接对象通常是线程。进程拥有地址空间和文件等资源,进程中的线程分别参与运行竞争;因此,给某个进程设置策略时,必须确认工具作用于哪个线程、是否覆盖已有线程,以及新线程如何继承设置。后文为了方便会说“进程得到 CPU”,观测时仍应下钻到线程。1 个拥有 8 个忙线程的进程,与 1 个只有 1 个忙线程的进程,对 CPU 的需求并不相同。
先区分运行、可运行和等待。运行表示线程正在 CPU 上执行;可运行表示条件已经满足,但还在等待运行机会;等待表示线程正在等待磁盘、网络数据、锁或其他事件。读文件的程序如果被存储延迟卡住,提高调度优先级也不能让数据提前到达。网络接收线程可能先等待数据,数据到达后进入可运行状态,再等待 CPU,最后才执行解析;端到端延迟包含这些不同阶段。
可以把可见响应时间粗略拆成“等待外部事件的时间 + 等待 CPU 的时间 + 实际执行时间”,必要时再加入应用队列。这个拆分用于组织证据,不能直接把几个工具的平均值相加当成精确结论。ps 中的状态是采样瞬间的信息,R 也可能包含正在运行和等待 CPU 的线程;看到 S 并不能直接断定程序没有性能问题。要结合持续采样、线程身份和应用记录解释。
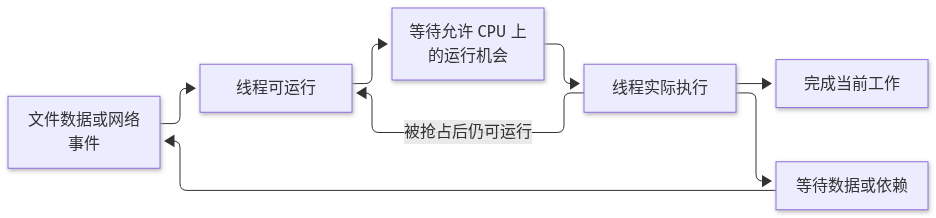
本课以共享 Linux 主机为场景:交互 shell、后台计算、日志写入和网络服务同时运行。目标不是记住调度器全部内部结构,而是建立能够检验的假设。例如,“响应变慢是因为允许使用的 CPU 上存在持续竞争”,就比“系统负载高”更具体。前者可以通过亲和性、线程数、CPU 利用率和调度等待证据检验,也能指导可回退的配置变更。
2 CFS 与公平份额直觉
CFS 是理解 Linux 普通调度公平性的经典入口。它尝试让可运行的普通线程按权重分享 CPU,而不是承诺每个线程每隔固定时间运行。较新的 Linux 内核可能在公平调度类中采用 EEVDF 等选择机制;本课沿用 CFS 的权重和虚拟运行时间直觉,不把简化模型当成所有内核版本的精确实现。排查时要记录内核版本,避免拿旧图解硬套新行为。
设想只有 1 个可用逻辑 CPU,存在 2 个持续计算、相同权重的普通线程。经过足够长的观察窗口,它们通常各得到接近 50% 的 CPU 时间。如果增加到 4 个同权重线程,每个大约得到 25%。这里的前提是线程一直可运行、没有额外配额限制、没有其他调度类干扰,也没有分组权重改变竞争关系。它描述长期份额,不保证任意 1 ms 窗口都恰好均分。
虚拟运行时间可以理解为“按权重折算后的已用 CPU 时间”。线程执行后会积累这份账;权重较高时,相同实际执行时间对应的账增长较慢,因此长期能获得更多实际时间。把它想成公平记账有助于理解方向,但不能据此推导真实系统每次切换的准确时间点。线程睡眠、唤醒、分组和内核版本都会影响具体选择。
nice 值通常在 -20 到 19 之间,数值越小,普通调度中的权重越高。nice -n 10 command 可以用较低的普通优先级启动后台任务,renice -n 10 -p PID 可以调整指定目标。改变 nice 不会把线程变成实时线程,也不会为它预留某个 CPU。向更高优先级调整通常需要额外权限;命令执行后应核对结果,而不是只记录操作意图。
对于普通调度权重,nice 0 与 nice 5 的典型权重约为 1024 与 335。若它们是同组内仅有的 2 个持续可运行线程,在同 1 个 CPU 上竞争,理想化份额约为 75% 与 25%。这不表示 nice 0 的每次请求必然快 3 倍。请求还可能等待文件系统、锁和网络,而且更短的计算时间也未必消除应用排队。相对权重必须放在实际竞争范围里解释。
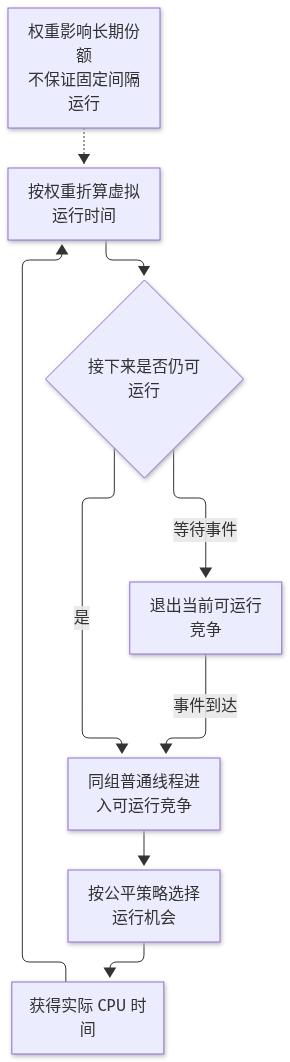
公平还有范围。服务可能被放在不同的 cgroup 中,分组权重和 CPU 配额会影响它实际获得的时间。cpu.weight 表达竞争时的相对权重,cpu.max 表达周期内的带宽上限,它们不是同一种承诺。某组达到配额后,即使主机还有空闲 CPU,也可能暂时不能继续运行。交互登录环境也可能存在自动分组行为。因此,分析“为什么没有均分”时,应先确认调度类、组和限制,再讨论算法。
3 实时调度与普通进程边界
普通调度追求共享资源时的合理进展;实时调度关注更强的优先顺序,但“实时”并不等于“任何请求都能按时完成”。Linux 常见的实时策略包括 SCHED_FIFO 和 SCHED_RR。在可运行且允许使用同个 CPU 的条件下,实时线程通常优先于普通线程。它们的静态实时优先级与 nice 是不同维度,不能把两者写在同条数字刻度上比较。
SCHED_FIFO 线程获得运行机会后,会持续运行,直到阻塞、主动让出,或被更高实时优先级的线程抢占;同优先级线程也有排队规则。SCHED_RR 在同优先级实时线程间增加时间片轮转。这里先掌握“更高实时优先级会压过较低优先级,以及普通线程可能长期等待”的边界即可,不展开其他实时策略的准入与内部算法。
用 chrt -p PID 可以查看指定目标的策略和优先级,也可以用 ps -L -p PID -o pid,tid,cls,rtprio,ni,psr,comm 查看线程。CLS 等字段的展示缩写随工具版本可能不同,应结合本机手册解释;实时线程的 nice 值也不能作为其运行顺序的主要依据。对多线程服务,应查看所有相关 TID,避免只查看主线程后得出整个进程都使用相同策略的结论。
不要在共享生产主机上用无限循环试验高优先级 FIFO。若它一直可运行,监控、shell 或负责提供数据的普通线程都可能受挤压,甚至连回退操作也变得困难。系统可能提供实时带宽限制等保护,但其配置可能改变,不能把默认保护当成实验的可靠退出机制。需要实际验证实时策略时,应在有控制台和外部恢复路径的隔离环境里,用有界负载和明确期限操作。
优先级提高也不会自动解除依赖。假设高优先级线程等待某个锁,而持锁线程优先级较低;继续提高等待者优先级,未必能缩短持锁时间。类似地,网络服务的处理线程优先级很高,但日志路径持续阻塞,它仍可能无法完成请求。排查应写清“谁在等谁”,而不是把每次停顿都归因于调度器没有偏爱关键线程。
把锁依赖放到同个 CPU 上看,会出现优先级反转。假设低优先级线程 L 已持有连接表的互斥锁,高优先级网络线程 H 被唤醒后申请这把锁,于是阻塞;此时中优先级计算线程 M 持续可运行。若 3 者使用实时策略且优先级依次为 H、M、L,H 阻塞后,调度器会选择 M,L 得不到运行机会,也就无法解锁。H 的等待因此受到本来优先级低于自己的 M 影响。即使 L 的临界区只需要 200 μs CPU 时间,墙钟持锁时间也可能因抢占远超这个数值。
优先级继承针对这条依赖链提供帮助:支持该协议的互斥锁发现 H 正在等待 L 时,可让 L 临时继承等待者的较高优先级,使它有机会越过 M 完成临界区;解锁后再按剩余依赖恢复有效优先级。不能假定所有锁都有这种行为。使用 POSIX 线程互斥锁时,需要明确配置并检查 PTHREAD_PRIO_INHERIT 的支持与初始化结果;默认互斥锁不能作为已启用继承的证据。自旋等待也不是通用补救:H 若持续占据 L 唯一可用的 CPU,反而可能阻止持锁者推进。
继承仍不能消除锁内的外部等待。若 L 持锁调用阻塞式日志写入,存储迟迟不返回,提升其有效优先级不会缩短设备服务时间;若存在循环锁依赖,继承也不能解除死锁。因此应优先缩短临界区,避免在锁内执行不可控的阻塞操作。验证时按同条时间线记录 H 开始等锁、L 被抢占和恢复、L 解锁、H 再次运行的时刻,区分锁等待与解锁后的 CPU 等待。只有看到持锁者受抢占拖延,且对照调整使这段拖延缩短,才能支持优先级反转的判断;单个慢请求或切换次数增加都不够。
4 动手:用拓扑与负载观察调度行为
先在可丢弃的 Linux 实验环境中观察普通调度。实验只需要标准 shell、taskset、ps,以及可选的 mpstat、pidstat。后 2 个工具通常来自 sysstat 软件包,未安装时可用 top 的线程视图作初步观察。容器中的可见 CPU、允许使用的 CPU 和配额不一定一致;先记录限制,再选择实验目标,不能默认 CPU 0 一定可用。
先执行下面的只读命令。lscpu 展示逻辑 CPU、核心和插槽的对应关系;Cpus_allowed_list 给出当前 shell 允许使用的 CPU 列表。在同个物理核心上的 2 个硬件线程,并不等价于 2 个完全独立的物理核心。本课只利用这点避免错误对照,不深入硬件执行资源的共享细节。
lscpu -e=CPU,CORE,SOCKET,ONLINE
grep Cpus_allowed_list /proc/self/status
cat /sys/fs/cgroup/cpu.max
最后 1 条只适用于相应路径存在的 cgroup v2 环境,而且挂载视图可能不同;路径不存在不能解释成“没有任何限制”。也应查看实验任务实际所属的组,例如读取 /proc/PID/cgroup,并确认祖先组是否有限制。实验记录要区分无法取得证据与已经证明无限制。读取这些系统接口属于课内操作示例,不要求读者在任何主机上盲目执行写操作。
从允许列表选出 1 个 CPU。下面假设 CPU 2 可用,若不成立就替换 cpu 的值。2 个工作进程各计算 15 秒,并竞争同个 CPU;SECONDS 依赖 Bash。循环只用于制造可辨认的短时 CPU 负载,不代表真实业务。不要在工作目录中生成大量临时文件来模拟计算,这会混入文件系统因素。
cpu=2
taskset -c "$cpu" bash -c 'end=$((SECONDS + 15)); while (( SECONDS < end )); do :; done' &
p1=$!
taskset -c "$cpu" bash -c 'end=$((SECONDS + 15)); while (( SECONDS < end )); do :; done' &
p2=$!
ps -L -p "$p1,$p2" -o pid,tid,cls,ni,psr,pcpu,stat,comm
pidstat -u -w -p "$p1,$p2" 1 5
wait "$p1" "$p2"
相同权重且没有其他明显竞争时,2 个进程应在采样窗口里获得接近的份额,但不要求每行输出完全相等。ps 的 %CPU 常带有进程生命周期口径,pidstat 的区间值更适合比较短窗口。工具还可能用不同方式表示多 CPU 百分比;先读懂口径,再解释“100%”。PSR 是最近执行的 CPU,并不是完整迁移历史,也不是亲和性设置本身。
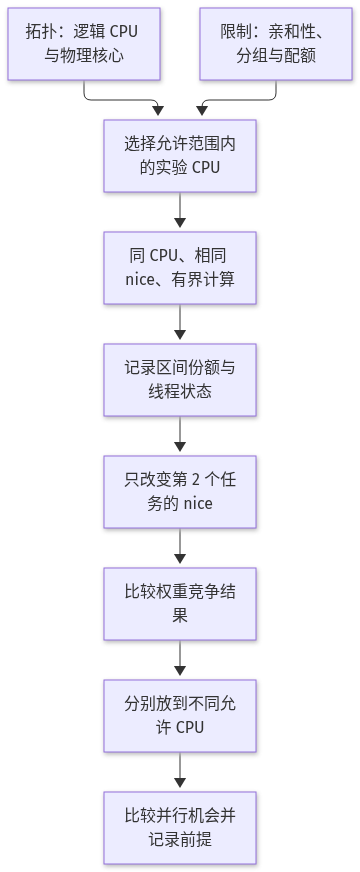
接下来重新运行同样的短实验,将第 2 个启动命令改为 nice -n 5 taskset -c "$cpu" bash -c ...,保留原来的完整循环参数。观察份额是否向默认 nice 的进程倾斜。不要拿上次已经退出的 PID 做调整;新实验要重新捕获 $!。再选出另 1 个允许使用的 CPU,将 2 个进程分别放置,比较“同 CPU 竞争”与“允许并行”的区别,每次只改变 1 个条件。
如需提前清理,在仍保留本次 PID 变量的 shell 中执行 kill "$p1" "$p2",随后 wait 回收;目标已经退出时出现错误是可能的。不要复制历史 PID 到很久以后的会话中。实验结论至少记录允许 CPU、实际亲和性、nice、观察窗口、后台负载和是否受组限制。若结果不符合预期,应先检查前提;1 次偏差不足以说明公平调度失效。
5 亲和性、迁移与负载均衡
CPU 亲和性是线程允许运行的 CPU 集合。taskset -pc PID 可以读取指定任务的集合,taskset -pc 2,3 PID 可以修改它,但命令中的 CPU 必须处于目标可用范围。对现有多线程程序,默认操作未必覆盖所有线程;工具支持时可使用 taskset -apc PID 查看全部线程,并在变更时明确是否使用 -a。仅修改主线程后看到工作线程继续在其他 CPU 运行,不能据此断言设置无效。
亲和性提供的是许可范围,不是资源所有权。把服务绑定到 CPU 2,并不会阻止其他任务也在 CPU 2 上运行;把 8 个忙线程全部绑定到 CPU 2,也不会让它们同时执行。有效范围还受到 cpuset 等限制的约束。若要实现可预期的资源分配,需要核对其他任务、组设置和运维方式,不能只保存 1 条 taskset 命令。
调度器会根据可运行负载等因素在允许范围内分配任务,必要时迁移线程。迁移可能帮助缓解排队,也可能增加访问近期数据的成本。反过来,绑定线程可能保持局部性,却失去利用其他空闲 CPU 的机会。这是需要测量的取舍:不要把“迁移次数少”直接等同于“性能好”,也不要把每次迁移都视为异常。
拓扑会改变对照结果。把工作线程从同个物理核心的硬件线程移到不同物理核心,可能与只更换逻辑 CPU 编号产生不同效果。因此,做绑定实验应写出 CPU 与 CORE 的对应关系,不能只写“用了 2 核”。若工具和权限允许,可用 perf stat -e context-switches,cpu-migrations -- command 对有界命令做辅助观察;事件不可用时,应保留缺失说明,不能用上下文切换次数代替迁移次数。
一般先让调度器在合理范围内分配负载,再由明确证据支持收窄亲和性。比如只有在反复出现特定竞争、且对照实验显示绑定改善目标指标时,才考虑固定集合。每次变更应保存原集合和线程清单,约定恢复方式,并检查重启后配置是否仍会生效。临时命令可能被服务重启、线程重建或管理配置覆盖;持久方案必须与实际启动入口一致。
6 常见坑:把平均延迟当尾延迟
平均延迟回答总体耗时水平,尾延迟回答慢端请求经历了什么。假设 100 个请求中,99 个耗时 5 ms,1 个耗时 505 ms,平均值是 10 ms;单看平均值容易忽略那次明显停顿。p99 是某个统计口径下约 99% 样本不超过的值,具体分位数算法可能不同。小样本下不能凭 1 个 p99 数字判断稳定性,更不能把 p99 解释为最大值。
调度竞争常以突发方式暴露:后台任务开始计算、多个线程同时唤醒,或某个受限组用完当期配额。多数请求可能遇不到冲突,少数请求却在可运行队列中等待。主机整机平均 CPU 利用率会掩盖局部热点;例如 8 个逻辑 CPU 中只有 1 个持续饱和,绑定在该 CPU 上的服务仍可能明显变慢。用 mpstat -P ALL 1 5 查看逐 CPU 区间值比只看整机均值更有帮助。
同样,load average 也不是“CPU 等待队列长度”的直接替代品。在 Linux 中,它还受到不可中断等待任务等因素影响,并具有时间平滑特征。负载高而 CPU 不忙,可能需要检查存储等等待;CPU 忙也不能单独证明关键线程等待了多久。pidstat -w 展示的自愿与非自愿切换计数可以辅助识别行为,却不是每次请求的调度延迟计时器。
测量尾延迟必须固定入口和窗口。客户端测得的延迟可能包含网络往返、服务入口排队与执行;服务内部计时可能只覆盖处理函数。压测工具在上个请求变慢后才发送下个请求,还可能减少慢时段的实际到达量,从而低估排队。入门阶段至少记录发送方式、目标到达率、成功数、超时数、错误数以及分位数,不把超时请求从报告里悄悄删掉。
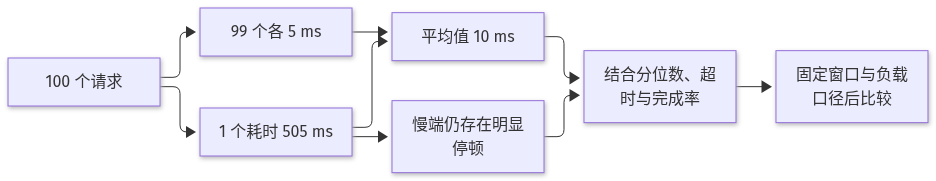
比较配置时,应使用相同负载模式和足够覆盖突发的窗口,重复有代表性的时段。若平均延迟下降但 p99 上升,需要判断产品目标是否允许这种变化。还应检查吞吐是否下降;系统少接了请求,剩下请求变快,并不证明容量提高。调度优化最终服务于明确的响应与完成目标,CPU 图更平滑只是旁证。
7 案例:错误亲和导致的抖动
某台实验服务器有 8 个逻辑 CPU,网络服务包含 4 个工作线程,另有定时日志压缩任务。变更前,服务允许在 CPU 2–5 上运行;运维为减少迁移,将所有工作线程固定到 CPU 2。白天平均响应仍接近 8 ms,压缩任务启动时 p99 从 30 ms 上升到 180 ms。整机 CPU 利用率只有约 35%,于是最初的怀疑转向了网络链路。
先核对时间范围。应用记录显示慢请求主要集中在压缩任务运行期间,客户端错误数没有明显增长;这只建立了相关性,还不能直接证明调度原因。接着对齐相同时段的逐 CPU 利用率,发现 CPU 2 接近饱和,而多个其他 CPU 仍有余量。查看线程允许集合后,确认 4 个工作线程都只能使用 CPU 2,压缩进程也允许在该 CPU 上运行。
这个组合说明了可检验的机制:服务的可运行线程被限制在较窄范围内,与后台任务共享运行机会,空闲 CPU 无法替它们执行。仍需排除其他共同变化,例如压缩同时增加文件系统等待、日志路径发生阻塞,或者请求量本身上升。检查文件等待和应用阶段计时有助于区分原因;没有证据时,不应把所有 180 ms 都算成 CPU 等待。
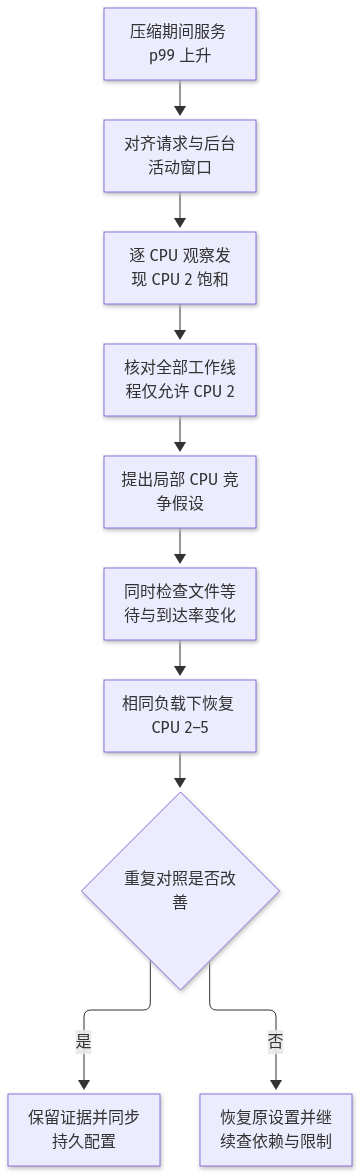
修复实验先恢复已知的 CPU 2–5 允许范围,覆盖全部工作线程,保留相同请求模式与后台压缩。恢复后 p99 回到约 35 ms,逐 CPU 负载也更分散;再安排重复对照,确认差异没有依赖单个偶然窗口。这里的数值是案例观测,不是绑定策略的通用收益。若恢复没有改善,就应继续检查配额、存储等待和应用锁,不能为了维护原假设而忽略反证。
最终记录包含变更前后线程集合、CPU 拓扑、服务到达率、完成率、尾延迟和压缩任务时间。持久配置同步回服务启动入口,并安排重启后核对;否则临时修复可能在下次发布后消失。该案例的教训是:亲和性缩小了调度器可选择的空间,只有当局部性收益超过排队代价时才可能有利,而“整机还有空闲”无法证明关键线程有可用运行机会。
8 把调度假设写进容量与 SLO 方案
容量方案应先定义服务目标,再描述资源。比如约定“在指定请求组合、到达率 200 次/秒、后台任务同时运行时,5 分钟窗口内成功请求 p99 不超过 100 ms,同时超时率不超过 0.1%”。这是可测试的目标描述,实际数值应来自需求。必须注明延迟测量位置、超时如何计入、样本不足时如何处理,避免用不同口径讨论同个 SLO。
然后把调度假设显式列出:关键线程使用普通调度;允许 CPU 范围有多少逻辑 CPU、对应哪些物理核心;是否存在 CPU 配额;后台计算在哪个组运行;是否允许修改 nice;正常和故障时的可运行线程规模。不要写“分配 4 核就足够”而省略这些条件。CPU 数相同,拓扑、竞争者和配额不同,可交付的运行时间也可能不同。
可以用 CPU 时间预算做初步估算。若每个请求平均需要 2 ms CPU 时间,200 次/秒对应约 400 ms CPU 时间/秒,即平均约 0.4 个逻辑 CPU 的时间需求。这只是起点:突发、后台任务、串行阶段和线程不均衡都会造成额外排队,平均需求小于 1 也不能承诺 p99。估算值应通过负载实验校准,并将文件等待和网络等待分别记录。
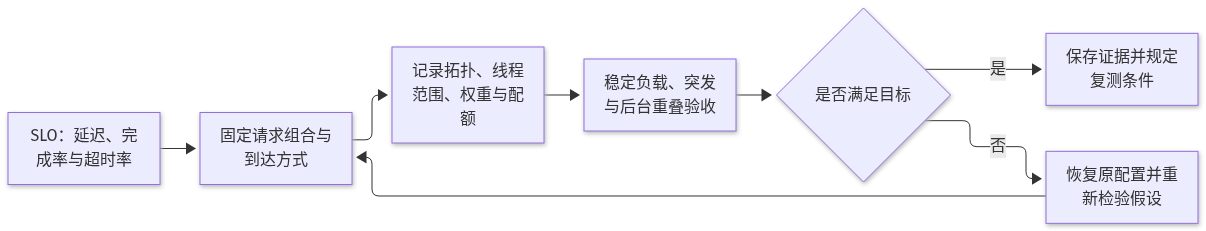
验收至少包含稳定负载、短时突发和后台任务重叠这几种情形,并检查线程实际设置与方案一致。触发回退的条件可以包括连续窗口的尾延迟恶化、超时增加、目标 CPU 饱和且其他允许外资源闲置。回退动作应具体到恢复原亲和性或原权重配置,并写清由哪个配置入口生效。若计划依靠实时策略满足目标,还必须另行验证资源饥饿与恢复边界,不能由普通调度实验直接推断。
9 从调度走向 Cache 深入(H23)
到这里,已经能把“有多少 CPU”细化成“哪些线程在什么限制下等待哪些 CPU”。仍有个现象尚未解释:2 个配置的 CPU 份额相近,请求完成速度却不同。原因可能包括线程重新运行后,访问近期数据的成本发生变化。CPU 时间并不保证每单位时间完成相同工作,因此迁移、亲和性与吞吐之间不能只用份额解释。
Cache 可以先理解为帮助处理器更快取得近期可能使用的数据的存储层次。线程在某个 CPU 上执行后,再次运行时可能受益于已有数据;迁移或工作集变化可能改变这种收益。但看到迁移增加与延迟增加同时发生,只能提出关联假设,不能证明 Cache 就是原因。调度等待、应用锁、输入变化和后台活动仍可能影响结果。
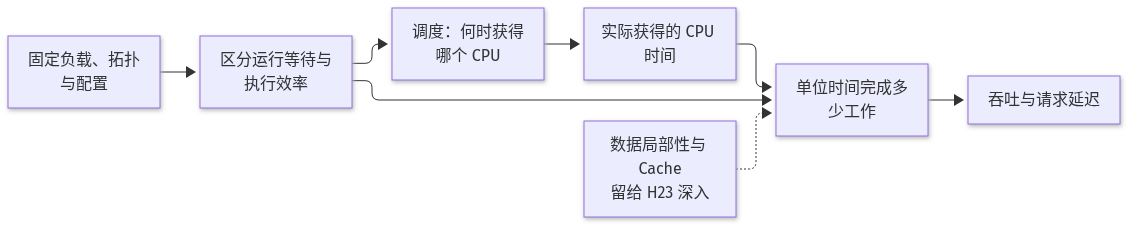
进入 H23 前,应带走可复用的实验方法:固定输入与负载,记录拓扑和允许范围,区分等待 CPU 与正在执行,保留吞吐和尾延迟,并让每次对照只改变明确条件。后续再学习 Cache 层次、局部性和工作集时,就能追问“相同运行机会为何完成不同工作量”。本课不提前展开缓存一致性、硬件计数器解释或底层优化技巧,先把调度证据整理可靠。
放进方案里
在容量方案中新增“CPU 调度假设”段落,明确服务使用的调度类、关键线程数量、允许 CPU 集合及其物理核心映射,并记录 cgroup 路径、权重和配额。填写实际内核版本与启动配置入口,说明线程新增或服务重启后怎样继承设置。把亲和性写成可核对的集合,不能只写“独占 CPU”;如果确实需要独占,还要列出隔离范围和其他任务的约束证据。
把验收负载写成能够复现的条件,包括请求组合、到达率、持续时间、并发方式和后台任务的重叠时段。记录客户端延迟的起止位置,约定 p99、完成率、超时率的统计窗口,并保留超时与失败样本。使用逐 CPU 利用率、线程状态和应用阶段计时辅助解释结果;任何缺失证据都应标明,不能把整机平均 CPU 利用率当作关键线程没有排队的证明。
为每个调度调整写出假设和对照。例如,“恢复 CPU 2–5 的允许范围,可以缓解压缩任务重叠期间的工作线程竞争”。保存原设置,在同样的请求与后台负载下比较,验收同时检查尾延迟、吞吐和错误率。若只有平均值改善而尾延迟超过目标,不能直接通过;若结果没有支持假设,就恢复设置并继续调查依赖等待。
最后写明回退阈值、操作人和配置入口,保证恢复命令覆盖相关线程,且持久配置与临时状态一致。回退后再核对实际集合与目标指标。为主机拓扑、配额或后台任务变化设置复测条件;调度结论依赖这些前提,环境变了就应重新验收。将尚未解释的执行效率差异登记为 H23 的后续问题,附上已有证据,避免直接把它命名为 Cache 故障。
10 小结:下一步 Cache 深入(H23)
调度决定可运行线程何时获得允许 CPU 上的执行机会。公平份额依赖权重和竞争范围,实时策略有更强的优先关系,亲和性则限制可选位置。诊断时先区分外部等待、CPU 等待和实际执行,再结合拓扑、组限制与时间窗口解释现象。
自测时试着解释:整机 CPU 只有 35%,为什么绑定线程仍可能排队?降低后台任务优先级为什么未必解决文件等待?平均延迟改善为什么不能证明 p99 达标?若能分别指出允许范围、依赖关系和统计口径,就可以带着可靠的调度模型进入 H23,继续理解 Cache 与实际执行效率。