1 NUMA 解决什么扩展问题
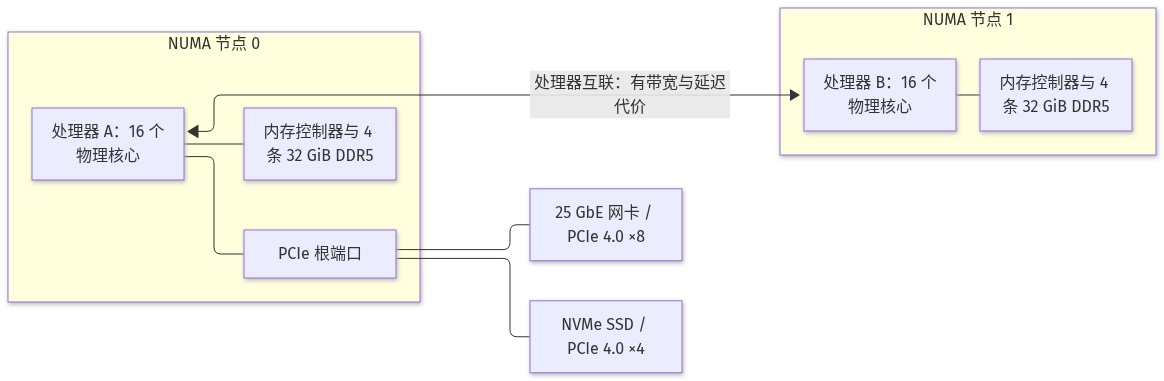
把服务器的 CPU 从 1 颗增加到 2 颗,内存容量也随之增加,程序就能快 2 倍吗?先看实物:1 台双路服务器装有 2 颗处理器,每颗启用 16 个物理核心,各连接 4 条 32 GiB DDR5 内存。整机共有 32 个物理核心、256 GiB 内存。操作系统可以把这些资源交给同一个程序,但主板上的导线没有因此消失。连接在处理器 A 内存控制器上的内存,与连接在处理器 B 上的内存,对 A 的核心来说有不同的访问路径。
如果让所有核心都经过同一个内存控制器,增加核心后,控制器和总线就容易变成拥堵点。若把内存控制器分散到不同处理器附近,每颗处理器就能使用自己的内存通道扩展带宽与容量,同时通过处理器之间的互联访问另一侧内存。这种组织方式叫 NUMA,即非一致内存访问。这里的“非一致”指访问代价不均匀,与数据是否正确、是否保持一致不是同一个问题。
NUMA 保留了程序员熟悉的共享内存使用方式:线程仍然可以通过地址访问数据,通常无需显式发送消息。变化在于,地址背后的物理内存有位置,执行线程的核心也有位置。访问同一地址,线程在不同位置运行,耗时就可能不同。操作系统看得到整机内存,并不意味着每个核心到每块内存的距离相同。
对照机器形态更容易理解。普通笔记本可能只暴露 1 个 NUMA 节点,入门实验不一定能看到本地与远端差异;双路机架服务器常见多个节点;某些单路多芯粒服务器也可能暴露多个节点。固件设置可以改变节点划分,因此“CPU 插槽数等于节点数”不能当成固定公式。实际部署应读取机器公布给操作系统的拓扑,再判断哪些核心和内存属于相近的位置。
NUMA 解决的是共享内存机器继续扩展时的物理组织问题,同时把“把工作放在哪里”变成了性能问题。容量足够只回答能否装下,核心空闲只回答能否执行。若热点数据与执行线程长期分居不同节点,机器可能出现 CPU 利用率不高、请求却持续变慢的现象。理解 NUMA 的目标,是让扩容后的硬件资源真正参与工作。
2 本地与远端内存延迟
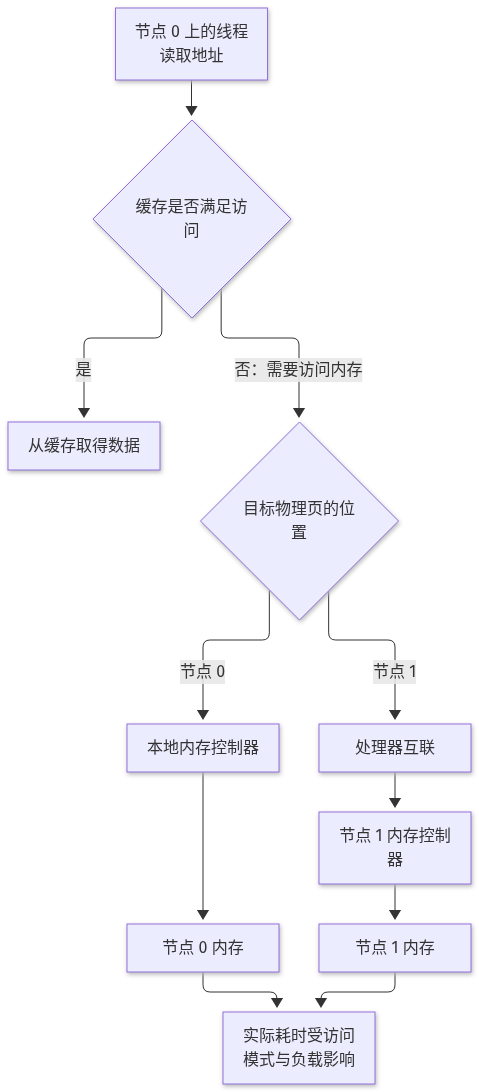
从节点 0 上的核心发起访问,如果目标物理页位于节点 0 的内存,称为本地内存访问;如果位于节点 1,称为远端内存访问。远端路径通常需要经过处理器互联,再到目标侧的内存控制器。它仍然是在访问内存,不是在读取远程服务器,也不经过以太网交换机。这里的“远”是同一台机器内部的位置关系。
为了建立量级感,假设某次受控测试测得本地访问平均 90 ns、远端平均 150 ns。这组数值只是教学输入,不能作为所有 DDR5 服务器的规格。实际结果受处理器、内存频率、通道数量、读写模式、系统负载和测量方法影响。即便在同一台机器上,空闲时测出的差值也不一定能代表高负载时的差值,互联与内存控制器都可能排队。
更要区分内存访问与程序中的每次读取。CPU 经常从缓存取到数据,只有某些访问需要继续到内存。若热点数据长期留在缓存里,改变物理页位置的收益可能很小;若程序不断追踪分散在大块内存中的指针,下一个地址又依赖上一次读取结果,额外延迟就很难被并行工作遮住。顺序扫描则可能同时推进多个访问,此时带宽往往比单次延迟更突出。
假设确实到达内存的访问里,远端比例为 p,用简化模型可以写成 L=(1−p)×90+p×150,单位为 ns。p 从 0.2 增加到 0.8 时,模型平均值从 102 ns 增加到 138 ns。它解释了位置变化为什么有代价,却不能直接推导整个服务慢了约 35%。服务还包含计算、缓存命中、存储等待与并行执行,端到端结果必须测量。
延迟之外还有带宽。若节点 0 的全部核心都读取节点 1 的大数组,节点 0 的本地内存通道可能闲着,节点 1 的内存通道与跨节点互联却已繁忙。反过来,把多个独立数组分散到各自工作线程附近,就有机会同时使用多个节点的通道。因此,NUMA 优化不能只追求远端比例最低,还要观察是否把容量、带宽与计算负载过度集中到某个节点。
3 节点、距离与互联
NUMA 节点是操作系统描述位置关系的单位。常见节点包含一组逻辑 CPU 和一部分内存,但也可能存在没有 CPU 的内存节点,或者节点暂时没有可用内存。逻辑 CPU 是操作系统可调度的执行单位,启用同时多线程后,1 个物理核心可能对应 2 个逻辑 CPU。拓扑里的 CPU 编号因此不能直接拿来当物理核心数量。
节点距离用于表达相对访问代价。Linux 上可能看到本地距离为 10、跨节点距离为 21 的矩阵。这些数字由平台提供,是相对距离信息,不是纳秒,也不能据此宣称远端访问必定慢 2.1 倍。它们适合帮助系统和管理员识别近远关系;要回答某条热路径实际多慢,还需要针对访问模式测延迟和带宽。
节点之间通过处理器互联交换内存请求和相关数据。这条路径有有限的带宽,也会受到其他流量影响。本课只要求识别“请求多经过了哪一段”,不展开互联协议、缓存一致性消息与目录结构。远端访问仍然遵守系统提供的内存语义;不能把性能变慢解释成跨节点数据天然不可靠,也不能把 NUMA 距离误读为网络丢包概率。
板上的外设同样有位置。假设 1 块 PCIe 4.0 ×4 NVMe SSD 和 1 张 PCIe 4.0 ×8 的 25 GbE 网卡都连接在节点 0 所在处理器的 PCIe 根端口下。节点 1 上的线程处理这些设备的数据时,可能额外经过处理器互联。PCIe 规格说明链路能力,网卡速率说明网络端口能力,它们都不能单独保证应用吞吐;设备、缓冲区和工作线程的位置还会影响实际路径。
这也解释了为什么仅把程序“绑定到最快的核心”不够。若网络接收缓冲区在节点 0,工作线程却在节点 1,处理数据可能跨节点;若把全部线程迁到节点 0,又可能挤压该节点的计算资源。拓扑是做选择的地图,不是自动给出最优部署的答案。先识别核心、内存、设备的相对位置,再依据实际工作量选择布局。
还要区分页的位置与最新数据的位置。物理页属于节点 0,并不表示每次读取都由节点 0 的内存条提供数据。如果节点 1 的核心刚修改了其中的数据,最新内容可能仍在该核心的缓存中;其他核心读取时,需要通过一致性机制取得正确内容。因此,观察到互联繁忙,不能直接认定远端内存条承受了同等流量,页分布也无法单独说明缓存之间的数据交换量。
例如,2 个节点上的线程各自更新一个计数器,2 个计数器恰好位于同一条缓存行。假设这台机器的缓存行为 64 B,即使线程写的是不同的 8 B 字段,硬件仍按整条缓存行协调写入权限。一侧写入后,另一侧再写,可能反复触发权限转移和失效通知,形成伪共享。此时把承载计数器的物理页绑定到任一节点,都无法让双方同时独占这条缓存行。
验证时可保持线程数、节点绑定和更新次数相同,仅把计数器分开放到不同缓存行,再比较更新吞吐与互联相关事件;缓存行大小和事件含义应按实际处理器确认。如果改善明显,问题更接近共享写入布局。若多个线程必须修改同一个计数器,填充间隔也无效,可考虑每节点累计后定期汇总,并明确汇总期间读数的时效边界。这类故障提醒我们:内存就近放置解决访问距离,共享写入的粒度还需要单独设计。
4 动手:读一张 NUMA 拓扑
在 Linux 服务器上,可以用下面的只读命令建立初步地图。部分命令依赖工具包,虚拟机内看到的也是虚拟平台暴露的拓扑。练习时先记录机器类型、逻辑 CPU 总数、内存总量,以及是否在容器或虚拟机内,再解释输出。不要把实验机的结果机械套用到生产服务器。
lscpu -e=CPU,NODE,SOCKET,CORE
numactl --hardware
cat /sys/devices/system/node/node0/distance
下面是经过简化的示例,内存数值取整,便于读图。CPU 编号只是这台示例机器的编号,不代表所有双路服务器都会按连续区间排列。
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
node 0 size: 131072 MB
node 0 free: 98304 MB
node 1 cpus: 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31
node 1 size: 131072 MB
node 1 free: 114688 MB
node distances:
node   0   1
  0:  10  21
  1:  21  10
读这张表时,先确认有 2 个节点,再把 CPU 集合与节点对应起来。节点 0 的 CPU 集合是 0–15,节点 1 是 16–31。接着看每个节点的内存容量与当前空闲量。整机空闲内存充足,不保证某个节点空闲充足;如果部署要求全部内存都来自节点 0,就必须单独检查该节点还能承受多少工作集。
最后读距离矩阵。对角线的 10 表示本地,另一侧的 21 表示更远。若有 4 个节点,不同远端位置可能具有不同距离,不能只把它们统称为同样昂贵的“另一边”。还应将 lscpu 输出中的 SOCKET、CORE 与 NODE 对照,确认是否存在同插槽多个节点,以及逻辑 CPU 是否共享同一个物理核心。
对正在运行的进程,可以进一步执行 numastat -p 1234,其中 1234 应替换成实际 PID。它能帮助查看进程内存在各节点上的分布,但分布不等于访问频率:节点 1 上有很多页,不代表当前热路径一定频繁读它们。/proc/1234/numa_maps 提供更细的映射信息,初学时只需知道它可用于追查某段映射的页落在哪些节点。
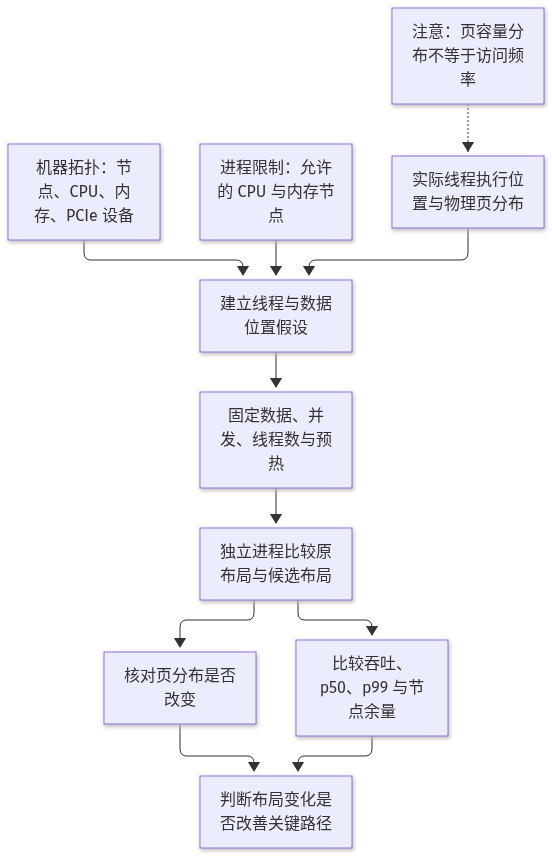
容器还要检查可用范围。/proc/1234/status 中的 Cpus_allowed_list 与 Mems_allowed_list 可以提示该进程被允许使用哪些 CPU 和内存节点。宿主机有节点 0 和 1,不代表容器都能使用。把物理拓扑、进程限制和页分布放在同一张记录表里,才能避免对着整机地图优化一个实际上只获得部分资源的进程。
5 绑核与内存策略
NUMA 布局至少要回答 2 个问题:线程在哪里执行,新分配的物理页优先从哪里取得。绑核或 CPU 亲和性主要回答前者,内存策略回答后者。只绑 CPU 不会自动搬走已有物理页;只指定内存节点也不会保证线程永远在附近运行。两者要配合,还要考虑进程启动和初始化的顺序。
Linux 上常见的匿名内存行为可用“首次触碰”来理解。程序申请地址空间时,通常不意味着对应的全部物理页已立即备齐。某个线程首次写入页面、触发实际分配时,系统才在当时的策略与资源约束下选择物理页。默认本地分配通常倾向于当前执行 CPU 所在节点,但它是带有条件的行为,不能简化成任何情况下都保证本地。
设程序准备 32 GiB 工作区,之后由 2 组线程各处理 16 GiB。如果初始化线程始终在节点 0,把整个工作区逐页写过,物理页就可能主要落在节点 0。即使随后把另一组线程绑定到节点 1,它们读取自己那半数据时也可能持续访问远端。更合理的安排是,让各组线程在目标节点初始化自己将长期处理的数据,并验证分布。
下面的命令展示策略表达方式。它们用于启动示例程序,不应直接替换生产服务的启动参数。先确认程序工作集能容纳、资源限制允许,再做对照实验。
numactl --cpunodebind=0 --membind=0 ./worker
numactl --cpunodebind=0 --preferred=0 ./worker
numactl --interleave=0,1 ./stream_scan
第 1 条约束 CPU 执行范围,并把受该策略控制的新内存分配限制到节点 0。节点内存不足时,可能出现回收压力或分配失败等结果,应实测具体运行环境。第 2 条表达内存优先来自节点 0,必要时允许使用其他节点。第 3 条把新分配页按策略交错放到多个节点,适合评估共享大数组或带宽需求;它也会使单节点线程访问其中一部分页时经过远端路径。
这些启动策略不能保证所有内存类型都按相同方式落位,文件映射、共享内存与既有页还需要具体检查。本课先抓住可操作原则:设置策略后再分配和初始化目标数据,随后测量页分布与业务表现。已有页迁移、自动 NUMA 平衡和更细粒度的内存接口留待后续。不要用“加了 numactl”代替结果证明。
6 常见坑:跨节点分配被默认分配器掩盖
应用调用内存分配函数时,看到的通常只是地址和长度,看不到节点编号。分配器为了减少系统调用,会管理内存池、缓存已释放的块,再把它们交给后续请求。某个线程拿到一块地址,不表示操作系统刚刚为它分配了全新的本地物理页。地址复用、页复用与线程迁移叠加后,代码里的“由谁申请”可能与硬件上的“页在哪里”脱节。
例如,节点 0 的初始化线程构建了对象池,节点 1 的工作线程随后从池中取对象。对象在业务逻辑上属于节点 1,物理页却可能早已在节点 0。开发者只查看分配函数的调用位置,会觉得内存是在工作线程附近获得的;实际上,分配器只是返回了已经存在的内存。这个问题不说明默认分配器有缺陷,而是它提供的接口没有承诺 NUMA 本地性。
另一个常见误判是把“释放后重新申请”当成重置位置。分配器可能保留这部分内存,下一轮继续使用原页。实验如果反复在同一个进程里切换参数,就可能受到上一轮布局影响。对照测试可以采用独立进程和明确的初始化过程,并记录是否启用了内存池、预热与后台任务,避免把不同起点误认为同一种条件。
还有“绑核后数据自然跟着走”的误判。CPU 亲和性改变的是执行位置,不能据此推断已有数据迁移完成。系统可能启用了自动 NUMA 平衡,但其效果依赖内核、访问模式、限制与运行时长。短测试中它未必来得及改善布局,长测试中又可能改变初始分布。因此应记录相关环境,在相同条件下比较,而不是笼统地开启或关闭后宣布结论。
排查时可先沿 3 条线索收敛:线程实际在哪些 CPU 上运行,热点映射的物理页落在哪些节点,业务在受控布局下是否改善。进程总量分布只能帮助定位,硬件性能计数器也需要正确解释。即使观察到远端访问,也要继续判断它是否位于关键路径;后台扫描的跨节点流量与阻塞请求处理的跨节点读取,影响可能完全不同。
7 案例:远程内存拖慢本应本地的热路径
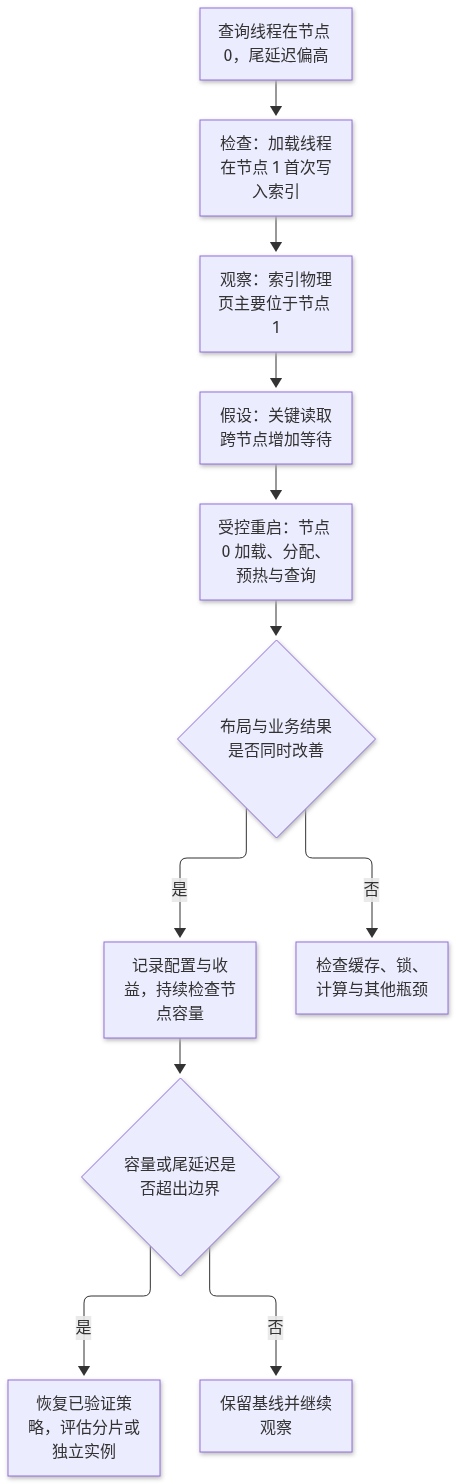
某服务在双路服务器上维护 48 GiB 的只读索引,接收 25 GbE 网卡送来的查询。每颗处理器连接 128 GiB 内存,网卡位于节点 0 的 PCIe 路径下。索引加载自 NVMe SSD,加载完成后查询主要访问内存。为减少网络处理的跨节点路径,管理员把查询线程集中在节点 0,却发现增加线程后吞吐改善很小,p99 延迟明显上升。
先确认热路径。请求到达后,工作线程会根据前一次读取结果继续查找下一层索引,这是一种对内存延迟比较敏感的访问模式。存储监控显示运行阶段 SSD 读取很少,网络端口也未达到可用吞吐上限。CPU 总利用率不高并不能排除内存等待;这些信息只是缩小范围,还不能直接证明 NUMA 是原因。
检查启动流程后发现,索引加载线程运行在节点 1,并在加载时写入全部索引页。后续查询线程虽然固定在节点 0,索引物理页仍主要位于节点 1。进程内存分布显示节点 1 占据大部分索引容量,与初始化路径相符。此时形成了明确假设:关键查询不断从节点 0 跨互联读取节点 1 的索引,额外延迟限制了吞吐。
为验证假设,测试组使用相同输入数据、固定请求并发和相同线程数量,分别启动原配置与调整后的独立进程。调整方案让加载线程和查询线程都在节点 0,索引分配优先使用节点 0,并在开始计时前完成相同预热。测试期间记录页分布、吞吐、p50 与 p99 延迟,以及各节点内存余量。它们共同回答“布局变了没有”和“用户体验变了没有”。
假设这次实验的原配置为 8 万次查询每秒、p99 为 4.8 ms;调整后达到 10 万次查询每秒、p99 为 3.6 ms。这里的数据只用于说明证据写法,不能变成通用收益承诺。若页分布已经改善而业务指标没有变化,应重新检查缓存命中、锁竞争或计算瓶颈,不能为了符合故事而认定 NUMA 优化必然有效。
修复也有容量边界。当前 48 GiB 索引可以放入节点 0,但未来增长到 140 GiB 时,单节点布局就不再合适。可评估按查询键分片,让每个节点处理本地索引;只读数据也可考虑副本,但副本增加内存用量与更新成本。此处先把容量风险写进方案,复杂的数据分片与一致更新设计另行讨论。
8 把 NUMA 感知写进部署清单
部署清单应首先描述机器事实:插槽数、NUMA 节点数、每节点可用内存、核心与逻辑 CPU 的对应关系,以及关键设备所在的 PCIe 路径。不能只写“32 核、256 GiB”,因为同样的总量可能来自不同布局。若服务器更换主板、固件设置或虚拟机规格,应重新读取拓扑,不能沿用旧 CPU 编号。
接着描述工作负载。写清常驻工作集、峰值内存、初始化方式、主要读写模式与设备数据流。例如“48 GiB 只读索引,启动时全量写入,查询为随机指针读取”,就比“内存密集型服务”更能指导部署。多个实例可以分别放在不同节点,但还要为内核、设备缓冲区和后台任务留下余量,不能让每个实例都按节点总容量申请内存。
策略部分要同时写执行范围与分配策略。明确使用固定 CPU 集合还是节点集合,内存是限制到某个节点、优先本地还是交错分配,以及策略从哪个启动阶段开始生效。如果应用依赖每个工作线程初始化自身数据,也应列为启动契约。启动成功只能证明进程能运行,不能证明内存按预期落位。
验收部分应保留可比较的基线。固定数据规模、请求形态、线程数和预热条件,记录吞吐、延迟分位数、每节点内存与进程页分布。对持续运行的服务,还要观察达到稳定状态后的情况。某个参数在空闲机器上有利,在同机部署其他实例后可能因带宽争用失去收益,因此应使用接近实际资源竞争的条件进行验收。
最后规定失效时如何处理。例如,节点可用内存低于预留线时拒绝增加实例,严格绑定导致分配异常时回退到已验证的优先策略,升级后性能下降时恢复原启动配置。回退也要观察性能与容量,不能把“允许远端”视为没有代价。NUMA 感知的部署清单应让另一位管理员能够复现布局、判断效果并完成回退。
9 从 NUMA 走向内存管理深入(S24)
到这里,我们一直在区分地址与物理页的位置。程序使用的地址并不直接写着节点编号,操作系统需要把虚拟地址映射到物理页。也正因为存在这层映射,申请地址空间、首次触碰、物理分配和页面迁移可以发生在不同时间。理解这条时间线,是继续学习内存管理的入口。
带着 NUMA 问题进入 S24,可以提出几个更精确的问题:申请了 32 GiB 地址空间,为什么当前实际驻留内存还很少?首次写入为什么可能触发缺页处理?进程释放一块对象后,为什么系统观察到的驻留内存未必马上下降?这些问题分别涉及地址空间、物理页建立与分配器管理,不能仅用“内存不够”概括。
页面大小也会影响观察粒度。常见基本页大小可能是 4 KiB,但具体平台应实际查询。应用里的对象可能只有几十字节,系统分配与迁移通常按页或更大的单位处理。多个对象共用同一页时,不能只凭某个对象归某线程所有,就假定它拥有独立的位置策略。更大页面的收益与约束留给 S24 继续讨论。
内存压力还会让位置选择变得复杂。当目标节点空闲减少时,系统可能进行回收,部分策略允许转向其他节点,部分约束则会使分配更难满足。整机仍有空闲内存而局部任务发生分配问题,是值得检查节点约束的信号;它不是所有内存故障的统一解释。是否涉及交换、容器限额或进程自身错误,需要结合具体证据判断。
本课先建立边界清楚的模型:线程有执行位置,物理页有存放位置,设备有连接位置,策略影响这些位置如何配合。它已经足够解释许多扩容后变慢、绑核后仍慢、初始化改变性能的现象。S24 再把缺页、页表、回收和映射机制补齐,让你能从“数据远了”继续追问“这些页为什么会在这里”。
放进方案里
为 1 台双路服务器部署内存查询服务时,方案先写明硬件边界:每颗处理器启用 16 个物理核心、连接 128 GiB 内存,系统暴露 2 个 NUMA 节点,25 GbE 网卡接在节点 0 的 PCIe 路径下。CPU 编号以交付时读取的拓扑为准,并保存每节点容量、可用 CPU 集合与设备位置,作为迁移和扩容时的比较依据。
服务常驻索引为 48 GiB,查询线程计划运行在节点 0。启动流程先设置执行范围与内存优先策略,再由同节点的加载线程写入索引,随后完成预热。节点 0 还要容纳网络缓冲区、运行时开销与其他进程,因此部署前按峰值工作集核算余量;不能只用索引大小与节点总容量相减就宣布足够。
验收用同一份数据与固定并发比较原配置和候选配置,记录吞吐、p50、p99、进程内存在各节点的分布及节点剩余内存。只有页分布符合预期,而且业务指标在重复运行中稳定改善,才将候选配置作为默认值。报告保留内核版本、固件拓扑设置、自动 NUMA 平衡状态与预热方式,让结果具备复现条件。
本例可约定:预热后索引映射至少 95% 的驻留页位于节点 0,峰值负载下该节点可用内存不少于 16 GiB;以映射级页分布与节点内存采样留证,不能用整个进程的比例替代索引比例。连续 3 次独立启动均须满足约定的吞吐与 p99 目标,并加入另一节点同时扫描内存的竞争测试。上述比例与余量仅是本例验收线,索引规模或同机负载变化后必须重新核定。
容量增长时,先检查单节点余量,再评估增加另一节点的独立实例或拆分索引。若出现分配异常、尾延迟恶化或同机任务受挤压,恢复已验证的启动策略并复测。方案中的 NUMA 承诺应当是可观察的运行条件:谁执行、页在哪里、设备接在哪里、什么指标说明有效,以及什么条件触发重新规划。
10 小结:下一步内存管理深入(S24)
NUMA 让共享内存服务器能够通过多个内存控制器与节点继续扩展,也让访问代价具有位置差异。判断本地性要同时看执行核心与物理页,设备位置则帮助还原完整数据路径。绑核、内存策略和初始化顺序共同决定布局,最终收益由工作负载验证。
自测时可以尝试回答:为什么整机还有空闲内存,严格绑定的进程仍可能遇到分配问题?为什么线程迁到节点 1,旧数据没有立即变成本地?为什么距离矩阵的 21 不能解释为 21 ns?如果能用节点容量、首次触碰与相对距离分别回答,就可以进入 S24,继续学习虚拟地址如何映射到物理页,以及系统如何分配、回收和迁移内存。