为什么要约定表示法
在 H1 中,我们已经知道,比特只有2 种状态,二进制和十六进制可以用来书写位串。然而,看到一串比特,并不能立刻知道它表示什么。8 位的 11111111 可以表示无符号整数255,也可以表示有符号整数负一;放在另1 种格式里,它还可能是字符编码的一部分或设备状态的集合。比特保存的是区别,表示法才赋予这些区别以含义。
可以把表示法理解为发送方与接收方共同遵守的解释规则。规则至少要回答:用多少位,是否允许负数,小数点放在哪里,以及多个字节按什么顺序排列。只说“这里存着1 个数字”是不够的。同样一张纸上的数字,可能以米为单位,也可能以毫米为单位;计算机中的位串也需要这样的上下文。
本课从整数开始,再讨论小数与传输。整数便于观察每1 位的作用,也能清楚地展示有限空间带来的边界。学习时应始终区分3 层:数学上想表示的值、选定格式允许的值、实际保存的位串。这3 层有时能够一一对应,有时需要舍入,有时根本无法表示。许多看似偶然的程序错误,正发生在3 层之间的转换处。
例如,业务上允许的年龄通常非负,但这不意味着任何非负整数都能作为年龄。1 个8 位无符号字段在格式上允许零到255,业务上还应有更严格的范围。反过来,即使业务规则允许很大的累计次数,字段也可能先达到容量上限。表示规则与业务规则相互配合,不能用其中1 个替代另1 个。
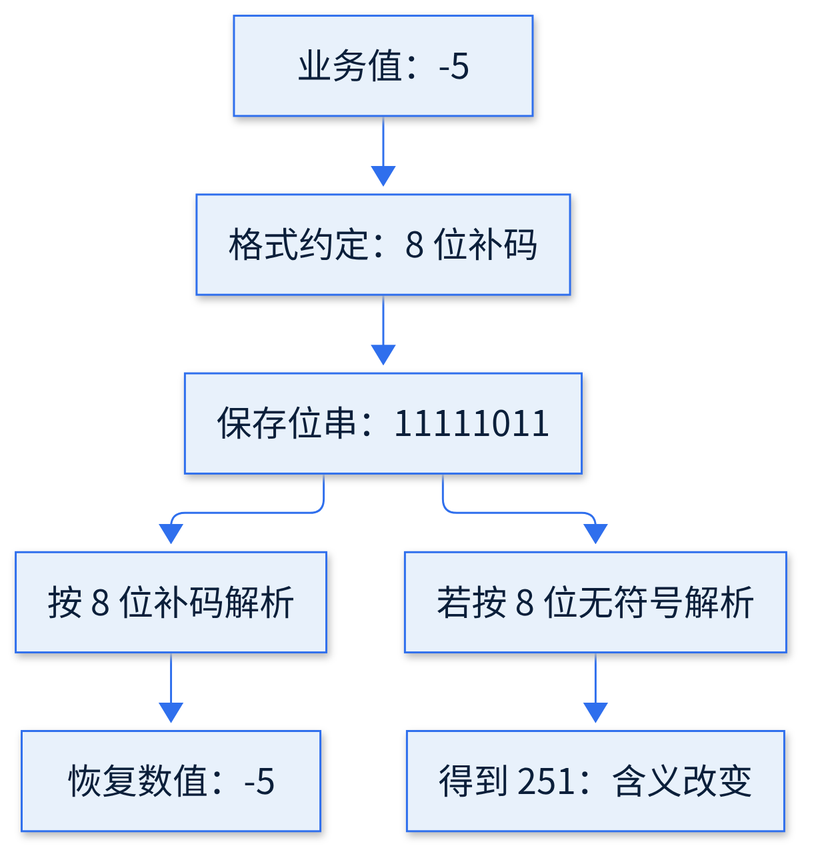
无符号整数与补码:同1 位串的2 种解释
无符号整数只表示零和正整数。每1 位都有非负的位权,从右向左依次是一、二、四、八,继续按二的幂增长。8 位能够组成256 种位串,因此范围是零到255。一般地,宽度为 n 位时,无符号范围是零到二的 n 次方减一。这里的减一来自零也要占用1 种状态,而不是少了1 种编码。
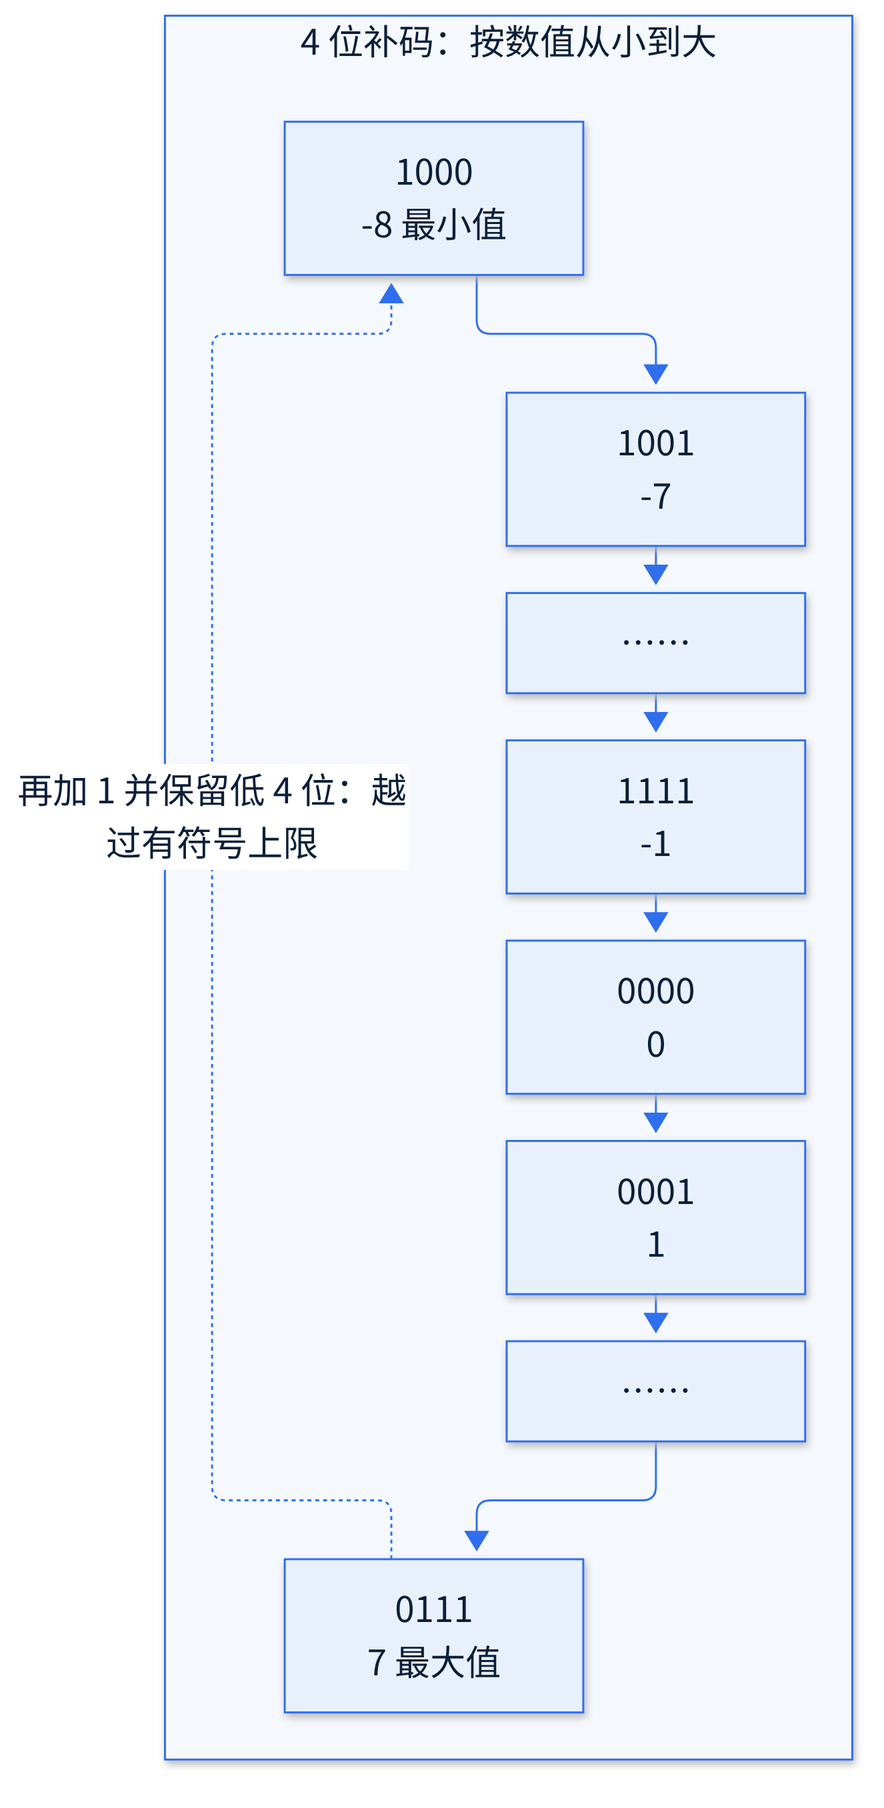
有符号整数还需要负数。如果简单地增加1 个符号,再为绝对值留出其余位,就会遇到正零和负零等问题。现代计算机处理固定宽度有符号整数时,普遍采用补码。补码把全部位串分成2 段:最高位为零的部分表示非负数,最高位为一的部分表示负数。最高位可以用来判断符号,但它并不是1 个与其他位完全分离的符号标签。
理解补码有1 个直接的方法:先把位串看作无符号值;如果最高位为一,就减去二的 n 次方。以8 位为例,11111111 的无符号值是255,减去256得到负一。10000000 的无符号值是128,减去256得到负128。于是8 位补码的范围是负128到127,负数比正数多1 个。
也可以从位权理解同1 规则。8 位补码的最高位权为负128,其余位仍是64、32直到一。11111111 就是负128加上127,结果为负一。2 种解释方法得到相同答案。前1 种适合检查位串,后1 种适合说明为什么最高位为一时整体仍可能有不同的负值。
把正五变成8 位的负五,可以先写出 00000101,逐位取反得到 11111010,再加一得到 11111011。这里的取反加一是1 种求相反数的编码方法,必须先约定宽度。若遗漏前导零,参与取反的位数就变了,得到的结果也会变。宽度始终是数值表示的一部分,不能在运算过程中悄悄省略。
补码的重要特点是:在固定宽度下,整数加法可以使用相同的逐位相加过程,再根据类型解释结果。例如,8 位的五与负五相加,完整和会出现第9 位进位;保留低8 位后得到全零。这里并不需要先把2 个操作数都变成绝对值再分别处理。相同的位级加法能服务于不同解释,这使补码成为常见的整数表示。
仍有1 个边界值得留意:8 位补码的最小值是负128,它的数学相反数是128,但后者不在8 位有符号范围内。因此,不能假定“对任意有符号整数取绝对值,结果总能放回原类型”。这个问题并非只出现在很小的整数类型里;无论位宽多大,最小负数都有同样的不对称性。
扩大位宽时也要保留解释。无符号值通常在高位补零;补码有符号值则复制原来的最高位,这称为符号扩展。8 位的负五扩成16 位时,高8 位应全为一。若误补零,原来代表负五的位串就会被解释成正251。符号扩展没有改变数值,只是增加了能够正确表达它的位数。
溢出与环绕:结果超出容器时
数学整数没有固定的最大值,固定宽度整数却有边界。运算的数学结果超出目标类型的范围,称为溢出。8 位无符号数255加一,数学结果是256,需要9 位。若只保留低8 位,结果变成零。这种越过末端又回到起点的行为称为环绕,可以用钟表走过12 点来帮助理解,但钟表的12 种状态在这里换成了256 种。
保留低 n 位,相当于按二的 n 次方取模。这个规则说明位串如何变化,却不自动规定某种编程语言在溢出时必须怎样执行。语言、类型和执行模式可能规定环绕、抛出异常,或要求程序避免这种情况。例如,C 的无符号整数运算按对应位宽取模;C 的有符号整数溢出属于未定义行为,不能把某次运行看到的环绕当作语言承诺。
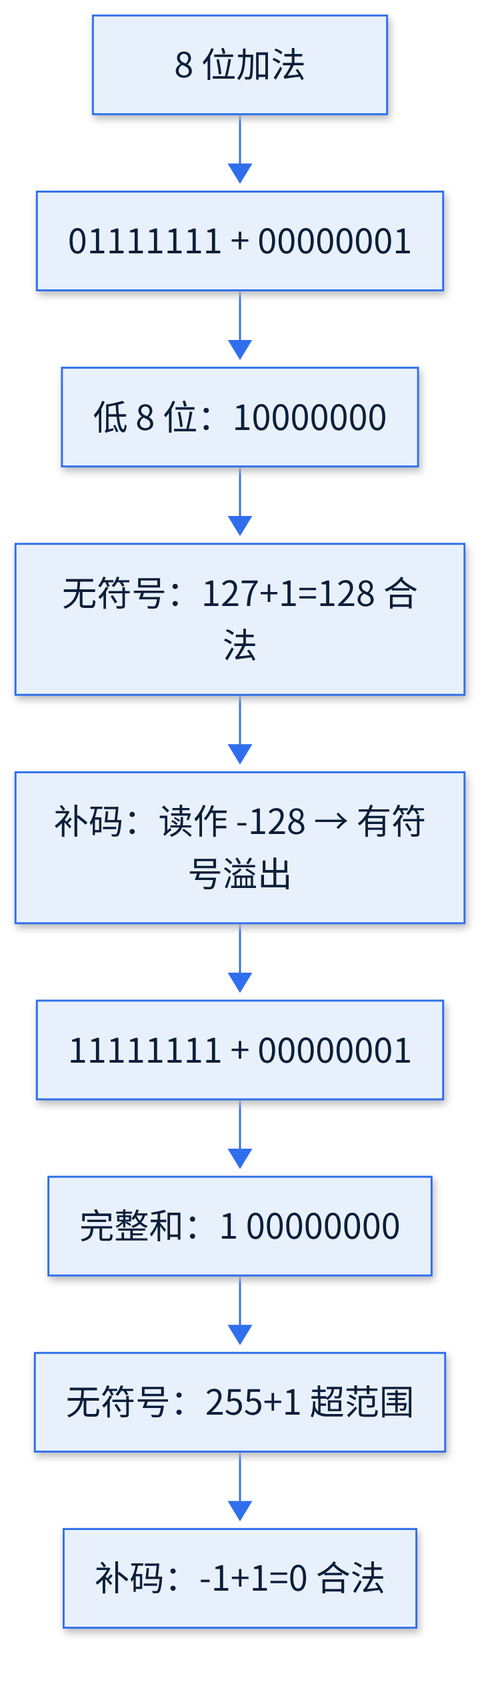
有符号数的边界与无符号数不同。8 位补码的127加一,保留低8 位后是 10000000,按补码读成负128。2 个正数相加却得到负数,提示结果已经超出有符号范围。但同一加法按无符号解释是127加一得到128,并未溢出。是否溢出必须结合类型判断,不能只看输出位串。
进位与有符号溢出也不是同一件事。8 位全一加一会产生向第9 位的进位;按补码解释,它其实是负一加一等于零,有符号结果完全合法。相反,127加一不需要第9 位进位,却已经超出8 位有符号范围。读程序日志或调试结果时,应先说清正在检查哪1 种范围。
实际程序应在溢出发生前决定策略。需要精确计数时,可以使用更宽的类型或任意精度整数;业务不允许超过上限时,可以先检查并拒绝;音量等有明确上下限的量有时使用饱和策略,超过上限就保留上限。环绕、饱和和报错代表不同的业务含义,不能把它们当作可以互换的实现细节。
检查过程本身也不能先发生溢出。对于非负数,如果上限为 M,判断 a 加 b 能否容纳,可以在确认 a、b 都处于合法范围后,检查 a 是否不大于 M 减 b。若先计算 a 加 b,再与 M 比较,溢出可能已经使比较失去意义。宽类型作为中间结果也有帮助,但必须确认运算确实在宽类型中进行,而不是算完以后才转换。
字节序:多个字节怎样排进内存
1 个字节通常是8 位。8 位整数只占1 个字节,不存在字节之间的先后问题;16 位、32 位或更宽的数则需要多个字节。约定的是:1 个多字节数值的高位字节和低位字节,分别存放在什么地址。它描述字节的排列,不改变数值本身,也不等同于把每个字节内部的比特倒过来。
以32 位数 0x12345678 为例,4 个字节分别是 12、34、56、78。这些都是十六进制写法。若最低地址存放 12,随后依次存放 34、56、78,称为大端序;若最低地址存放 78,随后是 56、34、12,称为小端序。高位与低位描述数值中的权重,高地址与低地址描述存储位置,2 组概念应分开。
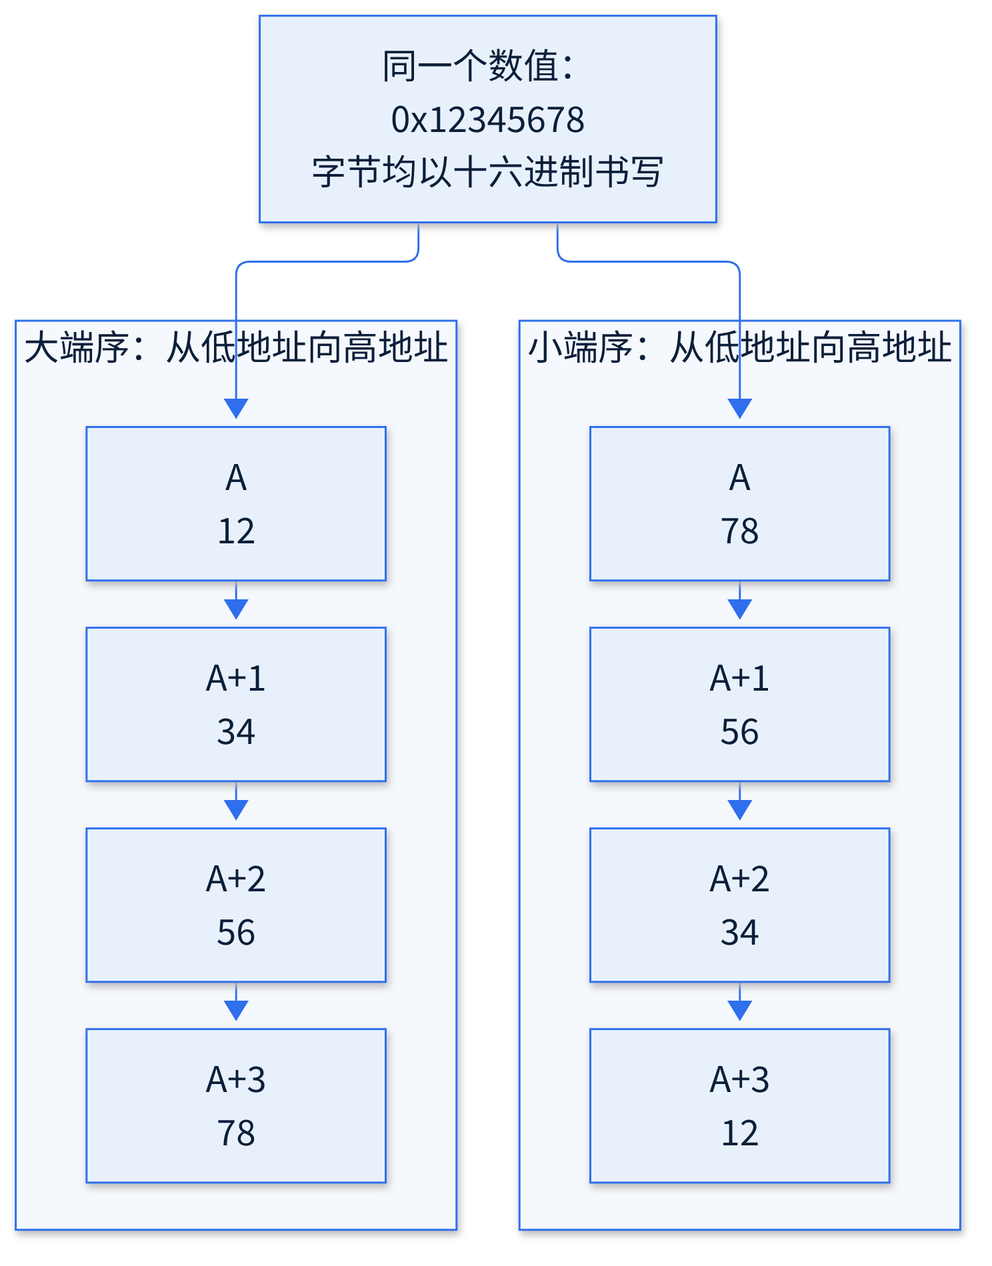
单台机器上的程序常由运行环境处理本机类型的装载,因此平时不必手动安排每个字节。但一旦把内存内容写入文件、发送给另1 台机器,或交给另1 种语言读取,双方就必须共享明确的格式。网络协议常把大端序称为网络字节序,但这不意味着所有网络应用格式都只能选大端。应以具体协议为准,并在编码与解码时显式指定。
判断字节序错误时,可以挑选各字节不同的测试值。例如,0x00000000 和 0xFFFFFFFF 无论如何排列都一样,不适合暴露错误;0x12345678 更容易观察。读取后若变成 0x78563412,通常应检查字节顺序是否颠倒。但如果偏移位置或字段宽度读错,也可能产生异常值,不能仅凭1 个结果就断定原因。
字节序只解决1 层问题。即使双方都使用大端序,若一方把字段看作无符号数,另一方看作补码有符号数,仍可能把很大的正数读成负数。若一方以秒计时,另一方以毫秒计时,字节排列完全正确也会得到错误的业务含义。可靠格式需要同时约定位宽、符号、字节序、单位和允许范围。
读取硬件寄存器时,还要区分寄存器宽度与有效数据宽度。假设1 个模数转换器把12 位无符号采样值右对齐放在16 位寄存器中,高4 位是状态标志,低12 位才是测量结果。若设备规定低字节先读,读到的2 个字节为 BC A5,先按小端组合得到 0xA5BC,再与 0x0FFF 按位与,才能取出原始采样码 0x05BC,即1468。直接把整个16 位值当作采样结果,会把状态标志混入幅值;先交换字节再随意截取,也可能截掉真正的数据位。应按寄存器说明依次完成字节组合、字段提取和数值解释。
若低12 位保存的是补码,符号位就在第11 位,位编号从0开始,并不在16 位容器的最高位。提取后若该位为1,应减去4096,再扩展到程序使用的整数类型。例如低12 位全为1时,无符号解释为4095,12 位补码解释为-1。直接将 0x0FFF 转成16 位有符号整数仍是4095,因为转换并不知道实际字段只有12 位。状态位、保留位和符号位各有位置,不能用容器类型代替字段定义。
字节顺序正确,也不保证多个字节来自同1 次采样。假设16 位计数器由2 个8 位寄存器组成,软件先读低字节,再读高字节。若读低字节时计数为 0x12FF,随后计数变为 0x1300,拼接旧低字节 FF 与新高字节 13 就得到 0x13FF。这个值在2 次读取期间根本没有出现。设备若提供快照或读取锁存,应按规定顺序使用;对于允许重复读取且没有读取副作用的递增计数器,也可在满足更新速率约束时采用“高、低、高”读取,前后高字节不一致就重试。不能把普通内存的读取习惯直接套到所有外设。
排查这类问题时,应保存原始字节、寄存器地址、读取顺序和对应状态,而不只记录最终十进制值。固定输入下始终颠倒,通常指向排列或解析规则;只在低字节进位附近偶发跳变,则应检查读取一致性。串行总线规定的每字节先传哪1 位,也应与多字节数的字节序分别核对,它们是不同层面的顺序约定。
定点数:把小数点的位置固定下来
整数也能表示带小数的量。假设温度以百分之一摄氏度为单位保存,整数2345就代表23.45摄氏度;整数负50代表零下0.5摄氏度。底层仍保存整数,但解释时要应用1 个固定比例。这种思路称为定点表示,小数点的位置由双方提前约定,不需要跟随每个值单独保存。
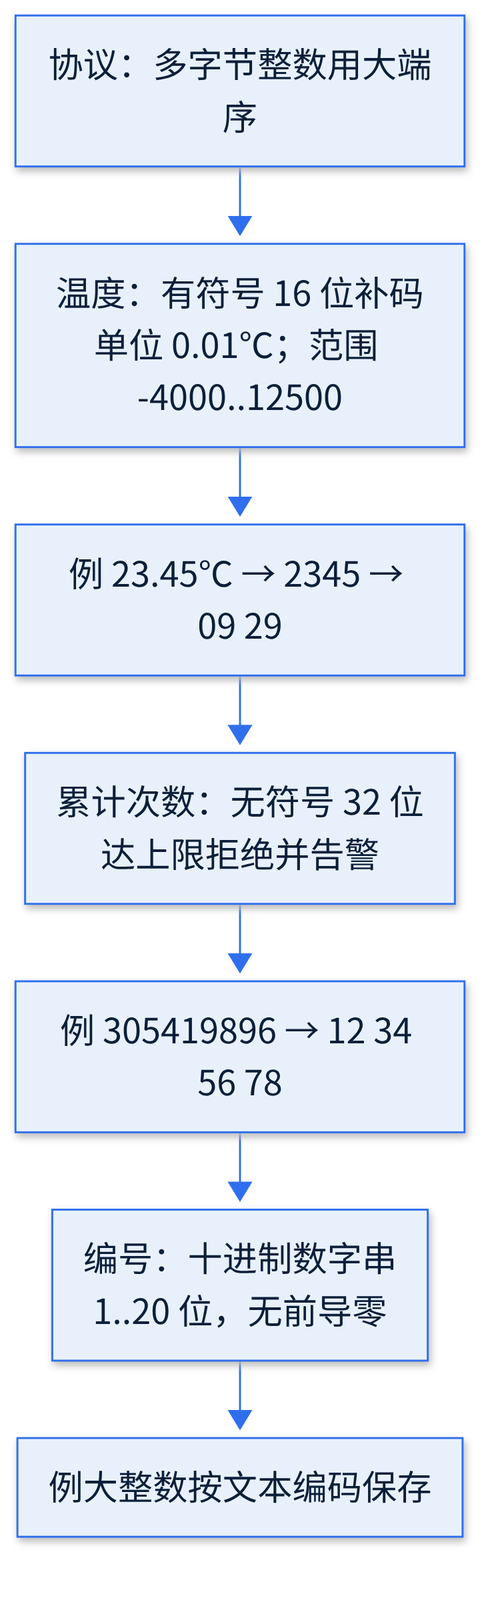
把上述温度编码成16 位补码,可以逐步核对:23.45乘以100得到整数2345,转成十六进制为 0x0929,完整位串是 00001001 00101001。左侧为高8 位,右侧为低8 位,最高位为零表示非负;空格只用于分组,位串中并没有保存小数点。解码时先按补码读出2345,再除以100,恢复23.45。若接收端误用十分之一的比例,同一位串就会被读成234.5,数值放大十倍。即使位宽、符号和字节序全部一致,缩放比例不一致仍会出错,因此协议还须明确每个整数单位对应多少摄氏度。
金额常以分为单位记录,也是相同思路。两笔金额分别保存为十和20,整数相加得到30,解释为30分,能够避开十进制的0.1在二进制浮点中不能精确表示的问题。不过,定点数不是自动正确的金额系统。不同货币可能有不同的最小单位,利率计算也可能产生不足一分的结果,必须继续约定舍入规则。
比例越细,同样位宽能够覆盖的实际范围就越小。1 个有符号16 位整数若直接计量整摄氏度,范围很大;若计量百分之一摄氏度,最小步长更细,但正向上限只有327.67摄氏度。固定容量需要在范围与分辨率之间分配,不能同时无限提高两者。业务选型应先确认最大最小值和所需步长,再选择位宽。
定点运算还要注意单位。2 个以分表示的金额可以相加,但金额乘以比例时,中间结果可能携带更大的缩放因子。例如,2 个都按100分之一保存的数相乘,整数乘积对应的比例变成万分之一。恢复目标比例时需要除法与舍入,中间乘积还可能先溢出。设计时应把每1 步的单位和缩放写清,而不是只在输入输出时加上小数点。
浮点数:在范围与精度之间分配位数
当数值跨越很大范围时,固定的小数点位置未必合适。科学计数法会把1 个数写成有效数字乘以某个数量级;浮点数也采用类似思想,只是常见格式以二为基础。小数点的位置能够随指数变化,因此称为浮点。它适合表示测量值、比例和科学计算中的近似数,但有限位数仍然无法容纳所有实数。
IEEE 754 是常用的浮点运算标准。常见的 binary32 占32 位,由1 位符号、8 位指数和23 位尾数字段构成;binary64 占64 位,对应1 位符号、11 位指数和52 位尾数字段。尾数字段保存有效数字的一部分。对通常的正规数,还隐含1 个前导的一,因此有效二进制位数分别为24 位与53 位。
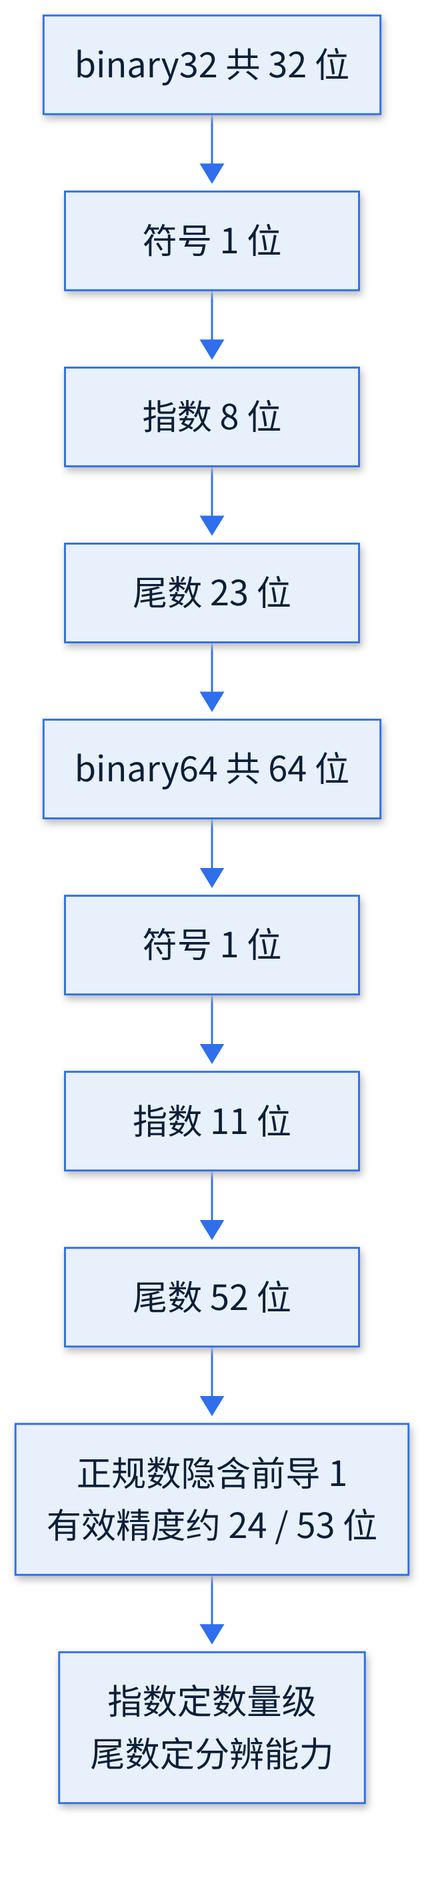
符号决定正负,指数主要决定数量级,有效数字主要决定在该数量级附近能分辨多细。binary64 相比 binary32,既扩大了范围,也增加了有效精度。有效精度不是“小数点后永远准确若干位”。数越大,相邻可表示值的距离通常也越大;某个数附近能够分辨一,到了更大数量级,可能只能分辨二、四或更大的步长。
十进制的0.5等于二分之一,可以用有限的二进制小数精确表示;0.1的二进制展开则无限循环。有限尾数字段只能保存其近似值。因此,常见 binary64 运算中,0.1加0.2的结果可能显示为 0.30000000000000004。这不是加法器随意算错,而是输入已经近似,运算结果又需要舍入。
理解误差时,应区分格式中的实际值与显示出来的文本。屏幕显示 0.1,并不证明内部保存了数学上精确的十分之一。有些输出方式会选取较短、又能读回相同浮点值的十进制文本;显示更多位时才会看到差异。反过来,把显示位数截短也只是改变呈现方式,不会自动修复后续运算使用的内部值。
浮点加法不总能满足数学实数中的结合律。先把很大的数与很小的数相加,小量可能小于当前间距而被舍掉,之后再减去大数也无法恢复它;调整运算顺序则可能得到不同结果。统计求和时,大量微小误差还会积累。需要更准确的累计结果时,应考虑合适的算法、精度和误差分析,不能只依靠增加打印的小数位。
IEEE 754 还定义了正负零、无穷大和非数值 NaN 等特殊值。NaN 可用于表示无效数值结果,它甚至不与自身相等,判断时应使用语言提供的专门方法。有些环境会对除零直接报错,有些浮点接口会产生无穷大,因此应区分格式能表达什么与接口选择如何处理错误。特殊值进入日志、排序或数据交换前,也需要明确策略。
浮点比较不能一概改成“差小于1 个固定常数”。接近零的数常需要绝对误差界,数量级很大的数常需要相对误差界,两者可以结合使用。容差应来自测量误差或业务允许的偏差,而不是随意挑1 个很小的数字。对于必须精确相等的编号、计数和金额最小单位,应优先选择适合精确表达的类型。
命令与示例:让约定成为可见结果
下面的 Python 示例只使用标准库,展示相同位串如何因解释不同而改变。bytes 中的元素是零到255的字节值,int.from_bytes 把字节序列解释成整数。对于1 个字节,字节序没有实际影响,但有无符号仍有区别。随后使用4 个字节,才会看到大端与小端解释的差别。
raw = bytes.fromhex("ff")
print(int.from_bytes(raw, byteorder="big", signed=False))  # 255
print(int.from_bytes(raw, byteorder="big", signed=True))   # -1

raw = bytes.fromhex("12 34 56 78")
print(hex(int.from_bytes(raw, byteorder="big")))     # 0x12345678
print(hex(int.from_bytes(raw, byteorder="little")))  # 0x78563412
这里没有修改字节序列,改变的只是解释参数。若要把整数编码回字节,可以使用 to_bytes 并显式给出长度与字节序。例如,下面的300无法放入1 个无符号字节,Python 会报告 OverflowError。这种拒绝有助于暴露格式容量不足;若业务需要环绕,应把规则明确写出来,不能假定编码接口会自动截断。
value = 300
print(value.to_bytes(2, byteorder="big", signed=False).hex())  # 012c
try:
    value.to_bytes(1, byteorder="big", signed=False)
except OverflowError:
    print("数值超出 1 个无符号字节的范围")

print((255 + 1) & 0xff)  # 0:显式只保留低 8 位
print(0.1 + 0.2)        # 0.30000000000000004
普通 Python 整数会随数值增长,不会因为超过255就自动变成零;示例中的按位与掩码才模拟了只保留低8 位的行为。不能把某1 种语言的整数表现直接套到另1 种语言中。读取外部格式时,即使语言本身支持很大的整数,也仍要检查协议允许的位宽与范围。
若输入是精确的十进制文本,可以选择十进制数值类型来保留其十进制含义。下面从字符串构造 Decimal,避免先引入二进制浮点近似。十进制类型同样有精度与舍入规则,并不代表任意运算都能无限精确;例如除以三仍可能需要舍入。类型选择应服务于数据含义。
from decimal import Decimal

amount = Decimal("0.1") + Decimal("0.2")
print(amount)  # 0.3
常见坑与案例:错误通常发生在边界
第2 个坑是转换时悄悄改变含义。把负一转成某个无符号类型,在某些语言或接口中会得到该类型的最大值,在另一些接口中则会被拒绝。若随后把这个值用于长度、偏移或申请空间,后果可能远超1 个显示错误。输入阶段应先验证数值含义,再执行类型转换,不能期待转换自动替业务作出判断。
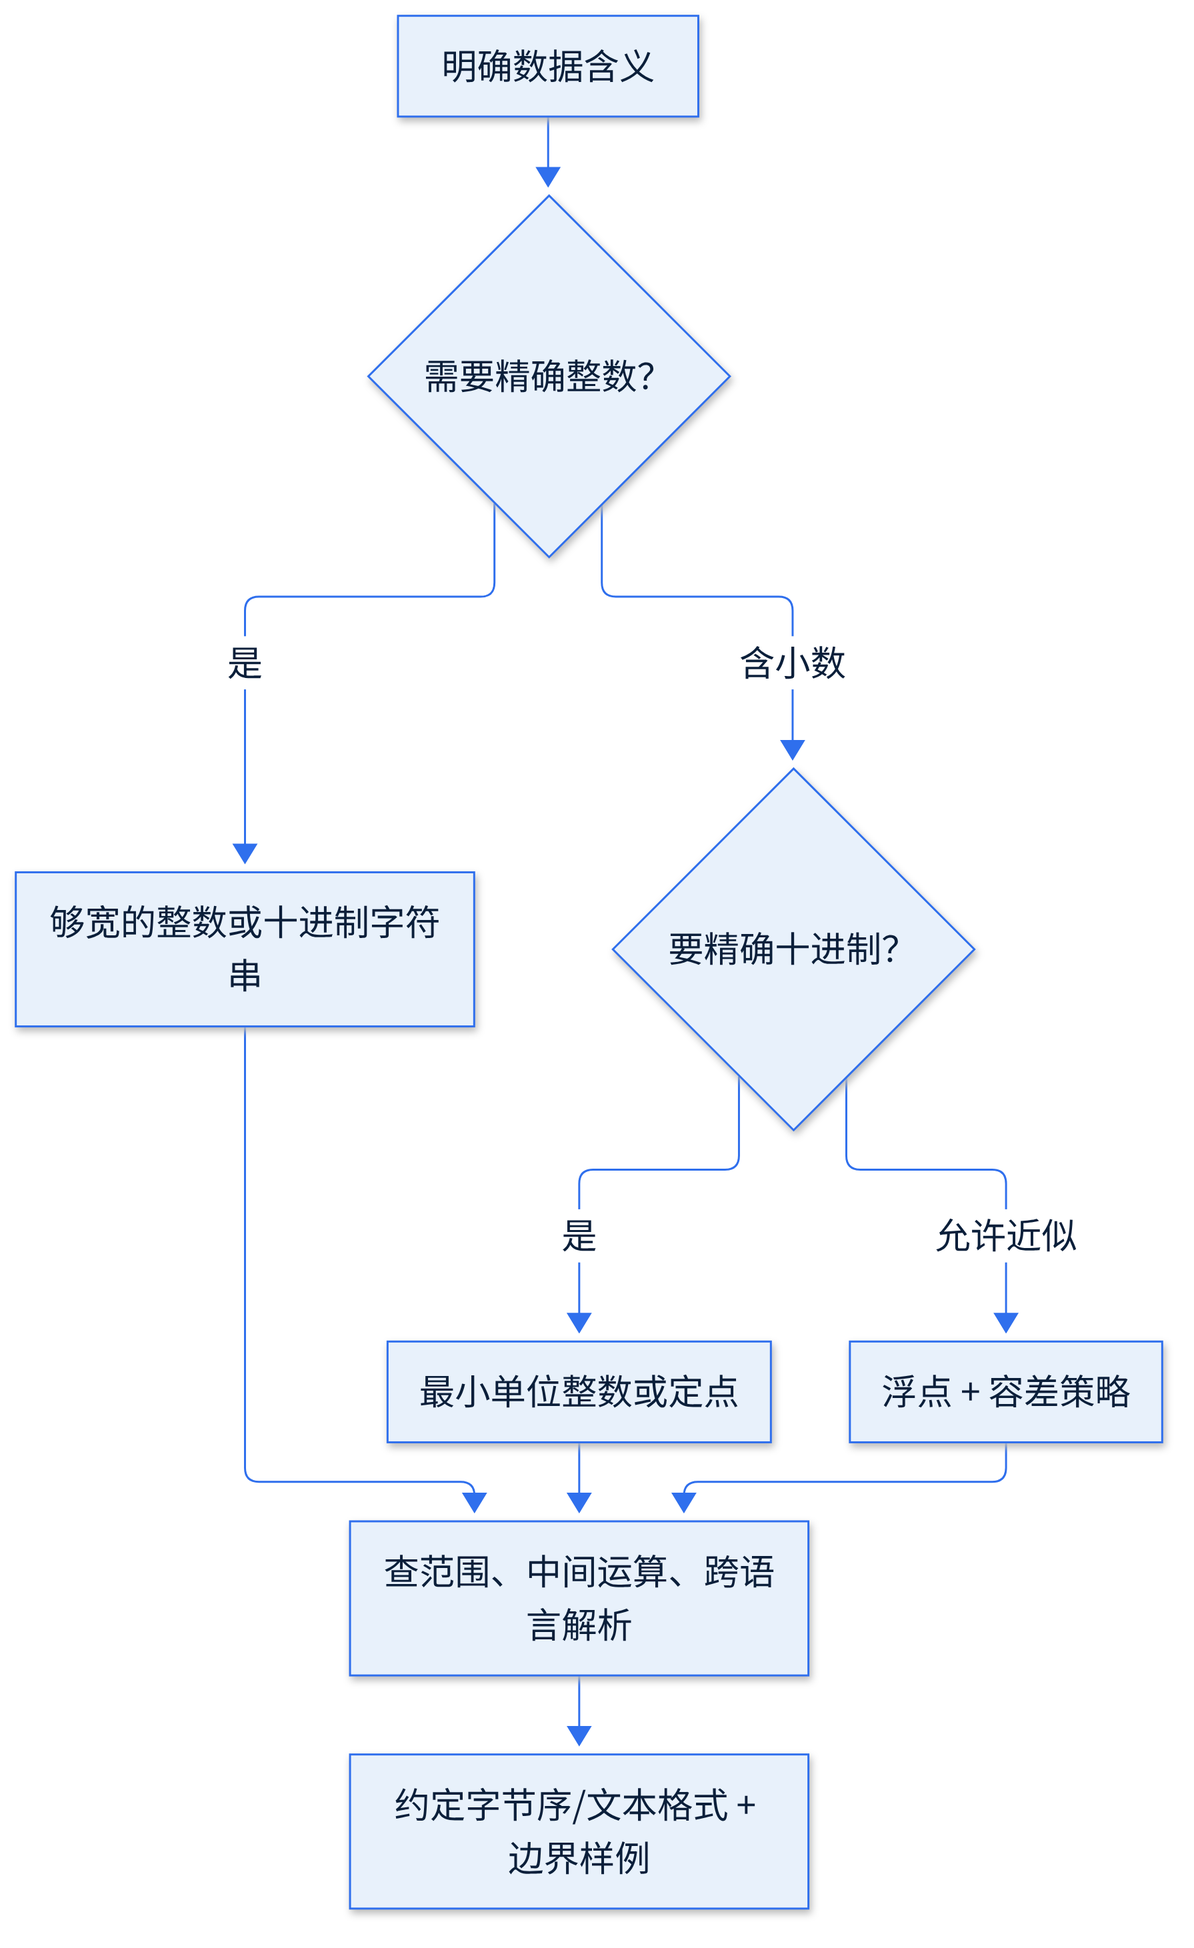
第3 个坑是把宽整数经过浮点中转。常见 binary64 能连续精确表示到2 的53 次方,超过这个边界后,相邻整数不再都能区分。在常见 JavaScript Number 中,安全整数范围的正向上限是2 的53 次方减一。大型编号从精确整数转换成此类数值后可能被舍入,之后再转回整数或字符串也无法找回丢失的位。
设想1 个设备上传累计次数:设备用无符号16 位保存,服务端用有符号16 位解析。在计数较小时,双方结果一致,测试很容易通过;一旦计数达到32768,服务端开始读出负数。如果计数器还继续增加,到65535后又可能按设备规则归零。这包含符号误读和计数环绕2 个独立问题,需要分别修复。
正确的接收逻辑首先按协议解析无符号字段,再根据计数器规则解释变化。如果协议允许环绕,在确认最多只跨过1 次边界且设备未重置等条件下,才可按模计算2 次读数之差。若采样间隔过长,可能跨过多个周期;若设备重启,归零也可能只是重置。单靠2 个读数无法恢复这些信息,应增加重启标识、时间信息或扩大计数范围。
另1 个案例是结算服务把单价和数量相乘。单价以分保存能够精确表达最小货币单位,但较大订单仍可能使乘积超出类型范围。若折扣以比例参与计算,还需要规定先折扣后汇总还是先汇总后折扣,以及在哪1 步舍入。2 种流程都可能在各自规则下自洽,却得到不同的最终分数。数据表示规则必须与结算规则一起记录。
跨语言交换也容易隐藏不一致。一端的整数类型可能有固定宽度,另一端可以任意增长;一端把十进制文本解析为精确整数,另一端先解析成浮点数。接口只写“数字”会掩盖这些差异。对于大编号,可以按约定传十进制字符串,并要求接收端以精确整数或字符串处理;这种选择需要连同排序、长度和格式校验一起说明。
放进方案里
容量选择要给增长留出依据。根据最大速率、预期运行时间和重置周期估计累计值,再确认中间运算能否容纳结果。对接近上限的字段,应规定拒绝、扩容、饱和或环绕中的具体策略,并安排可识别的异常处理。不能只因当前样本很小,就把很窄的字段当作长期格式。
跨语言接口应说明哪些整数必须精确、哪些小数允许近似。如果接收方可能通过浮点数处理宽整数,就应选择明确的字符串编码或双方支持的精确整数方案。十进制金额可以用最小单位整数或约定的十进制文本,同时写明小数位、舍入时机与舍入方式。采用浮点字段时,还应说明容差与特殊值是否允许。
格式文档需要配套具体字节样例。至少覆盖零、最小值、最大值、负数和超范围输入,并使用各字节不同的数检查字节序。样例应同时列出业务值、编码字节与预期解析结果,让不同语言的实现能够核对同一事实。解码后仍要执行业务范围校验,格式合法并不意味着业务合法。
最后考虑演进。扩大字段宽度或改变缩放比例会改变解释规则,应通过版本或明确的新字段识别,不能让旧接收端继续猜测。方案评审应能沿着“业务值、编码、传输、解析、使用”走完1 条链,确认每次转换都有唯一且可检验的含义。
小结:从表示走向 H6
本课的核心是把值、格式与位串区分开来。无符号整数把全部状态分配给非负数,补码把状态分配给正负2 个方向;位宽限定范围,超出范围后的处理需要明确规则。字节序约定多字节数的排列,却不能替代符号、单位和字段宽度。定点表示固定比例,浮点表示用有限有效数字覆盖更广范围,两者都需要认真处理边界。
判断1 个数值问题时,可以沿着固定顺序梳理:先确认原始数据想表达什么,再确认允许范围和精度,随后检查编码和解析规则,最后检查运算的中间结果。这样能够把符号误读、字节颠倒、整数溢出和浮点舍入区分开,避免只在显示结果上修补。
在后续 H6 中,我们会把这些表示规则放回计算机整体,认识 CPU、内存与外设分别承担的工作。位串会被保存、搬运和处理,但它们代表数值、文字还是指令,仍依赖上下文与约定。理解数据表示,是继续理解计算机如何执行程序的基础。
下一课转向 H6 计算机组成概览:把本章验收过的结论带进后续主题,写成可检查的方案约束。