从1 条消息到一串比特
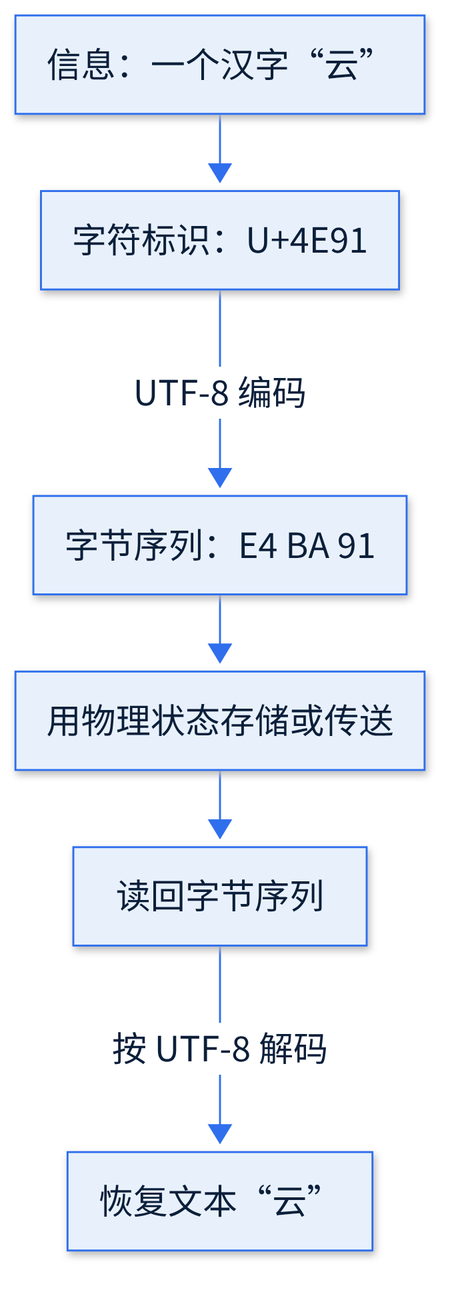
在手机上输入“云”,屏幕会显示1 个汉字;把它发送给朋友,网络设备转发的是信号;保存到文件后,存储设备记录的又是某种物理状态。同1 条信息能够跨越屏幕、网络和磁盘,是因为这些设备遵守了共同的表示规则。本课从这些规则出发,建立比特、进制、字符编码与容量单位之间的联系,并据此解释乱码、日志转义和容量差异。
信息本身与承载信息的形式需要分开。例如,“今天下雨”可以写在纸上,也可以用声音说出,内容相近,载体却不同。计算机处理文字、照片和声音时,先把它们表示成可区分的符号,再把符号落实为设备能够保存或传送的状态。所谓数字化,就是用离散的数值表示信息。对声音这类连续变化的对象,还需要采样和量化;采样是否足够密、量化是否足够细,会影响还原效果。本课只讨论得到离散数据之后的表示,不展开音视频采样理论。
比特,英文 bit,是二进制数位的名称,可以取零或一,共 2 个值。硬件不一定真的保存1 个印刷的“零”或“一”,而是用电压范围、电荷状态等可区分的物理状态代表它们。接收方把一定范围内的信号判作同1 个值,能够容忍一定扰动;如果扰动超过范围,仍然可能发生错误。数字表示使复制、校验和自动处理更容易,但不能自动保证内容真实,也不能保证设备永不出错。
1 个比特只能区分2 种情况,2 个比特有4 种组合,3 个比特有8 种组合。一般地,固定长度的 n 个比特共有二的 n 次方种组合。8 个比特能够区分256 种模式,通常组成1 个字节,记作 B。字节是文件大小和内存容量的常用计量基础。8 位无符号整数可以表示从零到255;若换用其他解释,同样8 位也能表示字符片段、颜色分量或控制标记。
组合数量说明的是表示空间,不等于已经知道了多少有用信息。例如,8 位字段即使允许256 种模式,某个协议也可能只定义其中几个值,其余值保留不用。若要给5 种状态分别分配固定长度且互不相同的编号,2 位只有4 种组合,不够使用,3 位有8 种组合才足够。设计字段时既要计算当前需求,也要明确未使用组合的含义,避免接收方各自猜测。
因此,看到一串比特,首先要确认解释规则。字节 41 如果按十六进制书写,其数值为十进制65;按 ASCII 解释,则是字母 A。如果把它看作图像中的1 个亮度分量,又会得到另1 层含义。数据并不随身携带所有解释规则,文件格式、协议和程序约定补上了这些信息。排查问题时,应该同时追问“实际字节是什么”和“谁按什么规则解释了它”。
进制决定写法,位权决定数值
十进制使用零到九,共 10 个数字,某1 位满十就向高位进一。二进制使用零和一,满二进一;八进制使用零到七,十六进制使用零到九以及字母 A 到 F,其中 A 到 F 分别代表十到15。字母大小写不影响十六进制数值。进制改变的是书写方式,同1 个数量不会因为换1 种写法而增大或缩小。
位权是某1 位置代表的单位大小。十进制 347 等于3 个百、4 个十和7 个一。以底数 b 表示的整数,从最右边开始,各位的位权依次为 b 的零次方、1 次方、2 次方。某位数字乘该位位权,再把各项相加,就得到这个数的值。最右位权为一,因为任何非零底数的零次方都是一。读二进制时,也应该沿用这个熟悉的展开方法。
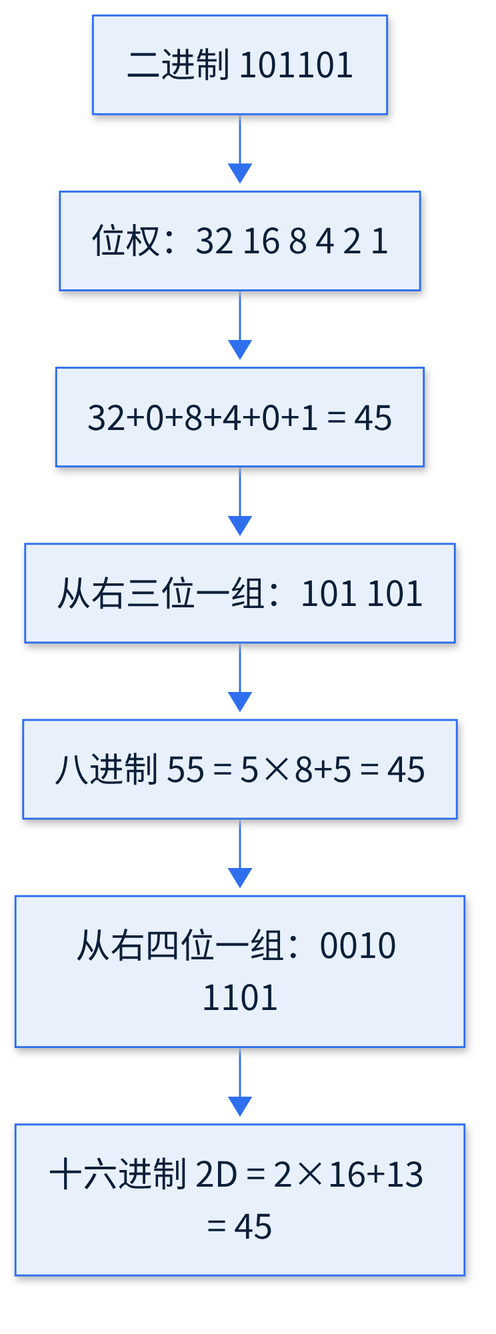
例如,二进制 101101 从右往左的位权是 一、二、四、八、16、32。取值为一的位分别贡献32、八、四和一,相加得到十进制45。中间的零仍然占位,说明对应位权没有贡献。不能删掉内部的零,否则其左侧各位的位置随之改变。对于普通无符号整数,添加前导零不改变数值,但固定字段的长度仍可能是协议要求的一部分。
把十进制整数转换为二进制,可以反复除以二,记录每次余数,最后逆序读出。45除以二,商22余一;22除以二,商11余零;随后得到商五余一、商二余一、商一余零、商零余一。余数按产生顺序是 1、0、1、1、0、1,逆序排列得到 101101。必须逆序,是因为第1 次除法取出的余数属于最低位。
八进制和十六进制与二进制之间有方便的分组关系。2 的3 次方等于八,所以每3 个二进制位对应1 个八进制位;2 的4 次方等于16,所以每4 个二进制位对应1 个十六进制位。转换整数时,从右向左分组,最左组不足时在左侧补零。101101 分为 101 101,得到八进制 55;分为 0010 1101,得到十六进制 2D。补零只是帮助分组,不会改变整数值。
反过来,十六进制 2D 可以逐位展开为 0010 1101,去掉无须保留的前导零便回到原二进制数。用位权复核,二乘16加13等于45。八进制 55 则是五乘八加五,也等于45。实际工作常用十六进制查看字节,因为1 个字节恰好对应2 位十六进制数,既紧凑,又能方便地还原每个比特。
转换之后还可以做数量级检查。6 位二进制非负整数的最大值是63,因此本例的45在范围之内;2 位十六进制可以覆盖零到255,不能因此断定原始字段就一定有8 位。为了展示而补齐的宽度,与协议实际分配的宽度是两回事。阅读抓包或文件格式时,必须由格式说明确定字段长度,不能只靠数字的外观推断。
书写时要明确底数,避免把 10 当成1 个脱离上下文的数值。0b101101 常表示二进制,0o55 常表示八进制,0x2D 常表示十六进制;这些是程序语言或工具的约定,并非所有输入框都支持。尤其不要假设前导零总是装饰:某些语言或命令会把它当作八进制提示。本课的换算均限于非负整数,小数、负数和溢出规则将在后续数据表示课程中展开。
字符、码点和字节是3 个层次
计算机要交换文字,必须约定字符与数字的对应关系。ASCII 是较早广泛使用的1 种字符编码,用7 位表示128 个位置,包含英文字母、数字、标点和部分控制字符。例如大写 A 的值为十进制65,即十六进制 41;换行控制字符 LF 的值为十六进制 0A。ASCII 不能单独表示汉字,也不能覆盖现代文字交换的全部需要。
Unicode 为各类文字与符号分配,以便建立共同的字符标识体系。码点通常写作 U+ 加十六进制数字,例如“云”的码点是 U+4E91。这个写法说明它在 Unicode 体系中的编号,却没有直接规定文件中要写几个字节。把 Unicode 说成“一律2 个字节”会混淆编号体系和具体编码方式。
是把 Unicode 标量值编码为字节序列的1 种方案;标量值指排除代理码点范围后的 Unicode 码点。有效的 UTF-8 编码使用一到4 个字节,ASCII 范围使用1 个字节,并保持原有字节值。“云”需要3 个字节,某些表情符号中的单个码点需要4 个字节。由此可见,“字符数”和“字节数”不能混用,所需空间取决于具体内容与编码规则。
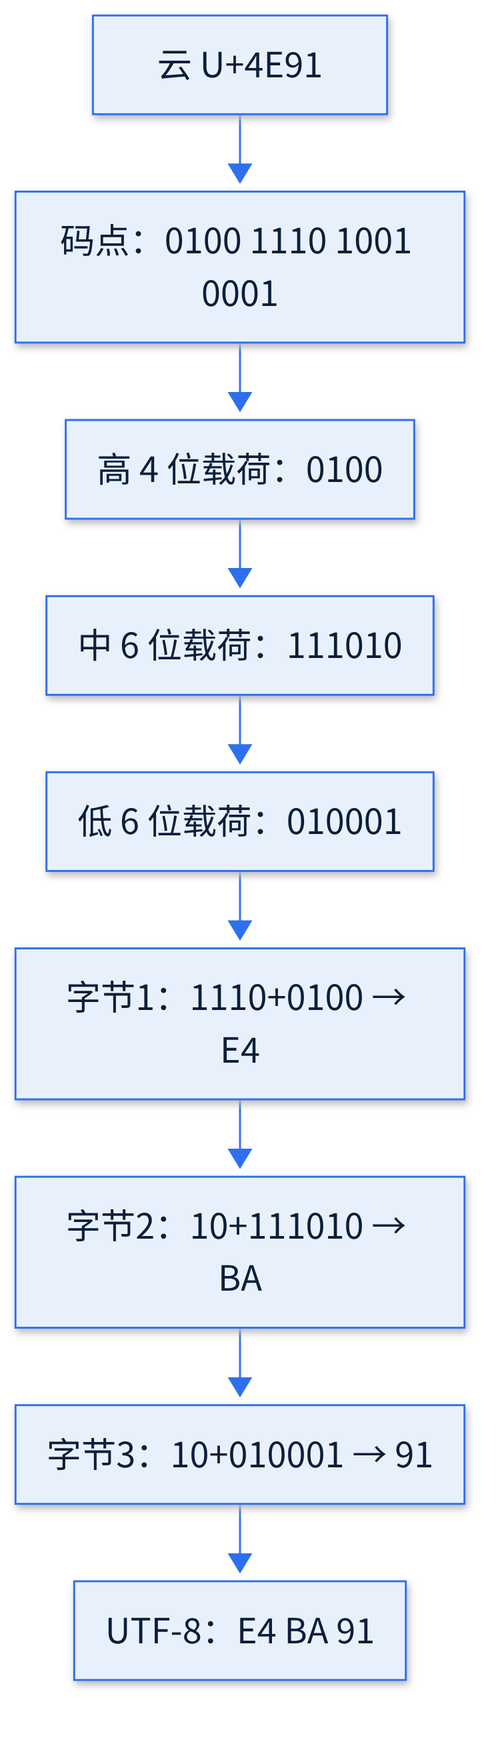
UTF-8 的首字节用特定前缀指示长度,后续字节都以二进制 10 开头。单字节形式是 0xxxxxxx;双字节形式是 110xxxxx 10xxxxxx;3 字节形式是 1110xxxx 10xxxxxx 10xxxxxx;4 字节形式是 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx。其中 x 是承载码点信息的位置。前缀提供结构信息,不能把所有位都当作正文载荷。
以“云”为例,4E91 对应16 位二进制 0100 1110 1001 0001。3 字节模板的载荷位数为四加六加六,因此从高到低分成 0100、111010、010001。分别加上前缀,得到 11100100、10111010、10010001,转换成十六进制就是 E4 BA 91。这3 个字节合起来编码1 个码点,不能拆成3 个独立字符来解码。
模板便于理解,但实现解码器不能只检查前缀。有效性规则还要求使用最短编码,拒绝代理码点、超出 Unicode 范围的值以及缺失或不合法的后续字节。业务开发通常应调用成熟的编码库,并在读入边界明确错误处理策略。遇到非法序列时,静默忽略会丢失数据;替换为特殊符号可以继续显示,却可能掩盖问题,应结合业务目标选择。
还应区分编码转换与内容规范化。把同一文本从 UTF-8 转为另1 种编码,再转回来,目标是保留它的字符内容;Unicode 规范化则按规定处理某些等价的码点序列。外观相同的2 段文本未必具有相同字节,直接比较字节可能判为不同。涉及搜索或标识符比较时,应另外约定是否规范化,不能期待 UTF-8 编码过程自动完成这件事。
用户眼中的1 个字符,也未必对应1 个码点。某些重音字母可以由基本字母与组合符号组成,1 个表情也可能包含多个码点。界面上限制“最多10 个字”,必须说明按字节、码点还是用户感知的字形簇计数。编码规范解决如何表示,字体负责如何绘制;方框可能来自缺少字体,不能仅凭显示异常就断定编码错误。
容量和传输速率要带着单位计算
bit 的符号是小写 b,字节 byte 的符号是大写 B,二者相差八倍。网络速率常以 bit/s 表示,文件大小常以 B 表示。理想情况下,80 Mbit/s 等于每秒十 MB;真实文件传输还受到协议开销、拥塞、设备读写等因素影响。把标称速率直接当成下载界面的字节速率,会产生八倍量级的误解。
十进制前缀按1000递增:一 kB 是1000 B,1 MB 是 1000000 B,1 GB 是十亿 B,1 TB 是1 万亿 B。严格符号中 kilo 写小写 k,日常产品也经常把千字节写作 KB。本课提到 KB 时,都要求同时说明其定义,不能仅凭大小写猜测厂商或程序采用哪1 种计算方式。
二进制前缀按1024递增:1 KiB 是1024 B,1 MiB 是1024 KiB,1 GiB 是1024 MiB,1 TiB 是1024 GiB。IEC 采用这些前缀来区分二进制倍数,NIST 的单位说明也强调2 类前缀的差别。写清 B 的数量,是消除单位歧义最直接的办法。
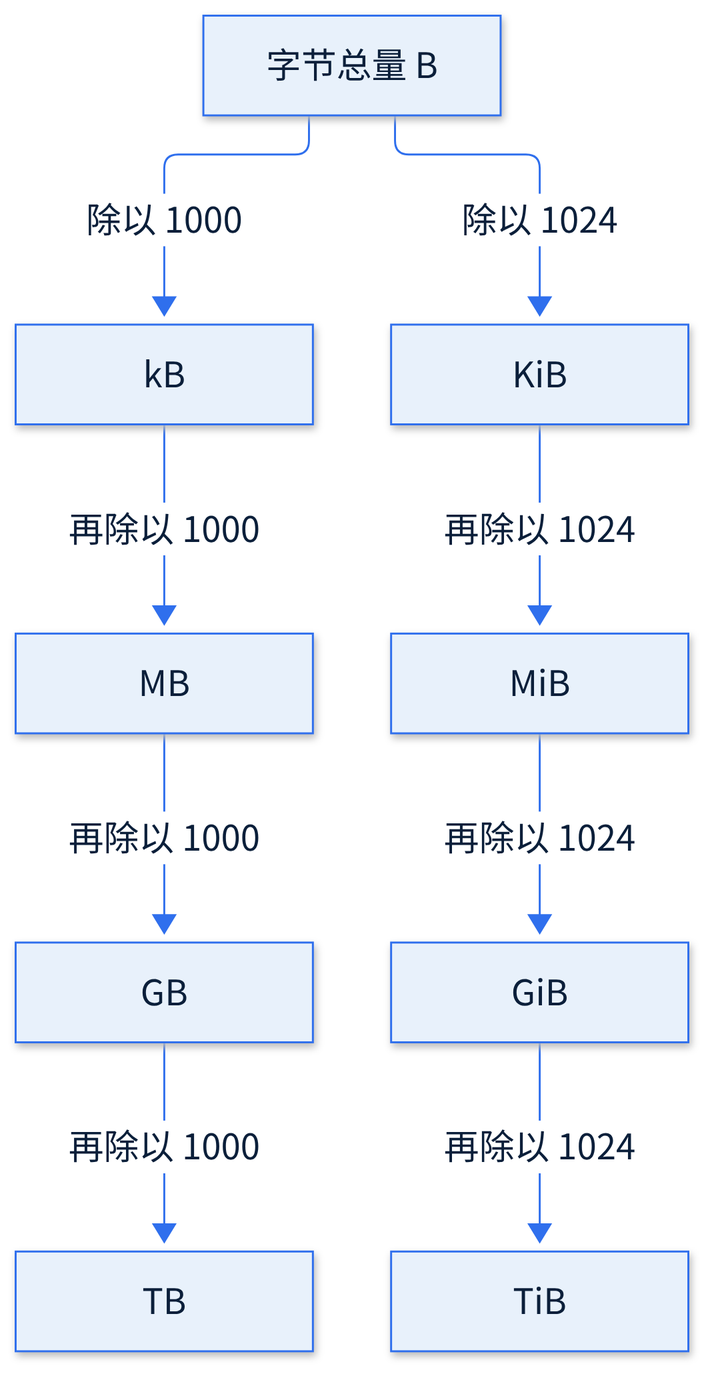
同样 1000000 字节,按十进制是 1 MB,按二进制约为 0.954 MiB。字节总量没有改变,变化的是分母。单位换算通常先统一为字节,再换成目标单位;计算时保留足够精度,显示时才四舍五入。否则,先把每个小文件的显示值取整再相加,累计误差可能明显大于预期。
现在估算1 段文本。假设正文有1000 个汉字,每个汉字恰好都是可用3 个 UTF-8 字节表示的码点,另有200 个 ASCII 字符,没有换行、字节顺序标记或其他内容。正文共需3200 B,即25600 bit,等于3.2 kB,约3.125 KiB。这里“3 字节汉字”是明确的样本条件,不能推广为所有汉字或所有中文文档都必然如此。
如果文件还包含换行,要按实际换行形式加入字节数。LF 占1 个字节,CRLF 占2 个字节。JSON 的字段名、引号、分隔符也是数据;如果字符被写成转义形式,字节数又会改变。富文本的格式信息、图片和压缩容器同样不在纯正文估算中。因此,估算用于建立数量级,真正决定限额和计费时,应测量最终序列化结果。
估算传输时间也要遵循相同方法。1 个 10 MB 的文件若按十进制计算,含 80000000 bit,在稳定的 10 Mbit/s 有效载荷速率下,理论传送时间为 8 秒。这里速率必须是可用于文件正文的有效速率;如果它只是链路标称值,结果只能作为理想下限。把文件大小换成 bit 再除以每秒 bit 数,单位相消后得到秒,也便于发现漏乘八的错误。
容量限制必须说明在哪1 层计数。1 个接口限制正文十 KiB,可能指接收到的原始请求体,也可能指解压后的内容;数据库字段限制字符数,又是另1 种口径。容量预算需要把这些层次分开。编码后的字节数、压缩后的字节数与落盘占用各有用途,不能互相替代。
用命令把表示规则看清楚
下面的命令面向提供常见 Unix 工具的终端,用短小的本地样本观察字节,不需要网络。printf 用于构造没有额外换行的文本,xxd 查看字节,wc 统计长度,iconv 按指定编码转换。工具是否预装取决于系统;如果缺少某项,可以先用下文 Python 标准库复核同一结论。
printf '%s' '云' > h1-sample.txt
xxd -g 1 h1-sample.txt
wc -c < h1-sample.txt
在终端和源文本使用 UTF-8 的前提下,十六进制查看结果中应出现 e4 ba 91,字节计数应为三。printf 不额外输出换行,所以样本正好只有目标文本;若改用默认追加换行的输出方式,文件长度往往会增加。xxd 左侧的偏移、中央的字节与右侧的字符预览各有用途,判断编码应以中央实际字节为依据。
LC_ALL=C wc -m < h1-sample.txt
# 在已配置的 UTF-8 locale 中再运行:
wc -m < h1-sample.txt
wc -c 数字节,wc -m 依据当前 locale 计字符。在 C locale 与 UTF-8 locale 中,字符统计可能表现不同;是否能得到预期字符数,还取决于工具实现和非法输入处理。不要把某1 次终端结果当作跨环境规范。对于业务约束,应该在程序中明确计数模型,并用已知编码样本验证。
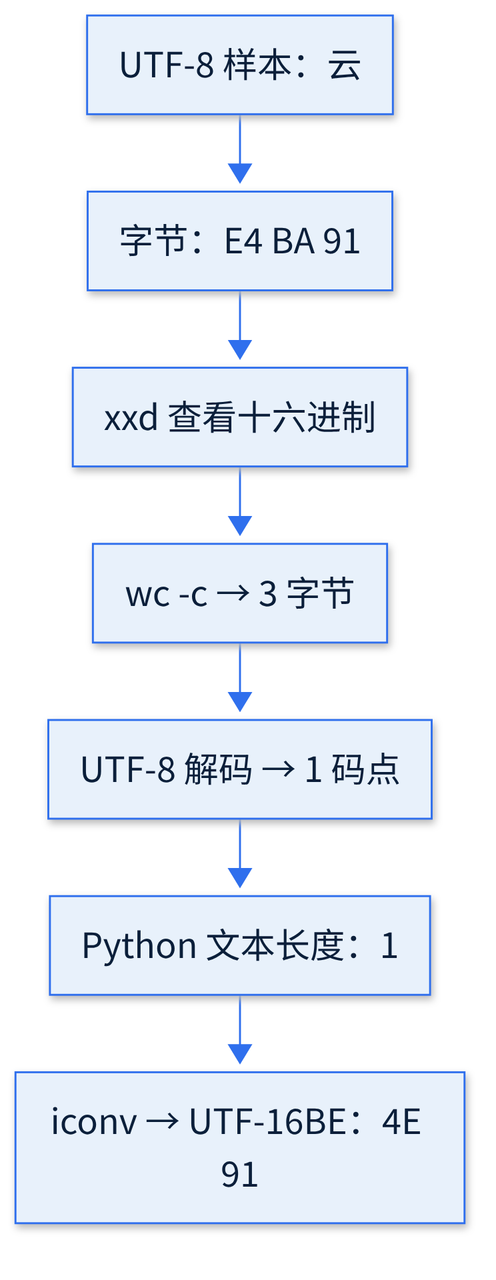
下面用 iconv 把 UTF-8 转成 UTF-16BE,再转回 UTF-8,输出写入不同文件,保留原样本。这里显式选择大端字节序,因此“云”的输出字节为 4e 91。显式编码名避免了依赖工具对默认字节顺序的选择。
iconv -f UTF-8 -t UTF-16BE h1-sample.txt > h1-utf16be.txt
xxd -g 1 h1-utf16be.txt
iconv -f UTF-16BE -t UTF-8 h1-utf16be.txt > h1-roundtrip.txt
xxd -g 1 h1-roundtrip.txt若输入字节不符合声明的源编码,iconv 通常会报告错误。此时应检查实际来源,不能不断更换参数,直到屏幕上偶然出现可读文字。转换的前提是知道源编码;转换成功也只证明输入符合某些规则,不足以证明得到的文字就是原文。
print(bin(45))                 # 0b101101
print(int('101101', 2))         # 45
print(int('55', 8))             # 45
print(int('2D', 16))            # 45
text = '云'
raw = text.encode('utf-8')
print(hex(ord(text)))           # 0x4e91
print(raw.hex(' '))             # e4 ba 91
print(len(text), len(raw))      # 1 3
print(raw.decode('utf-8'))      # 云
这段 Python 把数值转换与文本编码分成2 条路径。bin 和带底数的 int 处理整数的写法;encode 把文本变为字节,decode 把字节变回文本。len(text) 在此计算码点数,len(raw) 计算字节数。这个单码点样本中前者为一,但它并不保证所有可见字符都只占1 个码点。
3 类容易混淆的边界
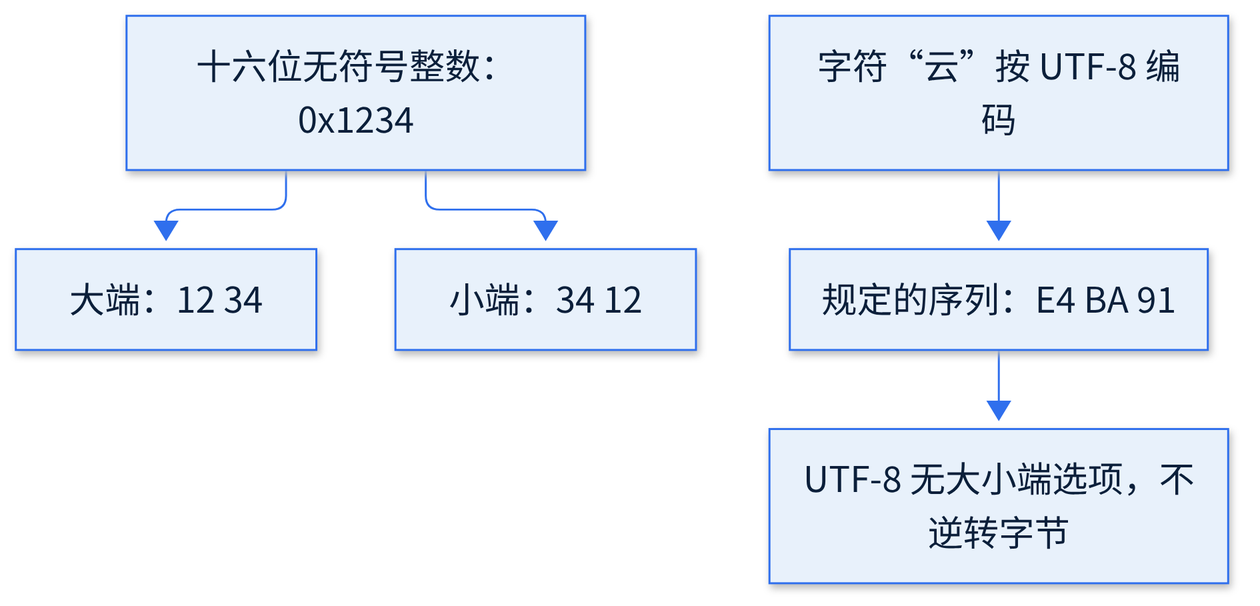
第1 类是大小端。大小端描述多字节数值中各个字节的排列顺序。例如1 个固定16 位无符号整数 0x1234,大端顺序为 12 34,小端顺序为 34 12。这不是把每个字节内部的比特反过来,也不是把字符串从右向左读。只有先确定字段是多字节数值以及其宽度,讨论字节序才有明确对象。
UTF-8 不需要选择大端或小端,字节序列的结构已经由编码规则规定。不能把“云”的 E4 BA 91 倒过来当作另1 种合法的 UTF-8 字节序。UTF-16、UTF-32 则需要处理多字节编码单元的字节顺序,可由明确的编码名或协议标记说明。字节顺序标记 BOM 在不同编码中作用不同;UTF-8 文件开头的 BOM 为 EF BB BF,它不是字节序切换指令,也不是所有文本格式都要求出现。
第2 类是显示形式与真实数据。日志中的 \xE4\xBA\x91 往往是3 个字节的可打印转义表示;实际文件也可能真的存了反斜杠、字母 x 和十六进制数字。前1 种情形表示3 字节,后1 种情形作为纯 ASCII 文本则有12 字节。仅凭截图无法区别,应查看原始字节,并确认日志框架是否在展示时进行了转义。
同样,JSON 中的 "\u4e91" 与直接写出的 "云" 可以在解析后得到相同字符串,但文件中的原始字节数不同。十六进制字符串 e4ba91 也是1 种展示或传输形式,本身由6 个 ASCII 字符组成;只有执行十六进制解析后,才得到3 个目标字节。不要把“看起来像编码”的文本直接当作原始内容。
第3 类是字符长度与存储长度。按字节截取 UTF-8 时,若截断在3 字节字符的中间,就可能留下非法序列。按码点截取虽然可以保留编码有效性,却仍可能拆开组合符号或表情序列。用于文件分块、数据库字段和界面摘要的截断策略,必须分别匹配它们需要保持的边界。界面摘要尤其应该考虑用户感知的字形簇。
这些边界有共同规律:先标明对象,再选择操作。数值才有位权与数值字节序;编码后的文本才有编码有效性;用户可见的文字才涉及字形组合。把所有东西笼统叫作“字符串”,容易让显示、解析、计数和截断混成1 个问题。
从乱码、日志和磁盘容量追到原因
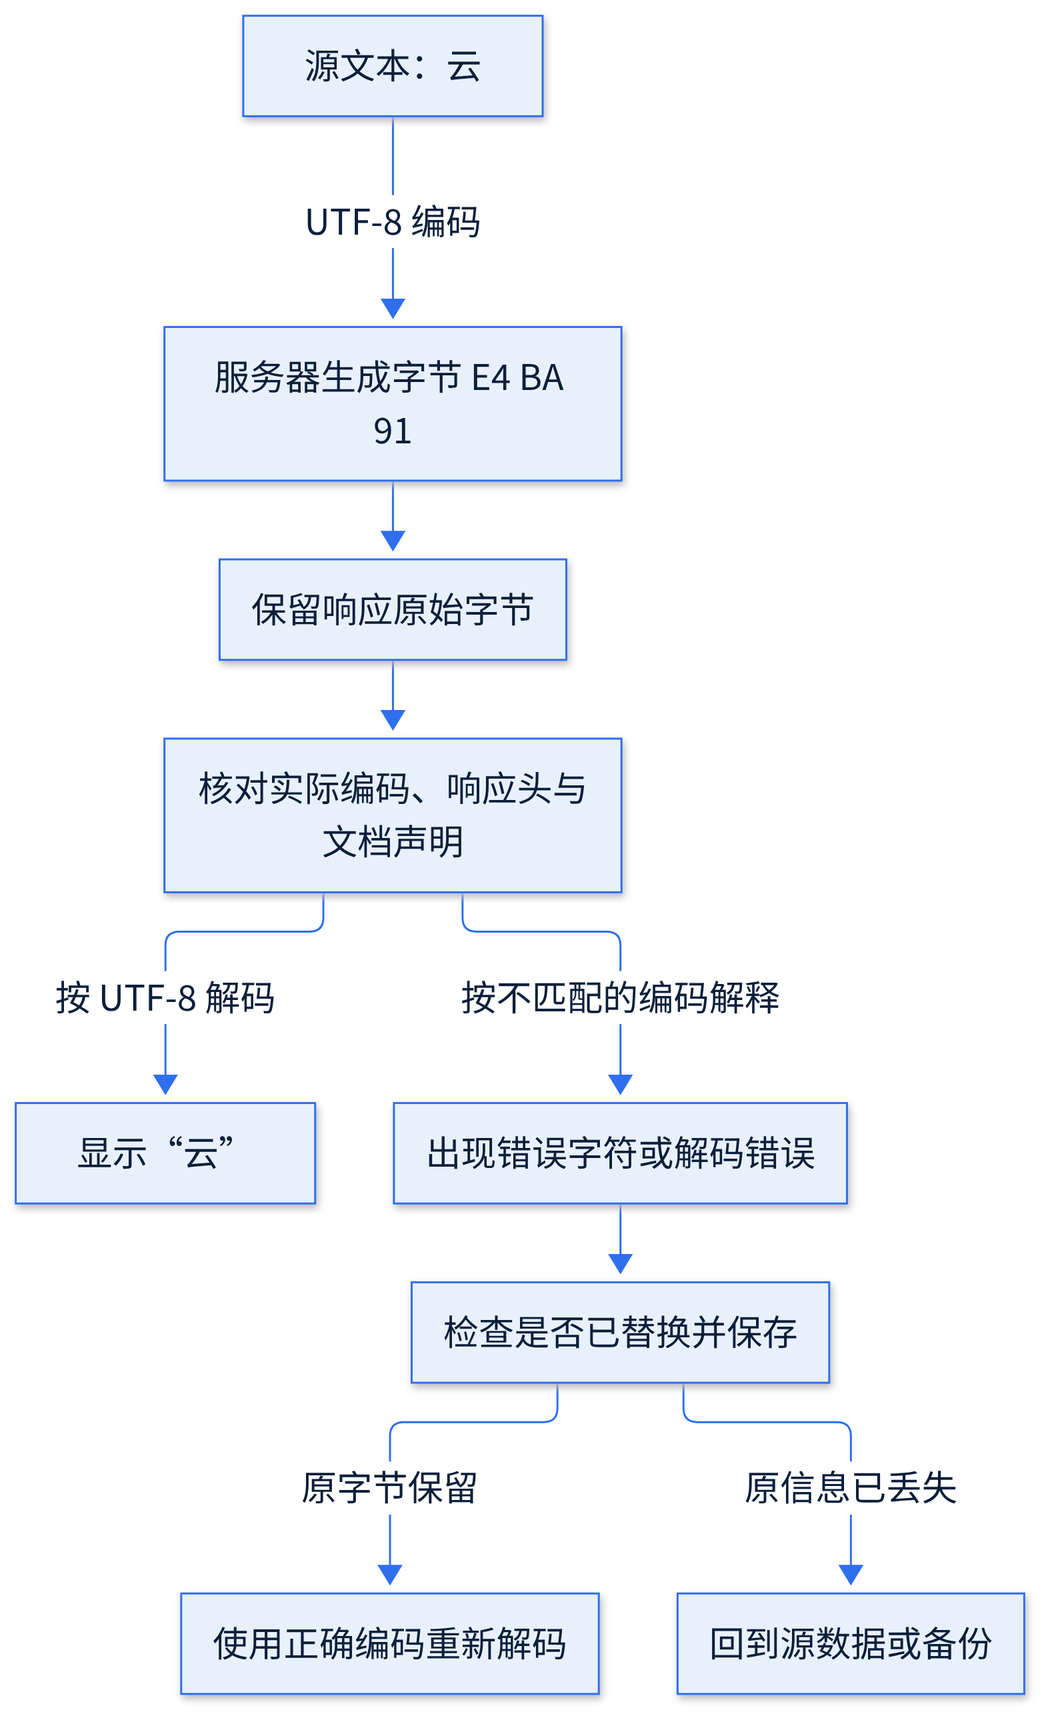
网页乱码通常发生在“写入字节所用编码”与“读取字节时采用的编码”不一致时。假设服务器实际发出“云”的 UTF-8 字节 E4 BA 91,浏览器却按另一套规则解读,它看到的字符就可能不同。编码错误发生在解释环节,并不意味着网络一定改动了字节。
排查时,先保留响应的原始字节,再检查响应头的字符集声明、文档内声明以及生成文件时的编码。对于常见 HTML 页面,可在响应中明确 Content-Type: text/html; charset=utf-8,并让文档声明与实际字节一致。具体采用哪条声明还受浏览器解析规则影响,工程上应消除互相矛盾的声明,而不是依赖猜测机制。
若原始字节仍然完整,改用正确编码解码通常可以恢复文字。若中间程序已经用替换字符覆盖了非法序列,或把内容改成问号后再保存,原始信息可能已经丢失。此时“再转1 次 UTF-8”无法重建被丢掉的字节,需要回到备份、源数据或上游重新获取。文字被错误解码后又编码保存,也可能产生多层乱码,必须沿处理链定位最早出现偏差的位置。
日志中的转义也要沿处理链理解。应用为了避免控制字符干扰日志结构,可能主动把字节显示为十六进制转义;查看工具又可能对反斜杠进行第2 次转义。此时不应直接删除所有反斜杠,而要确认哪1 层负责还原、格式允许哪些转义。将任意日志内容当代码执行来“解码”会引入新的风险,处理时应使用格式对应的解析器。
磁盘容量差异则通常先检查单位。1 块标称1 TB 的设备,若这里 TB 表示1 万亿 B,除以 2 的 40 次方,得到约 0.9095 TiB;除以 2 的 30 次方,得到约 931.32 GiB。两者描述的是同一数量。某些界面按二进制计算却显示 GB,进1 步放大了理解上的混乱,因此应同时记录字节总量和计算公式。
单位差异还不能解释所有可用空间变化。分区、文件系统元数据、预留空间、快照以及已有文件,都会影响最终可用容量。文件的逻辑长度与实际分配空间也可能不同,小文件会受分配粒度影响,稀疏文件和压缩又可能产生相反效果。看到容量减少时,应先核对总量的单位,再检查存储结构与已用空间,逐层解释差额。
这些案例都可以用同一方法处理:保存原始量,列出解释规则,复现1 次最小转换,再比较各阶段结果。编码问题比较原始字节和码点,容量问题比较字节总量和除数。只比较最终界面的文字或数字,往往无法区分到底是数据变化,还是显示口径变化。
课堂排查:从乱码样本还原编码约定
假设接口返回的“云”在页面上显示异常,课堂上先把问题缩小到一个字。已知发送端约定使用 UTF-8,接收端却把字符集声明成 ISO-8859-1。排查目标是验证字节有没有变化,再确定错误发生在读取还是保存环节。先保留原始响应作为证据;下面另建本地样本,用八进制转义直接写入指定字节,避免终端输入编码影响实验。
printf '\344\272\221' > lab-raw.bin
xxd -g 1 lab-raw.bin
# 00000000: e4 ba 91
iconv -f UTF-8 -t UTF-8 lab-raw.bin > lab-correct.txt
十六进制转储的中央应只有 E4 BA 91,没有换行。这与前面推导的“云”的 UTF-8 编码一致,按 UTF-8 解码应得到码点 U+4E91。即使查看器右侧没有显示汉字,也应先以字节列为准。若收到的实际样本不是这3个字节,就需要向上游检查序列化或传输前的处理,不能直接套用本例结论。
现在模拟接收端的错误:把同一份原始字节当成 ISO-8859-1 解码,再把得到的错误文本保存成 UTF-8。该编码会把每个字节分别映射成一个码点,因此结果依次为 U+00E4、U+00BA、U+0091,而不是“云”;最后一个是控制字符,屏幕上的具体外观并不可靠。
iconv -f ISO-8859-1 -t UTF-8 lab-raw.bin > lab-wrong.txt
xxd -g 1 lab-wrong.txt
# 00000000: c3 a4 c2 ba c2 91
比较两次转储,原始样本有3个字节,错误保存后变成6个字节。这里 iconv 可以成功退出,因为3个输入字节在所声明的源编码中都有定义;成功退出只说明转换可执行,不能证明源编码选对了。这也解释了为什么错误文件即使被编辑器识别为有效 UTF-8,内容仍然可能是乱码。
修复时分两种情况操作。若仍有原始响应,应从原始字节按 UTF-8 重新读取,并把接口字符集声明、文件保存编码和接收端解码设置统一,随后重新请求验证。若只剩本例的错误保存文件,且已确认完整处理链,可以先逆转错误保存步骤:
iconv -f UTF-8 -t ISO-8859-1 lab-wrong.txt > lab-recovered.bin
xxd -g 1 lab-recovered.bin
cmp lab-raw.bin lab-recovered.bin
iconv -f UTF-8 -t UTF-8 lab-recovered.bin > lab-fixed.txt
恢复后的字节应重新成为 E4 BA 91,cmp 无输出且退出状态为零表示两份字节相同,再按 UTF-8 读取才会得到“云”。这条逆转路径只适用于已知且未丢失信息的转换链;若曾被替换成问号、被截断或被过滤,应回到原始数据。实验记录要写明每一步的输入字节、声明编码和输出字节,并在修复配置后复测,确认新的数据不再经过错误转换。
放进方案里
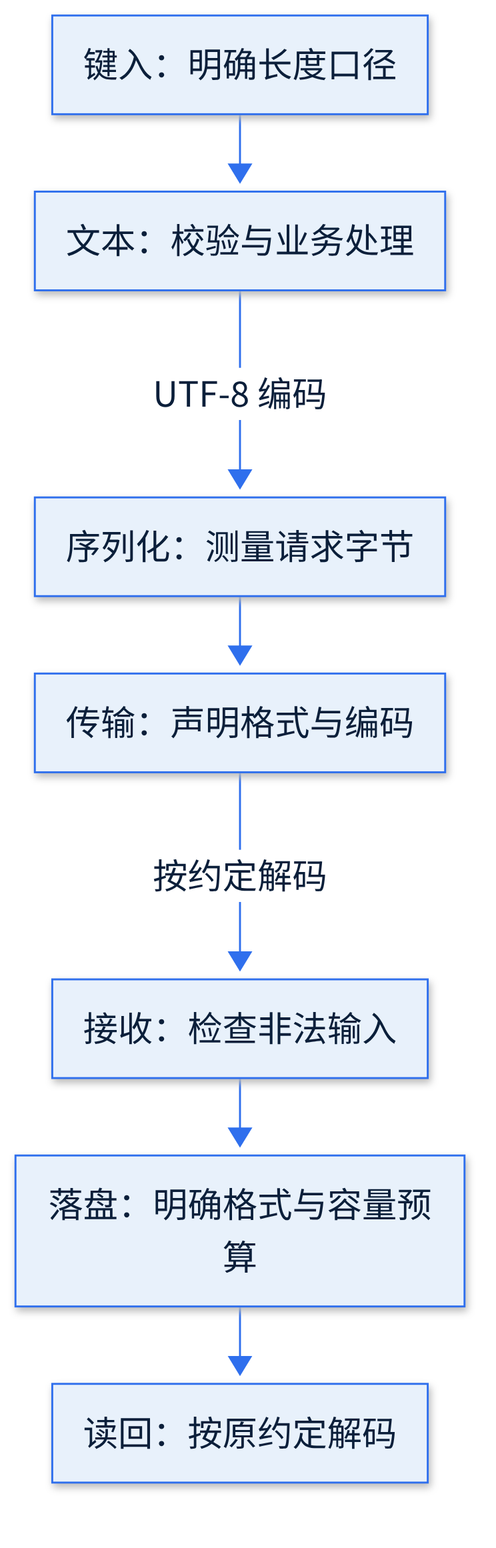
1 条数据从键入到落盘,会经过输入组件、内存中的文本表示、序列化、网络传输和持久化。逐段标注文本与字节的转换点,明确谁编码、谁解码,以及错误由谁报告。接口协议负责字节层面的约定,存储格式负责落盘后的解释,展示层负责字体与排版。不要假设某种运行时内部的字符串布局可以直接作为跨系统协议。
容量预算应列出每条记录的正文、结构字段与索引等开销,注明估算样本和增长量,再区分传输、逻辑存储与实际分配容量。统一写明十进制或二进制单位,并保留字节口径作为复核依据。压缩率来自样本测量,不能把某1 次测试结果当成全部内容的固定比例;预留量也应有明确用途和触发扩容的阈值。
验收时使用覆盖中文、ASCII、4 字节码点、组合字符与非法输入的样本,检查保存后读取是否符合约定,边界截断是否破坏内容。边界样本还应覆盖空文本、恰好达到上限的内容与刚刚超过上限的内容,确认错误提示和实际拒绝规则一致。观测信息应能定位失败环节并统计错误数量,生产日志避免直接记录敏感原文。这样,编码与容量就成为可以执行、测量和验收的工程约束,而不只是文档中的一句口号。
小结:把数值、表示和解释分开
数字系统以离散状态承载信息,比特提供2 个基本取值,字节通常由8 个比特构成。进制规定数值的书写方式,位权把写法还原为数值。二、八、十六进制之间可以借助分组转换,但分组不能改变原数的位序和数值。阅读调试输出时,先看底数和字段含义,再判断数据是否异常。
文字交换则需要把字符身份与编码后的字节分开。Unicode 码点是编号,UTF-8 是编码方式;“云”的 U+4E91 编码为 E4 BA 91。1 段文字的码点数、可见字符数和字节数可能不同。乱码需要检查编码与解码的约定,容量需要统一单位和计数层次,日志转义需要区分显示形式与原始字节。
继续学习 H2 时,这些结论将用于理解同1 组比特怎样表示整数、负数与其他数据,以及有限位数带来的范围限制。进入 H6 时,字节又会成为理解内存、存储和数据传送的基础。无论设备内部怎样实现,先明确“保存了什么、按什么规则解释、用什么单位计量”,都是分析数字系统的可靠起点。
下一课转向 H2 数据表示:把本章验收过的结论带进后续主题,写成可检查的方案约束。