1 负载均衡回答什么问题:稳定入口与后端集合解耦
C11 已把公网暴露面收束到入口层。接下来要解决的是:入口后面有多台应用,客户端应该找谁?假设订单服务部署在 3 台应用实例上,没有统一入口时,客户端可能需要知道 3 个地址,还要自行判断哪个地址可用。只要替换实例、增加容量或迁移可用区,地址集合就会变化。把这些变化传给所有客户端,既慢又容易留下过期配置。
负载均衡器,简称 LB,提供“稳定的流量入口 + 后端池抽象”。客户端访问 1 个名字,例如 orders.example.com;LB 根据配置和健康状态,把流量交给后端集合中的成员。应用从 3 台变成 4 台,客户端仍然访问原来的名字。这里的稳定首先指访问名称和服务契约稳定,并不承诺该名称永远解析到同 1 个 IP。托管 LB 可能有多个入口节点,地址也可能随服务维护而变化。
公网与私网的边界适合放置这种入口:外部只需认识业务域名,内部实例地址、端口和成员变化留在边界之后处理。公网地址挂在 LB 或 LB 的公网入口上,应用使用私网地址接收转发。内部服务之间也可以使用私有 LB,原理相同,只是入口不对公网开放。因此,“负载均衡”描述的是分配流量的职责,“公网入口”描述的是部署位置,两者不能画等号。
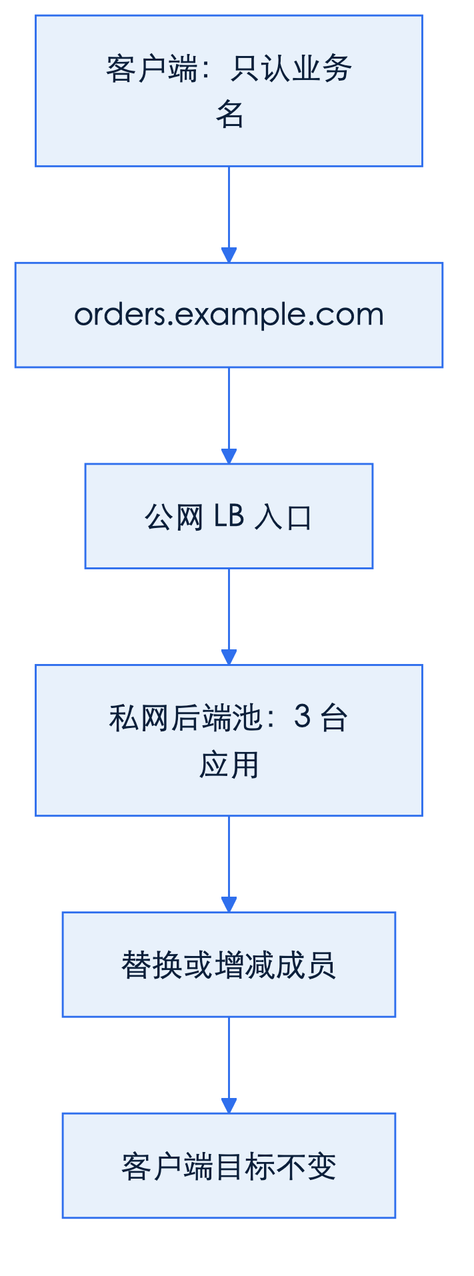
考虑 3 台应用各能稳定处理每秒 100 个请求,业务到达率为每秒 180 个请求。在请求成本相近、分布合理的理想条件下,每台约接到每秒 60 个请求。替换其中 1 台时,LB 暂时把新流量交给另外 2 台,每台约每秒 90 个请求。这个算例说明,LB 可以改变流量去向,但不能凭空创造处理能力。如果业务已达到每秒 260 个请求,剩余 2 台就可能过载;此时即使入口仍可连接,订单接口也可能超时。
因此要分别回答“入口能否到达”和“后端是否有足够容量”。LB 帮助我们在成员变化时保持访问目标稳定,并按规则挑选可用后端;实例数量、应用耗时和数据库承载力仍然需要设计。扩缩容策略见 C5,本课只关心新增成员怎样接流量、故障成员怎样退出,以及这些变化是否会打断用户请求。
2 监听器与目标组:端口、协议与后端集合
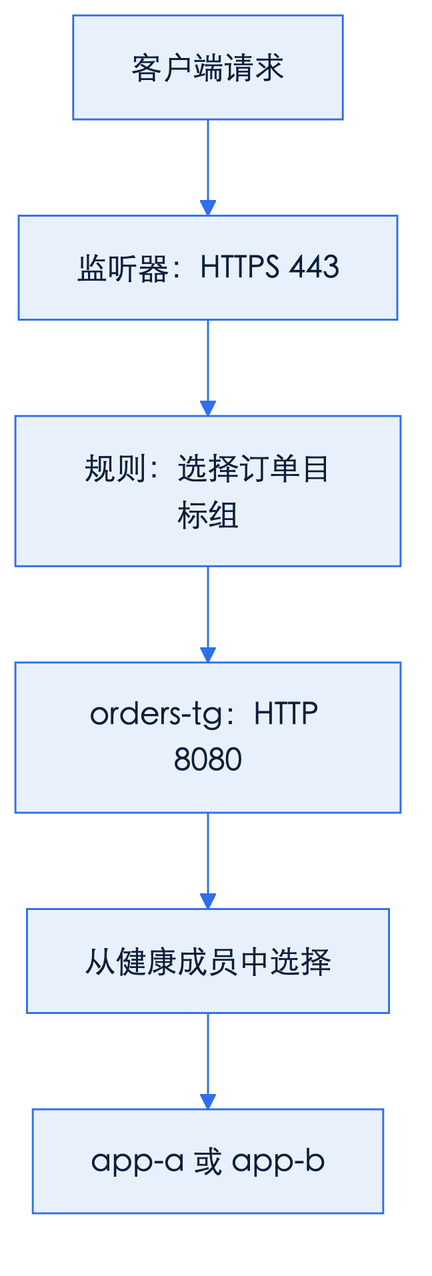
理解 LB 配置,可以从 2 个问题入手:入口接收什么,收到后交给谁。监听器回答前者,目标组回答后者。监听器声明对外协议与端口,例如 HTTPS 443;目标组声明后端集合及其协议、端口、注册方式,例如 HTTP 8080、按实例注册。前后端端口不必相同,客户端连接 443,并不意味着应用也必须监听 443。
目标可以是实例、IP 地址,或产品支持的网卡等资源。具体注册类型依产品而异,某些服务会通过实例的网卡地址定位目标,却不直接提供“网卡”注册选项。选择注册方式时,要明确地址由谁维护、实例替换后谁更新成员,以及目标是否能从 LB 所在网络到达。目标组是一组有路由用途的成员,不能只把它当成控制台上的实例清单。
例如,入口为 HTTPS:443,默认动作指向 orders-tg;这个目标组包含 app-a:8080 和 app-b:8080。用户请求先匹配监听器,再由规则确定目标组,最后才从组内选择具体目标。若使用 7 层 LB,还可把主机名 orders.example.com 或路径 /orders/ 转给订单目标组,把 /catalog/ 转给商品目标组。规则先后顺序、默认动作和路径匹配范围都需要明确,否则请求可能进入健康却错误的服务。
注册成功只表示成员信息进入配置,通常不等于已经可以接收业务流量。新实例应先完成启动、加载配置和必要预热,再注册或通过健康检查进入可选集合。反过来,发布时不能先杀进程再注销目标;应先停止把新请求交给该目标,再等待在途工作结束。平台常把这段过程称为连接排水或注销延迟,是否保留已有连接、如何处理长连接,应以产品行为为准。
设正常请求最多需要 8 秒完成,团队给发布预留 15 秒排水时间。注销后,应观察目标进入排水状态,再等待已有请求结束,最后停止进程。若其中还有持续 5 分钟的下载或 WebSocket,15 秒并不能保证它们自然结束,必须另外约定重连和中断行为。注册、检查、接流量、注销、排水是发布流程的一部分,不能由“实例创建完成”或“部署命令成功”替代。
3 4 层与 7 层:按连接分还是按请求分
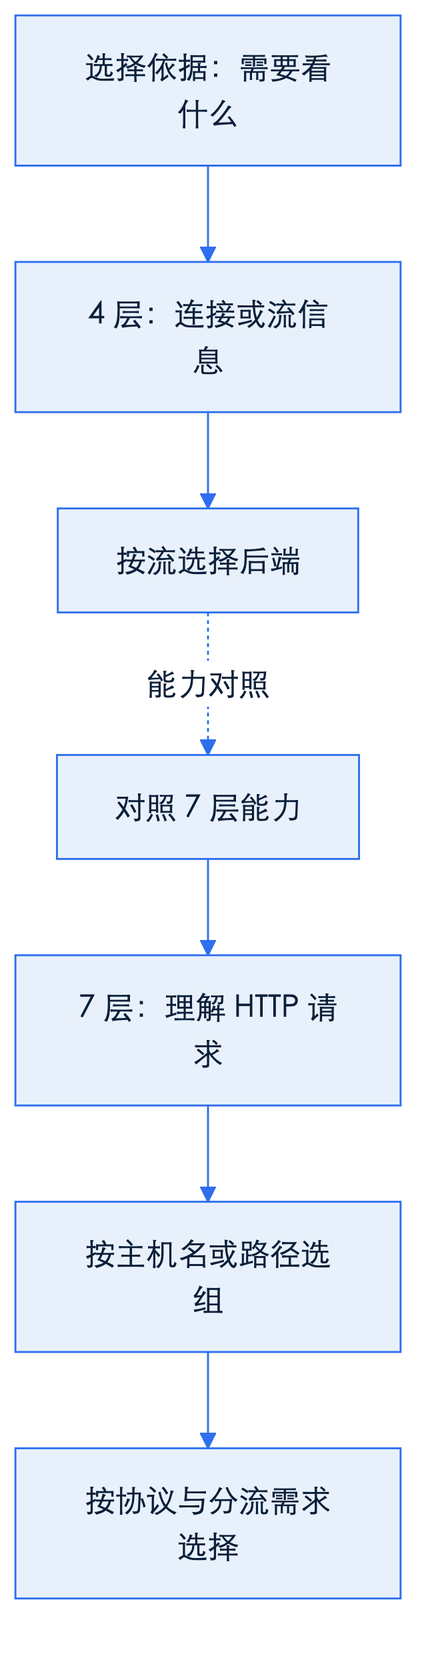
4 层 LB 主要依据传输层信息处理连接或流,例如 TCP 的源地址、目标地址和端口。它不需要理解 HTTP 路径,适合通用 TCP 服务,通常处理开销较低。可以把它理解为:连接建立时决定把这条流交给哪个后端,之后按连接状态继续转发。实际实现也可能使用流哈希;UDP 没有 TCP 式连接,产品仍可按流特征维护分配关系。
7 层 LB 理解应用协议,以 HTTP 为例,可以检查主机头、路径、方法等请求信息,再决定目标组;部分产品还支持请求头改写。假设同 1 个域名下,/orders/42 进入订单服务,/images/logo.png 进入静态资源服务,这种依据内容选择后端的需求适合 7 层处理。并非每个 7 层产品都支持所有规则,方法匹配和头改写也应检查实际能力。
连接与请求的区别会影响分布直觉。假设有 100 个普通客户端,各发起 1 条短连接,另外 1 个客户端在 1 条长连接中发送大量请求。4 层分配即使把连接数分得很平均,也可能让承载这条繁忙连接的目标明显更忙。HTTP 长连接或 HTTP/2 复用会进一步拉大“连接数”和“请求数”的差距。7 层代理理解请求,能够按产品策略作出更细的分配,但也不能保证每个请求的执行成本相同。
选择时先问是否需要按内容分流。如果只是承载非 HTTP 的 TCP 协议,4 层通常更自然;如果需要按主机名、路径选择服务,7 层更合适。接着检查协议兼容、长连接行为、额外处理开销和排障证据。入口每秒能接受多少连接,与它能处理多少 HTTP 请求是不同指标,比较容量时不要混用。
“7 层”不是“更安全”的同义词。能看到路径,只表示具备理解请求的条件;哪些路径应允许、后端能否被绕过、证书是否正确,仍取决于配置。4 层服务也可以承载加密流量,7 层服务也可能因为后端对公网开放而失去入口收束的意义。选型应从路由和协议需求出发,不能把层次名称当成安全验收结果。
4 健康检查:谁该接流量、何时摘除
LB 需要持续判断成员是否适合接收新流量。健康检查至少要明确协议、端口、路径、成功条件、间隔、超时、不健康阈值和健康阈值。间隔决定多久发起 1 次检查;超时决定等多久算本次失败;不健康阈值决定连续失败多少次才摘除;健康阈值决定连续成功多少次才恢复。不同产品的初次注册、恢复和多节点检查规则可能不同,配置时应分别确认。
例如检查 HTTP:8080/health,只接受状态码 200,间隔 10 秒,超时 2 秒,不健康阈值 3,健康阈值 2。目标连续失败 3 次后转为不健康,停止获得正常的新流量;连续成功 2 次后才恢复。失败 1 次就摘除,会对短暂抖动很敏感;阈值过大,又会延长故障目标仍在接流量的时间。阈值表达的是稳定性和响应速度之间的取舍。
“间隔 10 秒、不健康阈值 3,约 30 秒摘除”是便于规划的估算。若故障刚好发生在上次检查之后,接下来可能在第 10、20、30 秒才看到连续失败。若故障恰好发生在下次检查之前,失败观察会更早开始。检查超时、节点观察差异和状态传播还会带来额外延迟,所以不能把 30 秒写成严格的故障切换保证。
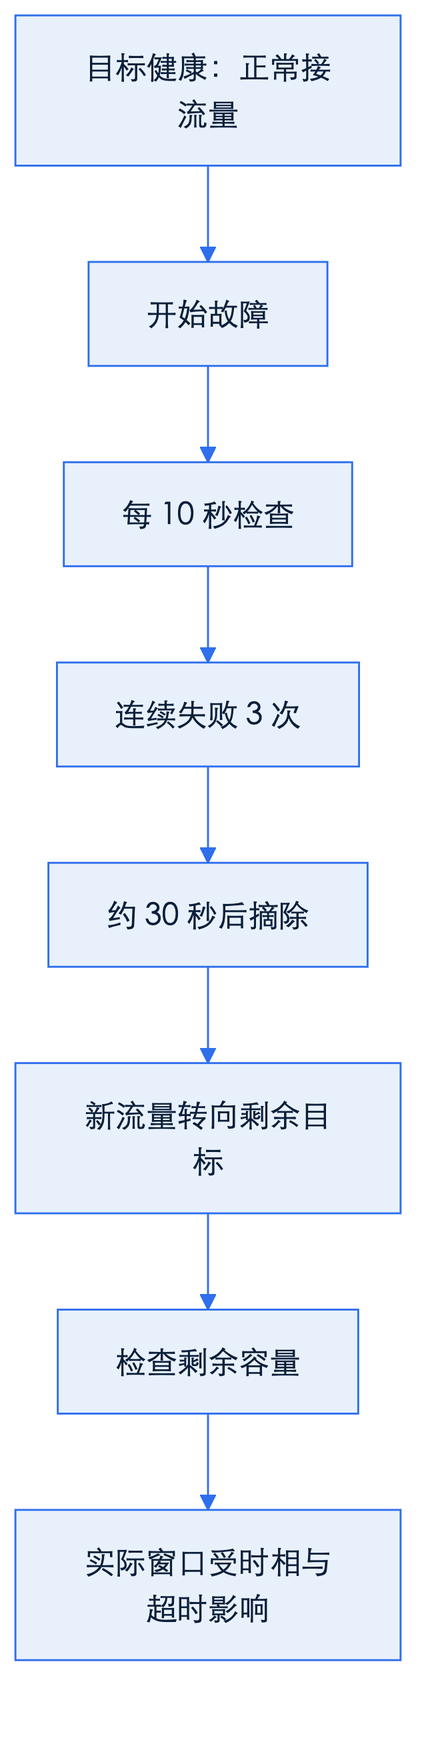
在简化模型中,检查周期为 I,不健康阈值为 U,故障发生到第 U 次失败检查开始的等待约为 (U−1)×I 到 U×I;若失败靠超时确认,还要考虑该次超时。取 I 为 10 秒、U 为 3,主要等待约 20—30 秒。把间隔改为 5 秒、阈值保持 3,等待约 10—15 秒,但探测频率也随之增加。这个模型用于理解参数,不模拟所有厂商实现。
摘除会减少可用容量。若 3 台目标原本各处理每秒 80 个请求,合计每秒 240 个请求;摘除 1 台后,另外 2 台平均各承担每秒 120 个请求。若它们每台只能稳定处理每秒 100 个请求,故障会把健康目标也推向过载。因此滚动发布既要留出启动与恢复窗口,也要给排水和容量下降留余量,不能只把健康检查间隔调小就认为发布风险已经解决。
检查成功路径必须能代表业务可达路径。C10 的探针教训在这里同样适用:从运维机访问成功,不代表从 LB 发出的检查能通过网络规则;检查端口可连,也不代表监听器转发到的业务端口可用。如果 /health 由独立进程永远返回 200,而订单进程已经退出,目标就可能被误判为健康。反过来,把需要登录的页面用作探针,又可能因为 302 或 401 把正常实例摘除。
健康端点应反映本实例能否承接该类请求,同时保持轻量。是否把数据库短暂异常直接映射为全体应用不健康,需要谨慎决定:所有目标共享的依赖故障,可能导致整个目标组被摘空。全部不健康时,有些产品会拒绝转发,有些存在继续向不健康目标转发的行为,必须明确验证。摘除主要改变新流量的选择,不保证已经建立的连接或在途请求立即迁移。
5 会话保持与算法直觉:粘滞何时有害
轮询的直觉是依次选择目标:请求成本接近时,分配数量容易接近。最少连接倾向于选择当前连接较少的目标,但连接少未必工作少,因为 1 条连接可能持续传输大量数据。某些 7 层产品提供最少未完成请求等策略,依据的是另一个负载信号。算法名称只说明它在看什么,不能直接证明响应时间会均匀。
设 100 个请求中,90 个只需 10 毫秒,另外 10 个需要 2 秒。即使 2 台目标各收到 50 个请求,如果慢请求集中落在其中 1 台,耗时仍会明显不同。观察分布时,应同时看请求数、活跃连接、未完成请求和延迟,而不是看到请求数接近就认定负载均匀。实际产品支持什么算法,还可能受协议与目标组类型限制。
会话保持,也叫粘滞,会让同 1 个会话尽量回到同 1 个后端。典型动机是应用把登录状态或购物车放在本机内存:第一次请求落在 app-a,后续请求若去了 app-b,状态就找不到了。粘滞可以暂时维持这种应用的行为,但它同时把用户状态和某台机器绑定,削弱成员自由替换的能力。
例如 1000 个会话中有 10 个持续高频下单,若这些重会话碰巧集中在 app-a,即使其他实例空闲,也不能轻易把它们迁走。新增实例时,已有粘滞会话也可能继续留在旧实例,短时间内看不到明显分流。故障后,LB 即便把新请求交给别处,原来保存在故障实例内存中的会话状态仍然不会自动出现。
更稳妥的长期方向是让应用无状态,或把需要共享的会话放到适合的外部存储中。本课只确定状态放在哪里、故障后用户会经历什么,存储实现留给后续内容。必须使用粘滞时,要记录标识来源、有效期和失效行为:更换 cookie、客户端清除 cookie、后端被摘除,或某些实现中更换 LB 节点,都可能使绑定失效。验收应覆盖重新登录、购物车恢复和重复提交处理,不能只验证连续刷新时始终落到同 1 台。
6 TLS 与证书挂载:在哪一层终结
TLS 在哪里终结,决定谁持有证书、谁负责轮换,以及哪一段链路被加密。最常见的方式是在 LB 上终结:客户端与 LB 建立 TLS,证书绑定到 HTTPS 监听器;LB 解密后,根据 HTTP 信息选择后端。这样多个应用实例共用入口证书,证书更新集中发生在入口,而不是逐台修改应用。
入口解密之后,LB 到应用可以使用 HTTP,也可以重新建立 TLS。选择依据是这段网络的信任边界和安全要求。使用 HTTP 时,公网到入口的加密不会自动延伸到后端;使用 HTTPS 时,也应明确后端证书是否被验证、按什么名称验证。仅把目标组协议改为 HTTPS,不能据此断言后端身份已经得到严格校验,具体能力取决于产品。
另一种方式是 TLS 透传:LB 转发连接中的加密数据,由应用终结 TLS。此时面向客户端的证书在应用侧,应用发布流程需要处理证书分发和轮换。由于 HTTP 内容仍被加密,透传节点通常不能按 HTTP 路径、方法或普通请求头路由,也不能任意改写这些头。若业务需要这些 7 层能力,就要重新判断终结位置。
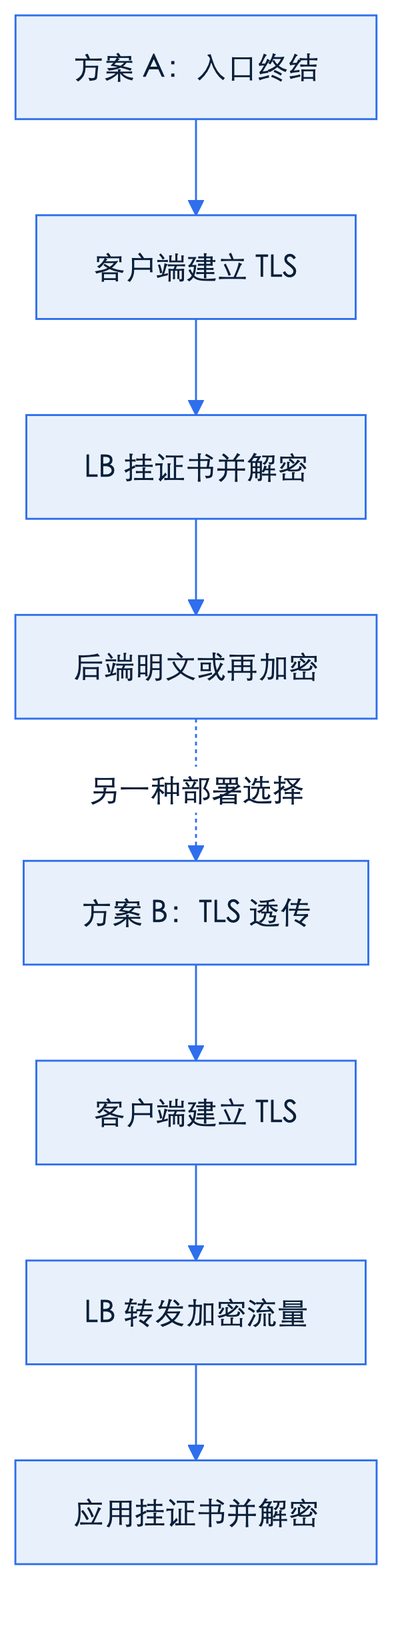
SNI 是客户端在 TLS 握手中用于表示目标主机名的信息,与加密后的 HTTP 主机头不是同一层。有些 4 层产品可以依据可见的 SNI 做有限选择,但这不等于能读取 HTTP 内容,而且能力受到协议与产品限制。对本课的方案,只需写清“哪一层看得见什么”:入口终结后可检查 HTTP;纯透传时,HTTP 路由主要留给终结 TLS 的应用或后续代理。
以 orders.example.com 为例,客户端会检查证书是否覆盖这个名字、是否在有效期内,以及证书链是否受信任。现代客户端主要依据 SAN 中的名称校验,不能只凭证书页面上的 CN 判断匹配。还要确认正确证书确实绑定到正在使用的监听器,存在多张证书时能按 SNI 选中预期证书。轮换完成的证据应是实际握手看到新证书,而不仅是上传操作成功。
方案里要明确入口证书由谁维护、后端证书由谁维护,以及更新失败时如何回退。TLS 的握手和证书链细节见 S20;本课停留在“挂在哪一层、谁轮换、用户看到哪个名字”,避免把证书存在某个资源列表中误当成已被业务使用。
7 常见坑:把 LB 当防火墙、健康检查走错路径、单可用区入口
第 1 个坑是只保护 LB,后端却仍允许公网任意来源访问。用户就能绕过统一入口,入口日志、路由与证书安排也无法覆盖这条路径。与 C10 的角色规则对齐即可:LB 安全组允许 443,应用安全组的 8080 仅允许来自 lb-sg。这里不重写安全组矩阵,关键是验收时既验证入口成功,也验证后端不能被外网直接访问。
第 2 个坑是把健康检查 URL 的 404 当成健康。有些系统为了“先让目标变绿”,把成功状态码范围放宽到包含 404。结果 /health 根本不存在,目标仍显示健康,真正业务的可用性没有被检查。应该先确认端点语义,再选择成功条件。只有业务明确把某种响应定义为可服务信号,才能接受该状态,不能为消除告警而放宽匹配。
第 3 个坑是把所有东西都放进同 1 个可用区。目标有 4 台,也只是在同 1 个故障域里增加机器数。跨可用区设计应同时检查入口服务启用了哪些可用区、目标分布在哪些区,以及入口节点能否把流量交给其他区的目标。仅在架构图里画出 2 个区,不代表实际启用状态和转发策略已经一致。
跨区也有代价:某些产品或配置下,跨区转发可能带来费用;入口吞吐、连接数、新建连接速率、目标数量还可能受到配额限制。应按所选服务确认,不能把其他产品的免费规则或默认开关套过来。若流量集中进入某个区,而跨区转发关闭,该区目标可能过载,即使另一个区仍有空闲容量。
第 4 个坑是看到超时就只查应用耗时。若入口连接数达到限制、目标连接池耗尽,或者某个目标大量连接未释放,请求可能还没执行到业务代码就已排队或失败。排查时应先区分建立连接失败、TLS 握手失败和应用响应慢,再对照 LB 连接指标、目标组错误和应用日志。某台实例没有业务日志,也可能是流量根本没到达,而不是日志系统坏了。
最后,别把摘除理解成零损失。故障被发现前的窗口内仍可能有请求落到坏目标;连接排水超时也可能中断在途工作。订单写入涉及重复执行风险,不能依靠“LB 会换台机器”来证明重试安全。应用需要明确超时结果与重复请求的处理,这个边界应记录在验收结论中。
8 案例:订单入口经 LB 分到双可用区应用
订单系统采用 1 个公网业务域名,入口为 orders.example.com:443,后端目标组为 HTTP 8080。可用区 A 部署 app-a,可用区 B 部署 app-b;入口服务同时启用这 2 个区,并确认所选跨区转发行为。健康检查访问 HTTP:8080/health。应用没有公网入口,应用安全组只接受 lb-sg 到 8080 的流量,客户端始终使用订单域名。
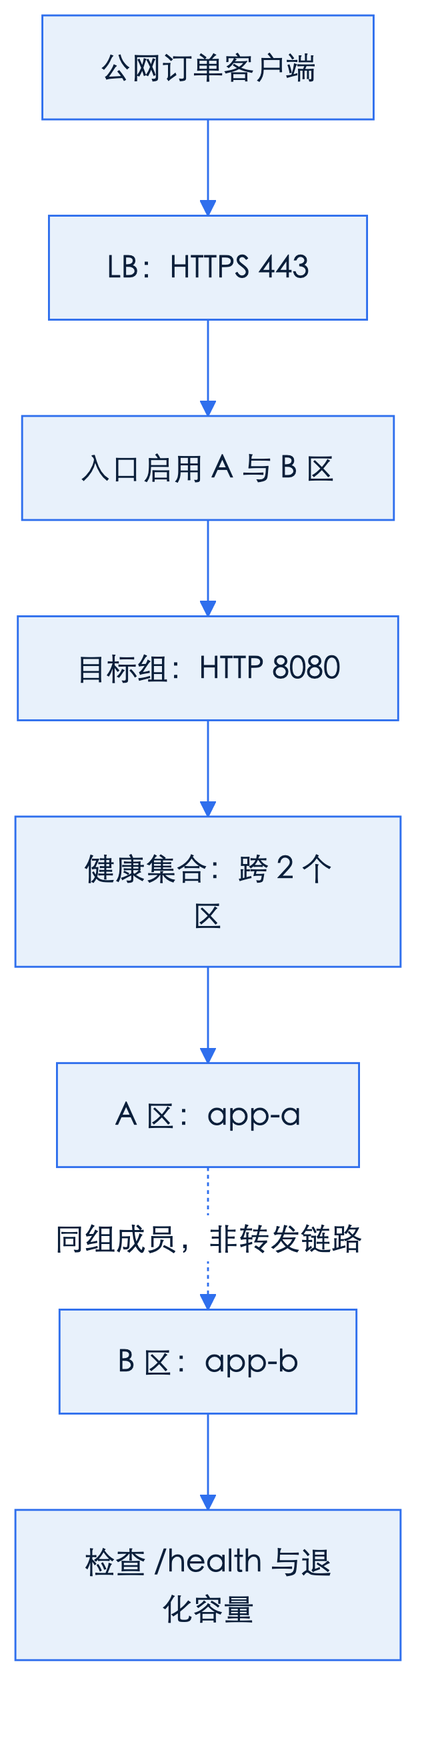
选择 7 层 LB 的理由是后续需要依据主机名或路径选择目标组,当前默认规则先指向订单目标组。TLS 在 LB 终结,证书 SAN 覆盖 orders.example.com;后端是否再加密由部署环境的信任边界确定。应用把会话状态放在共享位置,不依赖粘滞。这里的“双可用区”说明入口后面的故障域分散,并不自动证明数据层已具备相同的可用性。
先计算退化容量。假设每台应用稳定处理每秒 150 个典型请求,正常流量为每秒 120 个请求。2 台均匀分配时,各约每秒 60 个请求;摘除 1 台后,剩余实例约每秒 120 个请求,仍低于单台已验证的能力。若正常流量增加到每秒 220 个请求,双实例总容量虽足够,失去 1 台后的容量就不足,方案不能继续声称承受单实例故障。
把健康参数写成间隔 10 秒、超时 2 秒、不健康阈值 3、健康阈值 2。发布新版本时,先让新目标通过检查并实际处理少量请求,再注销旧目标、等待排水,最后停止旧进程。若新实例从就绪到通过连续检查还需约 10—20 秒,发布系统必须把这个窗口留出来;不能在目标刚注册时就撤掉旧容量。主动注销与等待探针发现故障是不同过程,不应混用等待时间。
验收先建立基线:从外网用业务域名完成证书校验并请求订单查询,记录响应、延迟和目标组健康状态。通过测试用日志中的目标标识,确认 2 个区的实例都实际接过请求。少量请求没有均匀落在 2 台上不一定是错误,应结合足够样本、算法和连接复用判断;也不应为了展示分布而把内部实例信息暴露在生产响应中。
接着做受控摘除。让 app-a 注销并进入排水,观察新流量迁移到 app-b,原有短请求正常结束,入口域名保持可用;再让 app-a 恢复,确认经过健康门槛后重新接流量。另一次在受控环境中模拟进程故障,记录从失败开始到目标不健康的时间,观察这段窗口内的错误。前者证明发布流程,后者证明故障发现,不能用同 1 次实验代替。
最后检查负向边界:外网直连应用地址应失败,错误域名不能被当成正确订单域名通过证书校验。以可用区级故障为目标时,还需测试相应区退出后的入口行为和剩余容量。数据库若仍在单个故障点,入口通过验收也不等于订单系统整体可用;这正是后续 C13 要继续接住的问题。
9 排查案例:部分用户失败、新实例接不到流量、证书名不匹配
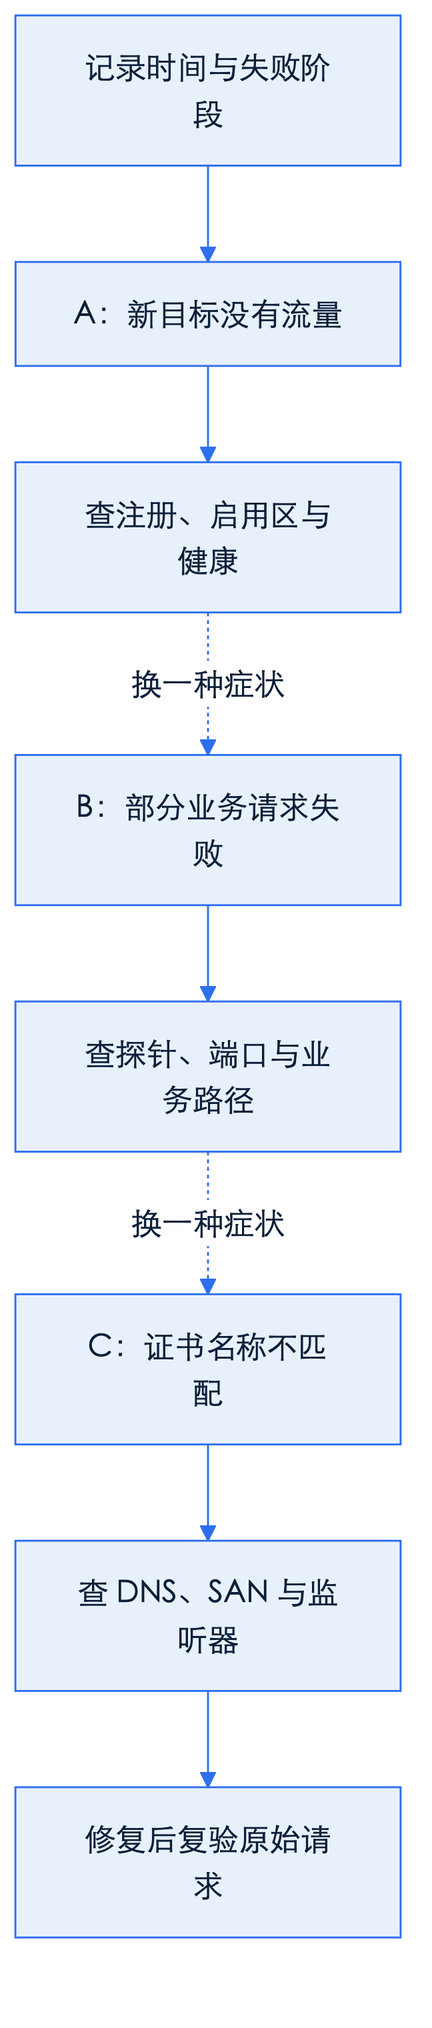
值班收到 3 种现象:部分用户偶尔失败,刚发布的实例没有请求,另一些用户看到证书名称错误。不要先归结为“LB 不稳定”。先记录发生时间、访问域名、错误阶段,以及是所有用户还是某类客户端受影响。DNS、TLS、监听器规则、目标健康和应用响应属于不同证据层,同 1 个最终超时可能来自其中任何一层。
路径 A 从“新实例没有流量”开始。先查目标组成员,发现 app-c 根本没有注册;部署日志只有实例启动成功,没有目标注册成功记录。修复发布步骤后,app-c 出现在目标组,但状态仍不可用,原因是它位于可用区 C,而入口只启用了 A、B。若该产品要求目标所属区被启用,这就是直接原因;应按既定拓扑调整目标位置或入口启用范围,再观察健康状态。
不能仅凭 app-c 的访问日志为空判定注册问题。它也可能已经健康,只因粘滞会话仍指向旧目标,或规则把测试请求转到了别的目标组。路径 A 的完整证据链是:监听器规则确实选择该组,成员确实注册,目标所属区满足要求,目标健康,然后才检查请求分布。修复后用带正确主机名和路径的新请求验证,并对照目标日志,不能强行期待轮询一定按实例顺序出现。
路径 B 从“部分用户失败”开始。目标状态显示 app-a 健康、app-b 不健康,原因是检查返回 404。登录 app-b 后发现 /health 未部署,但 /orders/42 可以正常响应。如果失败的时间落在摘除前的窗口,部分请求曾进入 app-b 就有了解释。修复端点、收紧成功条件并等待健康阈值满足后,还要确认真实订单路径正常,不能只看到状态变绿就关闭问题。
另一个路径 B 变体是探针成功,业务却失败。检查器访问 8081 上的独立健康进程,而目标组转发到 8080,订单进程实际上没有监听。此时应对照检查端口、转发端口和应用监听地址;若目标是私网地址,还要确认进程没有只绑定回环地址。若报错是检查超时,则进一步核对从 LB 到目标的安全组引用及网络可达性。不要用运维机的成功探测替代这条实际链路的证据。
路径 C 从“证书名不匹配”开始。先运行 dig orders.example.com,确认 DNS 指向预期入口;再运行 curl -v https://orders.example.com/health,观察握手与证书校验错误。如果入口返回的是覆盖 api.example.com 的证书,检查 HTTPS 443 监听器是否绑定了正确证书,以及多证书情况下的 SNI 选择。证书已上传但未挂到监听器,客户端仍会收到旧证书。
需要固定某个入口 IP 排查时,可使用 curl -v --resolve orders.example.com:443:203.0.113.10 https://orders.example.com/health,其中示例地址须替换为实际入口地址。这样保留业务域名对应的 SNI 和名称校验,同时控制连接目标。直接访问 https://入口IP 会改变被校验的名称,容易引入额外的名称错误。不要用 -k 跳过校验后得到的成功响应证明证书修复。
如果只有部分用户看到旧证书,再比较他们的 DNS 解析、实际连接地址和握手拿到的证书,确认是否存在旧入口或不同监听器。DNS 调整后,缓存与已有连接也可能让不同用户暂时走向不同位置;应结合记录的有效期与连接行为判断。一次 dig 只能说明该次查询所见,不能代表所有客户端已经更新。
排障收尾要把证据连起来:目标组成员与健康原因解释谁能接流量,监听器规则解释流量去哪组,安全组引用解释链路是否允许,AZ 分布解释故障域,DNS 与证书解释用户实际连接到谁。修复后复测原始失败请求,并检查目标恢复、错误率回落和负向边界。只改配置、不等待状态收敛,容易把仍在传播的变化误判成修复无效。
放进方案里
在方案的入口部分写出业务 DNS、解析目标、入口类型和证书覆盖名称,标明 TLS 在哪里终结、谁负责轮换。若后端再次加密,补充后端证书的维护与验证方式。把客户端实际访问的名字作为验收对象,避免只记录资源名称,交付时却无人确认监听器使用了哪张证书。
列出监听器与目标组对应表,至少包含入口协议及端口、规则条件、默认动作、后端协议及端口、注册类型和成员所在可用区。说明选择 4 层或 7 层的具体理由,例如需要按路径分流,或必须透传某种协议。记录注册、注销与发布流程的衔接,以及排水时间对短请求、长连接分别意味着什么。
健康检查写清协议、端口、路径、成功条件、间隔、超时、不健康阈值和健康阈值。用“间隔 10 秒、连续失败 3 次,约 30 秒才摘除”解释故障窗口,并给恢复和新实例就绪留出时间。注明摘除后的剩余容量,说明共享依赖故障和全体目标不健康时的预期行为。
写明会话是否依赖粘滞、状态保存在哪里,以及绑定丢失后的用户体验。标出入口启用的可用区、目标分布、跨区转发行为及相关成本和配额。与 C11 的公网暴露面、C10 的角色安全组保持一致,明确外部只能经入口访问应用,不把后端临时开放当成长期排障办法。
正向验收覆盖业务域名访问、证书名称匹配、双区目标接流量、注销排水和故障摘除后的迁移;负向验收覆盖外网绕过入口失败、错误路径不能被误判健康、未就绪目标不接正常流量。每项留下时间、目标状态、请求结果与观察到的窗口,注明在途请求可能失败的边界,使方案能由另一位工程师按证据复验。
10 小结:入口层收束与数据层衔接(C13)
LB 用稳定入口承接变化的后端集合:监听器定义如何进入,目标组定义交给谁,健康检查决定谁暂时退出。4 层与 7 层服务于不同分流需求,粘滞与 TLS 终结位置则影响状态、证书和发布责任。跨可用区只有配合实际启用状态与退化容量,才能形成可验证的可用性设计。
现在应能解释:为什么目标已注册却没有流量,为什么 10 秒间隔不等于 10 秒切换,以及为什么入口证书正确仍不能证明后端链路加密。入口层已承接 C11 的暴露面收束,下一步要把数据层可用性接上:常规路径先到 S21,再进入 C13 云数据库;stage-2 路径按 C12 → S22 → C13 前进。