训练任务从 1 台机器扩展到多台机器,变化的不只是训练速度。读取数据、分配资源、保存进度和处理故障都会相互影响:计算设备可能在等待数据,训练进程可能在等待检查点写入,调度器可能把刚刚失败的任务再次放到坏节点上。大规模训练工程要回答的是:在有限资源和不稳定环境中,怎样持续取得可验证的模型进展。
本课沿用真实机器学习问题理解这些机制,不要求先掌握分布式通信算法。你将先建立任务、数据与恢复状态之间的联系,再通过小规模故障续训理解大任务的运行约定。模型并行的内部实现、通信优化和优化器分片留给后续深入学习。
1 大规模训练工程要覆盖什么
设想团队用公开的 CIFAR-10 数据集训练图像分类模型。输入是 32×32 的彩色图像,输出是 10 个类别。数据集提供 50000 张训练图像与 10000 张测试图像;可以从原训练集划出 5000 张作为验证集,剩余 45000 张用于更新参数。测试集只在模型与配置确定后用于最终评估。增加设备以前,应先明确划分清单、预处理版本、训练预算和验收指标,否则速度提升可能只是在更快地产生不可比较的结果。
大规模训练通常指训练涉及较多计算、数据或持续运行时间,不能用某个固定设备数量定义。任务可能因为模型占用内存较多而扩展,也可能因为需要处理较多样本或缩短实验周期而扩展。公开的表格流失预测数据可能只需普通处理器;若当前瓶颈是数据泄漏或错误标签,增加设备没有帮助。工程师首先要用小规模基线证明任务值得扩展,并记录实际消耗在哪里。
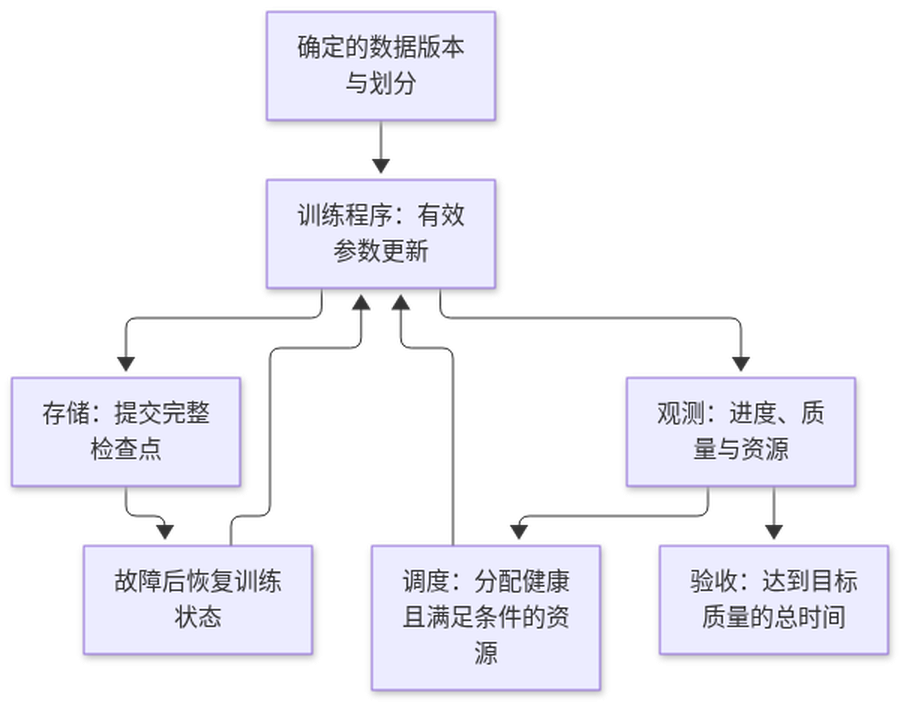
训练工程可以分成相互连接的责任:数据层交付确定的数据版本,训练程序按照约定更新参数,调度层分配可用资源,存储层接收可恢复状态,观测层说明任务是否有效前进。调度器显示“运行中”,只能说明进程获得了资源;训练损失长期不变、有效样本数不增长或验证指标异常,都可能表示任务没有取得预期进展。系统健康与模型质量需要分别观察,再通过同一个任务编号关联。
指标必须贴合任务。例如流失预测通常把“将要流失”设为正类,输入可以包括过去 30 天的活跃天数、历史付费次数和客服联系次数。精确率衡量被判为流失的用户中真正流失的比例,召回率衡量实际流失用户中被找出的比例,F1 综合精确率与召回率。AUC 评估模型在不同阈值下区分正负样本的能力。正类较少时,仅报告准确率会掩盖模型几乎不识别流失用户的问题。
这些定义也影响工程验收。假设扩容后每秒处理图像数提高,但图像增强配置意外改变,验证集宏平均 F1 下降,就不能声称同等质量下完成了加速。比较应固定数据划分与评估方式,说明目标是“达到指定验证质量需要多久”,还是“固定时间内获得怎样的质量”。前者同时包含吞吐、收敛速度和故障损失,通常比单独比较设备利用率更接近项目目标。
正式扩大资源前,至少保留 1 次可重复的小规模运行:保存代码版本、依赖、随机种子、数据清单、类别比例、关键配置和基线指标。随机种子有助于比较,却不保证所有设备上的浮点计算完全一致。应把允许的指标波动与数值差异写清楚,避免把正常波动误判为恢复失败,也避免用“存在随机性”解释明显的质量退化。
2 故障恢复、检查点与弹性
检查点是足以继续训练的状态快照。只有模型权重,通常只能重新开始某种训练过程,不能完整接续原过程。优化器可能保存动量等历史状态,学习率调度器可能依赖已经完成的更新次数,混合精度训练还可能有数值缩放状态。若恢复时遗漏这些内容,程序虽然能继续输出损失,后续更新轨迹却可能已经改变。
数据位置同样属于恢复约定。需要记录已经完成的轮次或更新步数,以及采样器、随机数生成器等必要状态。最容易理解的做法是在完整轮次结束后保存检查点,恢复时从下个轮次开始;代价是轮次很长时可能丢失较多工作。若在轮次中间保存,就要明确哪些样本已经参与成功的参数更新。不能把“预取到内存”误认为“已经完成训练”,因为故障可能发生在读取与更新之间。
恢复过程应先验证检查点是否完整,再加载状态、确认数据与配置兼容,最后恢复更新。写入可以先生成临时文件,完成写入与必要的持久化后,再发布完成标记或更新“最新可用”指针。读者只选择已完成的版本。单机文件系统的原子改名可帮助避免读取半成品;远程存储的提交语义可能不同,需要按实际接口设计发布协议,不能照搬本地假设。
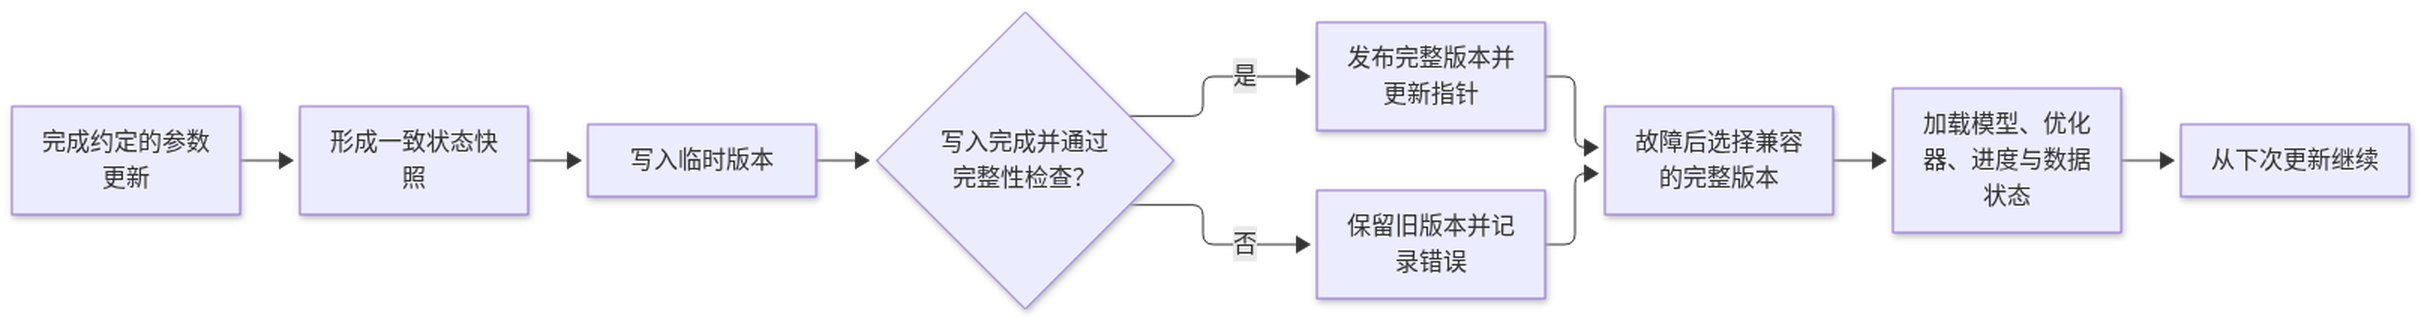
假设每完成 10 分钟有效计算保存 1 次,保存耗时 30 秒。任务在某次保存完成后的第 7 分钟故障,恢复就要重算这 7 分钟;若恢复读取与资源准备还需 2 分钟,故障增加的时间至少包括这 2 部分。最后完成的检查点以后出现过的日志,不代表对应参数已经持久保存。恢复后日志可能重复出现相同步号,统计系统应结合运行尝试编号识别重算。
多进程训练还要求检查点表达一致的训练位置。如果各进程在不同更新位置独立发布状态,恢复时可能拼出不一致的模型。入门阶段可以把它理解为“大家对已完成哪次更新达成一致,再共同形成可恢复版本”。具体如何同步与分片由训练框架处理,但平台必须知道检查点何时真正可用,不能只检查目录中是否出现了文件。
弹性是资源数量改变后继续运行的能力,自动重启只是其中较小的部分。原任务使用 4 个进程,恢复时只有 2 个进程可用,数据如何重新分配、全局批量是否改变、学习率是否需要调整,都影响训练含义。每个进程各处理 32 个样本时,4 个进程对应的全局批量是 128;改成 2 个进程而其他设置不变,全局批量会降到 64。不能把这种变化当作纯粹的部署细节。
因此,初始平台可以先支持固定资源规格下的可靠重启,再逐步支持资源变化。方案要列出允许恢复的规格、检查点格式版本和不兼容时的处理方式。检查点损坏时应回退到更早的完整版本;若没有兼容版本,应保留失败证据并结束尝试,而不是从随机参数悄悄重训。恢复成功的标准应包括训练进度与状态得到正确接续,而不只是进程重新启动。
3 数据与调度协同
计算资源到位以后,数据未必已经到位。图像训练通常包含读取、解码、裁剪、增强和组成批次等步骤。任何环节跟不上,都可能让计算设备空闲。若每台机器都从同一远程位置重复读取同一批文件,扩容还会扩大存储压力。应先测量读取等待与预处理耗时,再决定是否采用本地缓存、合并小文件或增加数据加载进程。
缓存需要绑定明确的数据版本。使用旧缓存却把任务标成新数据,会使恢复后读取的内容与故障前不一致。数据清单可以记录样本标识、分片位置、划分归属和校验信息;训练配置引用清单版本,而不是引用随时可能变化的目录。这样调度器将任务迁往其他节点时,也能检查当地缓存是否可用,而不是看到同名目录便直接开始训练。
数据划分应先于可能产生泄漏的拟合操作。表格任务中,缺失值填补规则与标准化参数只在训练集上拟合,再应用到验证集和测试集。对流失预测,标签若定义为未来 30 天内是否流失,特征就必须来自预测时刻之前。使用流失后产生的账户关闭状态,模型可能获得极高 AUC,却无法在真实预测时使用该特征。大规模训练只会放大这种错误的成本。
短文本分类可以使用公开的 AG News 数据集,输入新闻标题与正文,输出新闻类别。公开划分提供 120000 条训练样本与 7600 条测试样本,可再从训练部分划出 12000 条作为验证集。需要检查重复或高度相似文本,避免同篇新闻的不同版本跨越划分。若目标是未来新闻,还要考虑按时间验证;随机划分上的高分并不能直接证明模型适应新的话题和表达方式。
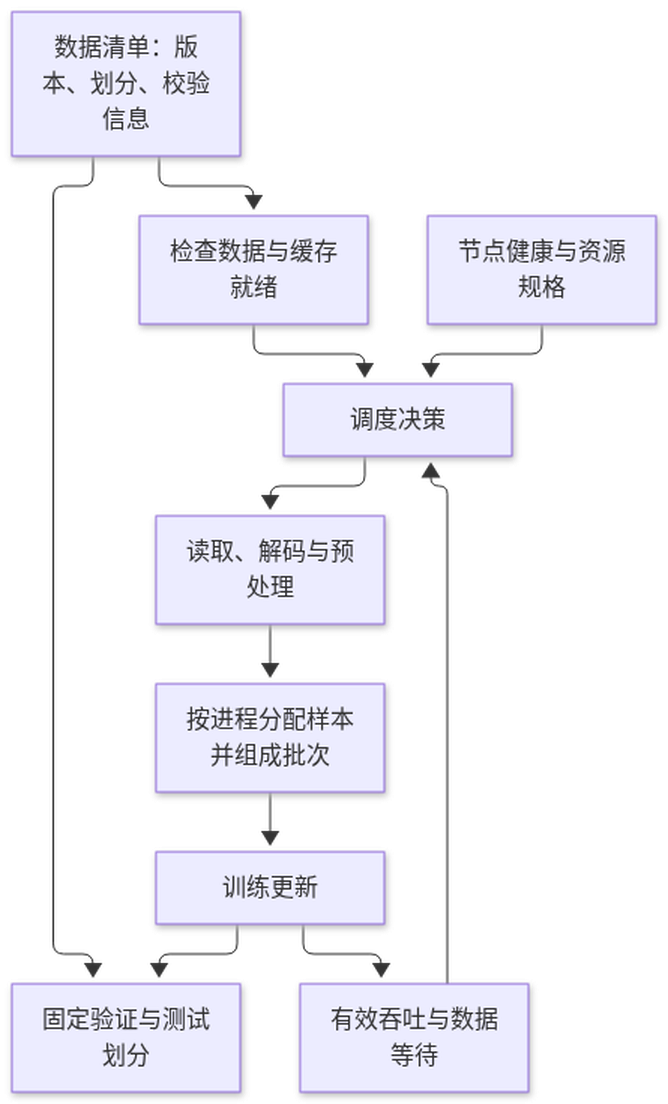
调度策略既要考虑空闲资源,也要考虑数据就绪程度和任务的最低资源要求。一个任务需要 4 个协同进程,零散启动其中 2 个、让它们长期等待其余进程,会浪费资源。平台应约定资源是否需要成组分配、等待多久、无法满足时怎样退回队列。若节点已经缓存目标数据,可以作为放置任务的参考,但不能因此忽略该节点的健康问题。
分布式采样还要避免多个进程无意间反复处理相同样本。应核对每轮有效样本数、各进程分配范围和尾部样本处理规则。有些框架会补齐样本以对齐进程步数,因此总读取数可能略大于独立样本数;这需要被明确记录。类别不平衡时,重采样会进一步改变实际看到的类别比例,评估集则应尽量反映目标场景分布,并分别报告各类召回率。
吞吐统计最好同时提供实际处理速度与有效进展。因为失败重算、重复采样和缓存预热,累计读取 100000 条不等于新增完成 100000 条训练工作。将已提交更新数、样本计数、数据等待时间和验证指标放到同一时间轴上,才能判断瓶颈来自数据供应、资源排队还是训练本身。调度优化的目的,是让经过验证的数据持续转化成模型进展。
4 动手:演练一次故障续训
演练不需要先租用多台机器。下面使用公开的乳腺癌诊断表格数据,训练逻辑回归形式的小模型,把重点放在保存与恢复状态。特征包括平均半径、纹理等测量值;将恶性样本设为正类,观察恶性识别的精确率、召回率、F1 与 AUC。这个练习只用于理解工程机制,结果不能作为临床诊断依据。
环境需要 Python、NumPy、scikit-learn 和 PyTorch。在练习目录把下列代码保存为 recover_demo.py。它从 scikit-learn 自带数据接口读取 569 条公开样本,按类别分层得到约 60% 训练、20% 验证、20% 测试。标准化只拟合训练部分;演练采用完整训练集作为每次更新的批次,检查点在更新完成后保存,因此不需要处理批次中途的位置。
import argparse
import os
import random
from pathlib import Path
import numpy as np
import torch
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import precision_score, recall_score, f1_score, roc_auc_score

p = argparse.ArgumentParser()
p.add_argument('--dir', required=True)
p.add_argument('--resume', action='store_true')
p.add_argument('--fail-at', type=int, default=-1)
a = p.parse_args()
random.seed(44)
np.random.seed(44)
torch.manual_seed(44)
torch.set_num_threads(1)
torch.use_deterministic_algorithms(True)

data = load_breast_cancer()
x = data.data.astype('float32')
y = (data.target == 0).astype('float32')
ids = np.arange(len(y))
train, rest = train_test_split(ids, test_size=0.4, stratify=y, random_state=44)
val, test = train_test_split(rest, test_size=0.5, stratify=y[rest], random_state=44)
scaler = StandardScaler().fit(x[train])
x = torch.tensor(scaler.transform(x), dtype=torch.float32)
y = torch.tensor(y, dtype=torch.float32)
model = torch.nn.Linear(x.shape[1], 1)
opt = torch.optim.SGD(model.parameters(), lr=0.03, momentum=0.9)
loss_fn = torch.nn.BCEWithLogitsLoss()
root = Path(a.dir)
root.mkdir(parents=True, exist_ok=True)
checkpoint = root / 'latest.pt'
contract = {'dataset': 'breast-cancer', 'split_seed': 44,
            'lr': 0.03, 'momentum': 0.9, 'format': 1}
start = 0
if a.resume:
    state = torch.load(checkpoint, map_location='cpu', weights_only=False)
    assert state['contract'] == contract, 'incompatible checkpoint'
    assert state['split'] == [train.tolist(), val.tolist(), test.tolist()]
    model.load_state_dict(state['model'])
    opt.load_state_dict(state['optimizer'])
    scaler = state['scaler']
    x = torch.tensor(scaler.transform(data.data), dtype=torch.float32)
    start = state['step']
    random.setstate(state['python_rng'])
    np.random.set_state(state['numpy_rng'])
    torch.set_rng_state(state['torch_rng'])
    print('restored', start)

for step in range(start + 1, 21):
    opt.zero_grad()
    logits = model(x[train]).squeeze(1)
    loss = loss_fn(logits, y[train])
    loss.backward()
    opt.step()
    print('completed', step, 'loss', float(loss.detach()))
    if step % 5 == 0:
        state = {'contract': contract, 'step': step,
                 'model': model.state_dict(), 'optimizer': opt.state_dict(),
                 'scaler': scaler,
                 'split': [train.tolist(), val.tolist(), test.tolist()],
                 'python_rng': random.getstate(), 'numpy_rng': np.random.get_state(),
                 'torch_rng': torch.get_rng_state()}
        temporary = root / 'pending.pt'
        with temporary.open('wb') as f:
            torch.save(state, f)
            f.flush()
            os.fsync(f.fileno())
        os.replace(temporary, checkpoint)
        print('committed', step)
    if step == a.fail_at:
        raise SystemExit('injected process failure')

model.eval()
with torch.no_grad():
    score = torch.sigmoid(model(x[val]).squeeze(1)).numpy()
truth = y[val].numpy()
pred = score >= 0.5
print('validation', {'precision': precision_score(truth, pred, zero_division=0),
                     'recall': recall_score(truth, pred, zero_division=0),
                     'f1': f1_score(truth, pred, zero_division=0),
                     'auc': roc_auc_score(truth, score)})
torch.save(model.state_dict(), root / 'final.pt')
先运行连续基线,再运行故障分支,最后恢复。使用 2 个新的输出目录,避免旧检查点混入本次实验。所有运行应使用同一个依赖环境;这段代码只加载自己生成且可信的检查点,因为这里的完整状态加载会使用 Python 对象反序列化。
python recover_demo.py --dir baseline
python recover_demo.py --dir interrupted --fail-at 13
python recover_demo.py --dir interrupted --resume
第 2 条命令应以故障提示退出,这是预期事件。日志应显示第 10 步已经提交,第 11 至 13 步虽然完成,却未进入检查点。恢复后应打印 restored 10,接着重新执行第 11 步,最终完成第 20 步。若从第 14 步继续,说明程序错误地把日志中的最近步数当成可恢复进度;若从第 1 步开始,则没有真正接续状态。
可以用以下独立比较命令检查最终参数。这里在同一 CPU 环境、固定输入顺序和确定性设置下,预期参数完全相等;跨设备或更复杂模型应预先约定容差和质量标准。
python -c 'import torch; a=torch.load("baseline/final.pt", weights_only=True); b=torch.load("interrupted/final.pt", weights_only=True); print(all(torch.equal(a[k], b[k]) for k in a))'记录连续运行与恢复运行的验证指标,确认分类阈值均为 0.5。实验期间不查看测试指标,避免根据测试结果反复改动配置。测试集已经被固定保留,等模型和阈值选择完成后再执行最终评估。练习只验证了进程中断后的本地续训;若整个节点丢失,本地文件也可能丢失,生产方案还需要把已提交检查点存到可由替代节点读取的位置。
随后可以做 1 次受控反例:在独立副本中省略优化器状态加载,保持其他设置相同,再比较最终参数。动量历史丢失后,即使步号接上,结果也可能变化。这个差异说明“可以运行”与“正确恢复”不是同一个验收条件。实际项目还应分别演练写入中断、最新检查点不可读和配置不兼容,而不是用这次简单演练替代全部恢复测试。
5 效率与工程复杂度取舍
训练效率至少包含有效计算速度、资源利用和达到目标质量的时间。增加设备能提升每秒样本数,却会引入通信、数据分发和同步等待。若设备数量从 2 增加到 4,吞吐只提高 40%,仍可能满足交付期限,但需要解释额外资源换来了多少时间。不要假定设备数量翻倍就一定把训练时间减半,也不要因为扩展不线性就直接判定方案无效。
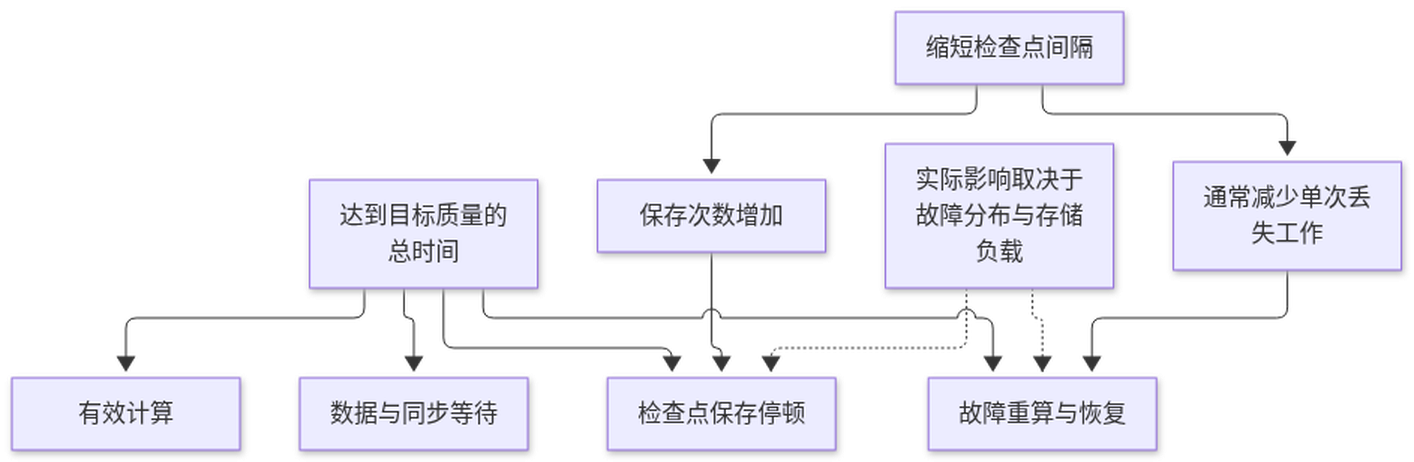
检查点间隔是容易理解的取舍。保存过于频繁,训练反复等待写入;保存过于稀疏,故障后需要重算较长时间。为了看清方向,设计划完成 120 分钟有效计算,每次同步保存耗时 0.5 分钟,间隔为 I 分钟,另考虑 1 次故障,资源准备和读取恢复合计 2 分钟。假设故障在保存间隔内近似均匀发生,平均丢失工作约为 I/2。
在这个简化模型中,保存次数约为 120/I,额外时间约为 60/I + I/2 + 2 分钟。间隔 2 分钟时,保存开销约 30 分钟,平均重算约 1 分钟;间隔 10 分钟时,分别约为 6 分钟与 5 分钟;间隔 30 分钟时,分别约为 2 分钟与 15 分钟。更频繁保存减少了故障损失,却可能增加总耗时。
这个估算用于解释方向,不是生产环境的精确预测。它忽略了重算过程中新增的保存、重复故障、保存排队与不同故障位置的影响;“平均丢失一半间隔”也依赖故障分布。实际决策应采集保存耗时、故障频率和恢复耗时,观察存储并发后的变化。若保存时长因任务数量增加而变长,原先可接受的间隔可能不再合适。
异步检查点允许训练在后台写入期间继续运行,可能降低停顿,却增加内存占用与状态管理复杂度。后台写入开始时,需要得到稳定的状态快照,不能让训练继续修改同一份参数,最终写出混合了多个时刻的数据。平台还要显示后台保存是否真正提交,限制同时在写的快照数量,并决定后台失败时是否暂停训练。入门方案可以先实现同步保存,获得可靠基线后再优化。
工程复杂度也有真实成本:更多恢复路径意味着更多兼容条件、测试场景和维护工作。对耗时 15 分钟的小模型,清楚记录数据和配置可能比实现资源动态伸缩更重要;对持续数天的训练,检查点与自动恢复往往值得优先投入。选择应跟预期故障损失、交付期限和团队维护能力联系起来,不需要为了“大规模”这个名称堆叠所有机制。
6 常见坑:检查点过密拖垮存储
团队发现训练偶尔中断,于是把检查点间隔从 20 分钟降到 1 分钟。单个任务看起来减少了重算,平台整体却开始变慢:大量任务周期性同时写入,存储排队增长,保存时间超过间隔,下一次保存又按时触发。最终训练等待写入,缓存占用增加,甚至连读取数据和恢复旧检查点也被拖慢。可靠性功能因此变成新的故障来源。
诊断时不要只看存储空间是否充足。还要看单位时间写入量、并发写入数、写入时延的中位数与较高分位、超时数和训练停顿比例。平均写入耗时正常,也可能掩盖少数特别慢的保存。若多个任务同一时刻出现设备空闲,且保存排队同时上升,就应优先检查共享存储竞争,再判断是否需要调整计算资源。
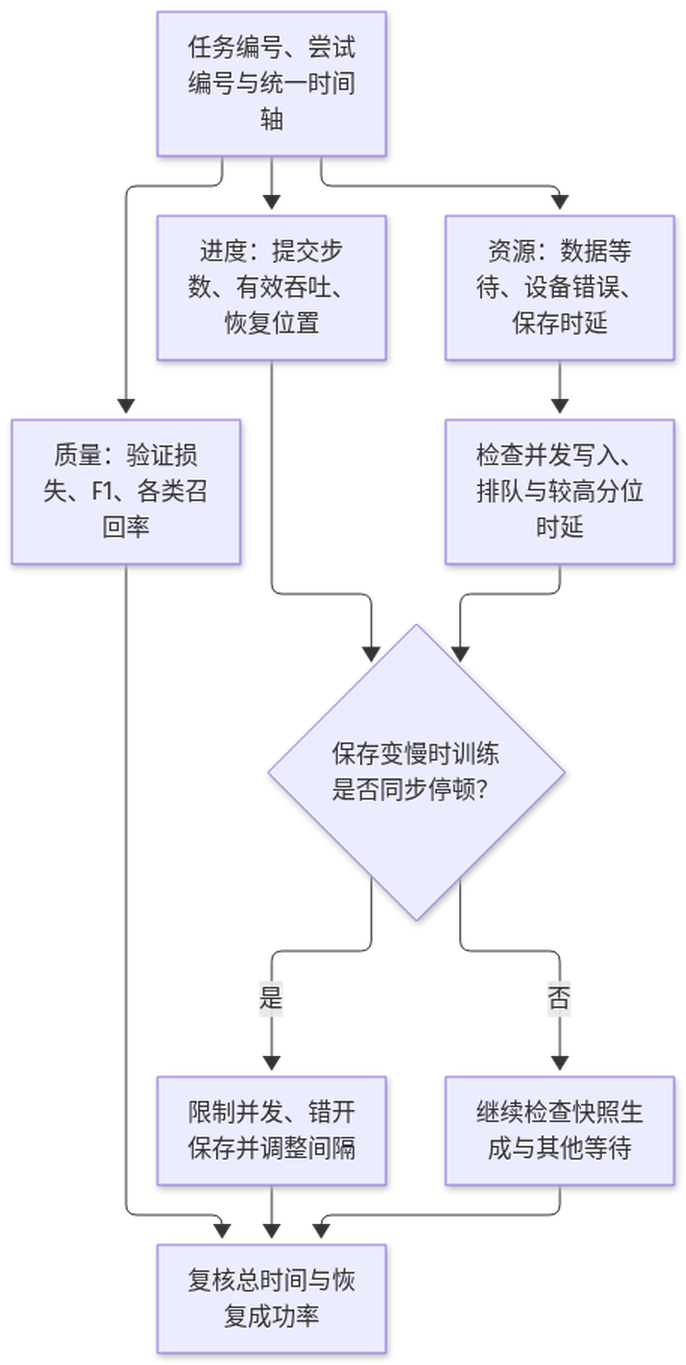
先做数量级估算。假设每个检查点 8 GB,20 个任务每 5 分钟各保存 1 次,平均写入需求约为每分钟 32 GB,还没有计入复制、重试和其他负载。如果这些任务在同一时刻保存,瞬时压力会远高于平均值。若每个任务保留 3 个完整检查点,仅这部分就需要约 480 GB 空间,还应为临时版本和正在提交的快照预留容量。
改进可以从限制并发保存、适度错开保存时间和调整间隔开始。调度应以实际提交速度为依据,避免无上限地堆积后台请求。保留策略必须区分“可用完整版本”“正在写入版本”和“待清理旧版本”,确保发布新版本成功后才删除已经被替代的旧版本。用于最终评估或审计的里程碑版本,可以按另外的保留规则管理。
不要一看到保存超时就删除所有旧文件重新尝试。最新版本可能尚未完成,较早版本反而是唯一可恢复状态。清理器应遵守提交标记与保留策略,并记录删除原因。若任务持续失败,平台需要保护最近可恢复版本,防止自动清理与自动重启相互作用,把原本可恢复的问题变成从头重训。
判断改进是否有效,应比较相似负载下的保存停顿、恢复成功率和达到目标质量的总时间。单独提高存储写入吞吐,却没有减少训练等待,可能说明瓶颈仍在快照生成或并发控制。排查应回到时间轴上的证据,避免把所有问题都归结为“磁盘不够快”。
7 案例:无健康检查的坏节点循环
某图像分类训练任务使用 4 个节点,其中 1 个节点的加速设备持续发生计算错误。训练框架发现某个进程退出,整个任务失败。平台具有自动重启功能,几分钟后重新分配资源,却又选中了刚才的故障节点。任务从检查点恢复,重复计算一段时间,再次因同样错误退出。界面上不断出现“正在恢复”,实际可提交进度几乎没有增长。
这里的关键不是重启速度太慢,而是重启没有改变导致失败的条件。平台只检查节点能否接收进程,没有检查训练所依赖的设备是否能完成计算。节点网络可达、操作系统存活、磁盘仍有空间,都不能证明加速设备健康。健康检查要覆盖任务需要的关键能力,同时避免用过重的检测影响正常任务。
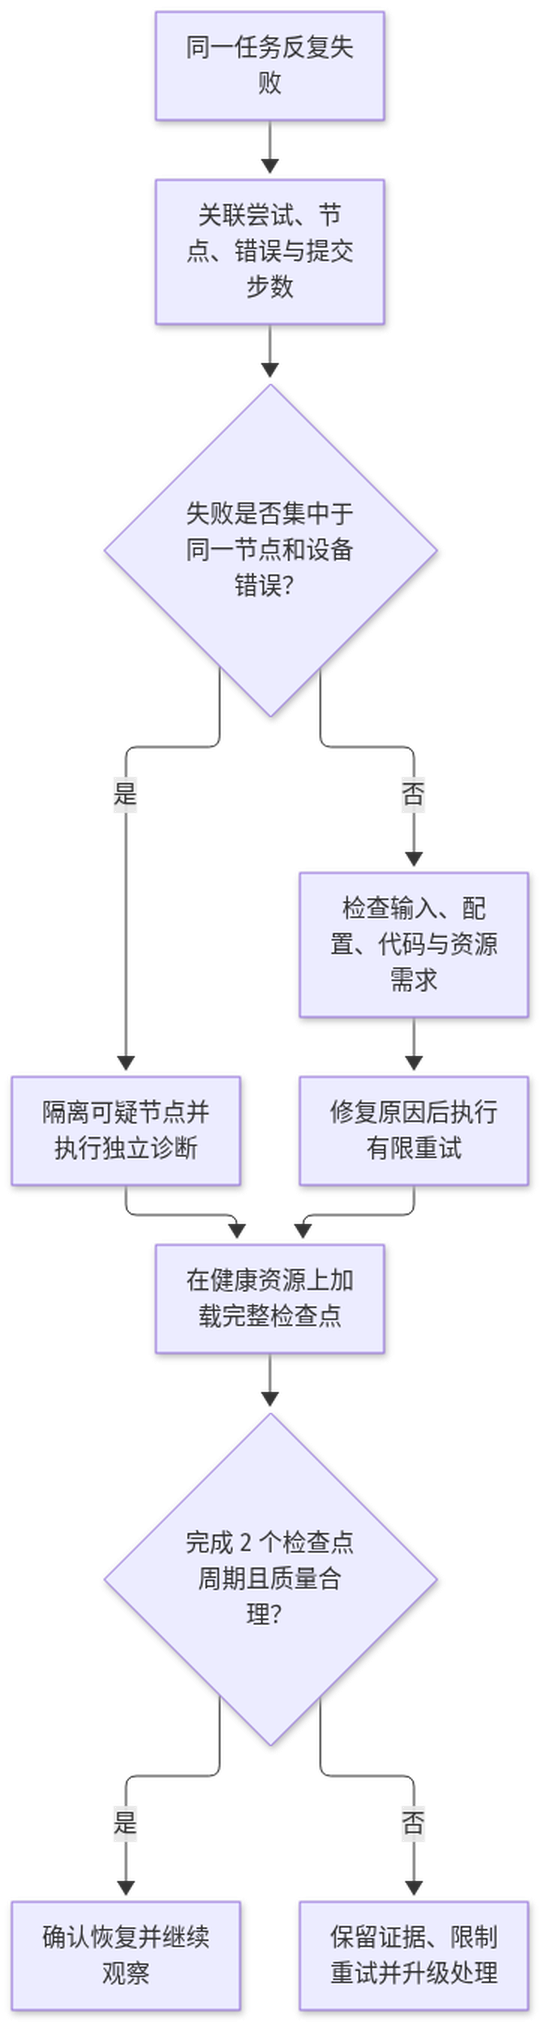
排查先把每次尝试串起来:记录任务编号、尝试编号、节点标识、故障时间、错误类别、恢复检查点版本和最后提交步数。如果 3 次失败都涉及同一节点,并且错误特征接近,就有理由优先检查该节点。也要保留反证:如果任务迁到其他健康节点仍在同一输入上失败,原因可能是数据损坏、程序缺陷或确定性的内存不足,不能继续只修节点。
修复闭环包括暂停向可疑节点分配新任务、执行独立诊断、保留故障日志,并把恢复任务放到已通过检查的资源上。节点隔离与整台机器永久下线不是同一个决定;可以先标记不可调度,待维护验证后恢复资格。对相同错误连续重试应设置上限,并逐渐延长重试等待,避免大量任务同时反复启动,进一步压垮数据与检查点存储。
重试策略需要区分错误类型。短暂读取超时可以尝试有限重试;配置缺少必要字段,应立即返回可操作的错误;数据校验失败,需要定位数据版本;设备健康异常,则应避免立即回到同一故障资源。错误分类不必一开始10分精细,但至少应把明显无法通过原样重启解决的问题识别出来。
恢复验收不能停在“新进程已启动”。本案例可以要求恢复后完成 2 个检查点周期,提交步数持续增长,不再出现相同设备错误,并且验证指标处于预定合理范围。若故障节点再次参与同类失败,就要重新隔离并保留关联证据。由此形成检测、隔离、迁移、恢复和验证的闭环,自动化才真正减少人工追踪,而不是自动制造更多失败记录。
8 把训练工程写进平台方案
平台方案首先应说明承载什么任务,以及任务成功意味着什么。对于 CIFAR-10 图像分类,可以写清输入版本、训练与验证清单、模型配置、训练预算和目标验证宏平均 F1;对于流失预测,应补充预测时点、标签窗口与正类定义。不要把“支持分布式训练”当成完整需求,因为它没有说明恢复精度、质量验收或资源边界。
任务提交应形成可追踪的运行记录。记录至少关联代码、依赖环境、数据清单、配置、随机种子、资源规格与输出位置。恢复运行沿用原任务身份,但产生新的尝试编号,注明从哪个检查点开始。这样既能追踪整体成果,又能分辨每次故障消耗的时间。配置修改后如果已经改变训练含义,应建立新实验关系,避免把不同实验的指标拼成连续曲线。
方案还应定义恢复契约:保存哪些状态、何时视为提交成功、保留多少可用版本、允许哪些规格恢复,以及恢复失败怎样回退。目标可以表达为“正常情况下最多损失约 10 分钟已完成计算”,但必须说明保存排队或最近版本损坏可能扩大损失。恢复耗时也应拆成资源等待、环境准备、数据就绪和状态读取,便于定位超出预期的原因。
资源与数据策略要一起描述。训练任务获得资源前,检查数据版本是否存在、最低资源是否满足;启动后记录有效吞吐、数据等待与存储停顿。若任务被暂停或抢占,说明是否有时间保存,以及没有保存时间时会回退到哪个已提交版本。不要承诺任何中断都能无损恢复,应该把可保证的条件写成可演练的规则。
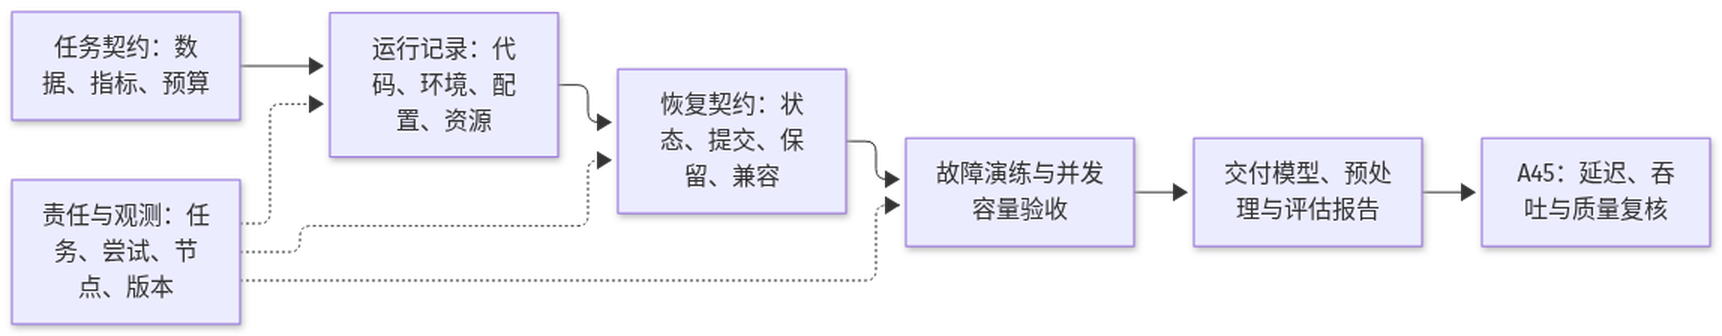
观测面板至少连接 3 类事实:模型质量是否合理,训练是否有效推进,基础设施是否健康。质量侧看验证损失、各类精确率与召回率等;进度侧看已提交步数、有效样本吞吐、最近可恢复位置;资源侧看数据等待、保存时延、设备错误与重试次数。告警应附带能定位问题的信息,例如具体任务、尝试、节点与检查点版本。
验收应包含连续基线、进程故障、节点替换、写入失败和坏节点隔离等场景,并分别记录期望行为。小规模演练证明恢复逻辑,大规模压测验证并发下的容量与时延,两者解决不同问题。交付物还需要操作责任:谁处理节点隔离、谁确认数据异常、谁批准变更资源规格。只有把异常时的动作和证据写清楚,平台能力才能被稳定使用。
9 从大规模训练工程走向推理优化(A45)
训练结束并不等于模型已经适合在线使用。训练面向反复读取样本并更新参数,通常更关注达到目标质量的总时间;推理面向使用固定模型为新输入生成结果,更关注响应时间、持续吞吐、内存占用和单位请求成本。两者共享数据版本与模型来源记录,却有不同的运行目标。一个训练效率很高的模型,可能仍然无法满足交互场景的响应要求。
进入推理阶段之前,应产生明确的模型交付版本,包含权重、模型结构或加载约定、预处理参数、标签映射和评估报告。表格模型依赖训练时拟合的标准化参数,文本模型依赖相同的分词规则,图像模型依赖输入尺寸与归一化设置。只交付权重而遗漏这些约定,部署端可能加载成功,却对同一输入产生不可靠的结果。
恢复检查点和推理交付物的用途不同。检查点需要优化器、随机状态和训练进度来继续更新;推理通常只需要前向计算相关内容。可以从某个被选定的检查点导出推理模型,但要记录它与训练运行、数据版本、评估结果的关系。最终交付版也未必是最后保存的检查点,应根据预先约定的验证规则选择,再对固定测试集做最终评估。
训练和部署之间还会出现分布偏移。流失模型训练于旧活动期间,部署后用户行为可能改变;新闻分类模型可能遇到新话题;图像分类模型可能面对不同相机和光照。上线前要检查输入字段与训练时是否一致,上线后继续观察输入分布和有标签反馈中的质量变化。输入分布变化是调查线索,是否已经造成性能下降仍需要结合标签与业务证据判断。
推理优化也要保留质量底线。例如调整批处理、数值精度或模型表示后,应使用固定输入与评估集复核输出和指标,避免只看到响应变快。A45 将继续讨论延迟、吞吐与批处理等基础取舍。本课先留下可靠起点:模型来源可追踪,预处理可复现,评估规则明确,训练故障没有让交付状态变得含混。
放进方案里
本项目以公开图像分类数据建立训练基线,固定训练、验证和测试清单,记录代码、依赖环境、随机种子、预处理版本与模型配置。验证阶段报告宏平均 F1 和各类召回率,测试集在配置与模型选择完成后用于最终评估。扩容验收以达到约定验证质量的总耗时为主,同时记录有效样本吞吐与资源消耗,避免仅用设备利用率评价收益。
训练首先支持固定资源规格的故障恢复。检查点包含模型、优化器、训练进度及必要的随机与数据状态,使用临时写入和完成发布机制,保留最近 3 个完整版本。初始保存间隔为 10 分钟有效计算,经过并发负载演练后调整;记录保存时延、恢复耗时与实际重算量。最新版本不可用时回退到更早的兼容版本,无法恢复时终止尝试并保留错误证据。
调度前检查数据版本与资源条件,启动后持续观察数据等待、已提交步数、存储停顿和设备健康。重复设备故障触发节点隔离,重试设置上限,避免任务回到相同故障资源。由平台运维负责节点诊断,训练负责人确认恢复后的进度与质量;数据异常交由数据负责人核对版本和划分。
上线验收包含连续训练基线、进程中断、节点替换和检查点写入失败演练,验证状态接续、回退规则与告警关联信息。容量评估同时考虑数据读取、检查点并发写入、临时空间与版本保留。训练完成后交付带版本的推理模型、预处理、标签映射和评估报告,并保留其对应的运行与检查点来源,为 A45 的推理优化提供可比较起点。
10 小结:下一步推理优化(A45)
大规模训练工程把数据、计算、检查点、调度与健康检查连接起来,让训练在故障后仍能持续取得可验证的进展。检查点越密并不一定越高效,自动重启也不一定解决原始故障。可靠方案需要完整状态、明确提交、有限重试、坏节点隔离与恢复后的质量验证。
自测时请解释:为什么只保存权重可能无法正确续训?为什么每秒样本数上升,达到目标质量的总时间仍可能变长?为什么恢复后需要观察已提交进度,而不能只看进程存活?带着这些判断进入 A45,再把关注点转向固定模型如何以合适的延迟、吞吐和成本持续提供预测。