1 CNN 要回答什么
把 1 张猫的照片交给程序,输入只是像素数值,输出却要成为“猫”的判断。困难在于,同样是猫,位置、姿态、背景和光照都可能不同;相邻像素之间的排列关系又10分重要。把眼睛、耳朵和毛发拆成互不相关的数值,模型就很难利用它们组成的局部结构。卷积神经网络(Convolutional Neural Network,CNN)要回答的核心问题是:怎样利用局部关系,从图像中逐层学习有用特征,并控制需要学习的参数数量。
先比较 3 类真实机器学习问题。表格流失预测的输入可以是近 30 天登录次数、账户使用时长、订阅金额和投诉次数,列的位置通常没有空间含义;图像分类的输入是按行列排列的颜色值,相邻位置常常属于同样的边缘或纹理;短文本分类的输入可以是词或字符序列,相邻片段可能组成短语。CNN 最典型的用武之地是图像,也能沿文本序列提取局部模式,但不能因为某种网络流行,就把任意表格列排成图片使用。
本课以公开的 CIFAR-10 图像分类数据集贯穿说明。它包含 10 个类别,每张图像大小为 32×32,带有 3 个颜色通道。原始训练部分有 50000 张图像,测试部分有 10000 张。我们从训练部分按类别分层划出 5000 张作为验证集,余下 45000 张用于训练。训练集用于更新参数,验证集用于选择结构和阈值,测试集只用于方案确定后的最终评估。所有增强版本都必须跟随原图留在同样的数据分区,避免把几乎相同的图像分到两边。
CNN 并不会天然理解“猫”。它学习的是与标签有关的数值模式。若训练图片中的猫常带有水印,网络也可能把水印当作证据。因此,报告不能只给总体准确率:还应检查各类别的精确率、召回率和 F1,以及混淆矩阵。精确率回答“判为猫的图片中有多少确实是猫”,召回率回答“所有猫图片中找回了多少”。F1 综合这 2 个方向,适合观察遗漏与误报之间的平衡。
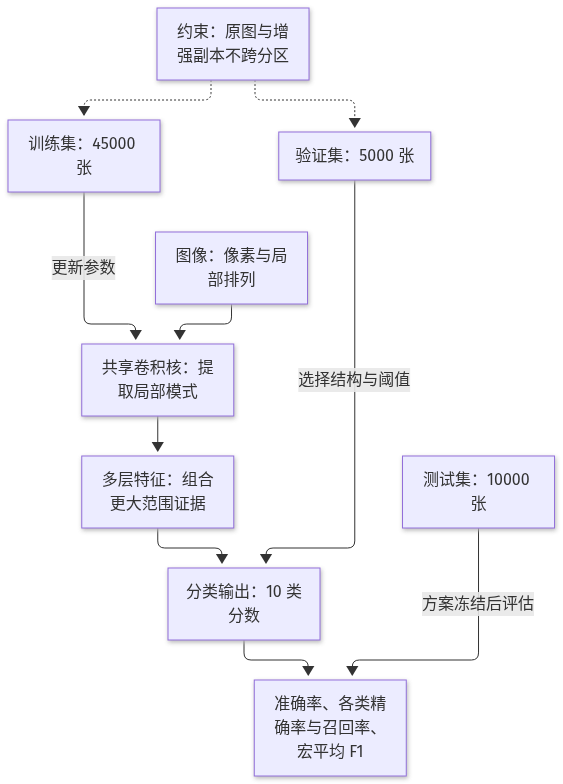
后面先解释网络怎样看局部,再追踪形状和计算量,最后把这些认识变成视觉方案的条件。先记住边界:CNN 是特征提取方法,分类、检测、分割则是任务;选择了 CNN,并不等于已经确定了输出形式或业务评价标准。
2 卷积、感受野与参数共享
设想拿 1 个 3×3 的透明小窗口覆盖图像。窗口每覆盖 1 个位置,就把窗口中的像素与对应权重相乘,再把结果相加,并加上偏置,得到输出中的 1 个数。窗口移动后继续计算,结果按位置排成特征图。这就是入门层面需要掌握的卷积操作。深度学习框架中常见的实现通常不翻转卷积核,严格说属于互相关,但习惯上仍称卷积,不影响这里对形状与共享方式的理解。
以灰度图为例,假如局部像素的每行都是 0、0、1,而卷积核的每行都是 −1、0、1,那么逐项乘积求和会得到 3。这个例子只说明某种左右亮度变化会带来响应,并不是说真实网络中的每个核都能被人工命名为“竖边检测器”。训练时核里的数值通过数据不断调整;某些低层模式容易观察,高层特征通常难以用 1 个日常词完整描述。
彩色输入又多了通道维度。对于 3 通道图像,1 个 3×3 卷积核实际覆盖 3×3×3 个输入数值,先把全部通道的乘积合并,再输出 1 个数。若设置 16 个这样的核,就得到 16 个输出通道,每个通道对应 1 张特征图。输出通道数是设计者选择的容量参数,不能误认为输出仍固定对应红、绿、蓝;第 1 层之后,通道通常表示学习到的特征响应。
参数共享是 CNN 的关键:同样的核在整幅图像上反复使用,移动到左上角与右下角时不会换成另套权重。以带偏置的 3×3、3 输入通道、16 输出通道卷积为例,参数数目为 3×3×3×16+16=448。这个数不随输入图像的宽高直接增加,而全连接层会为不同输入位置分别配置连接权重。共享降低了参数量,也表达了“类似的局部模式可能出现在不同位置”的假设。
感受野描述某个输出位置能够受到输入中多大区域的影响。第 1 个 3×3 卷积层只能直接看见 3×3 区域;再接 1 个步幅为 1 的 3×3 卷积层,后层输出就能间接接触 5×5 区域。这里说的是理论感受野范围,不保证范围里的每个像素都同等影响判断。网络需要通过多层组合,把局部变化连接成更大的结构,而不能指望第 1 层就直接识别完整物体。
卷积还常被描述为具有平移等变性:在理想边界条件下,输入平移,特征响应也相应平移。这与“输入移动后预测绝对不变”不是同样的承诺。填充、步幅、裁剪和最终输出层都会影响结果。对真实图像仍需用平移测试和数据增强检查稳定性,不能把结构上的倾向当成模型已经具备的能力。
3 池化、步幅与特征图边界
特征图如果始终保持很大,后续计算就会很贵。步幅表示窗口每次移动多少位置:步幅为 1 时逐格移动,步幅为 2 时每次跨过 2 格,通常使输出宽高接近原来的 1/2。它既可用于卷积,也可用于池化。卷积的窗口权重可学习,池化则按固定规则汇总局部数值,常见规则是取最大值或平均值。
对 2×2 区域 1、3、2、0,最大池化输出 3,平均池化输出 1.5。最大池化强调局部最强响应,平均池化保留整体响应水平。若池化步幅也为 2,相邻输出窗口通常不重叠。池化本身一般没有需要训练的权重,但它会丢失位置细节。对整图分类,这种压缩可能有用;对需要框出细小物体的检测任务,过早压缩可能直接抹去证据。
窗口抵达边缘时会遇到越界问题。无填充意味着只计算完整落在输入里的窗口;零填充则在边缘补 0,让窗口覆盖到原本的边界附近。填充并非没有代价:边缘输出会混入人为数值,真实图像的边缘也不总等于黑色背景。某些框架还提供反射等其他填充方式,但入门方案先把填充大小记清楚,比盲目更换方式更重要。
若输入某个方向的长度为 N,卷积核长度为 K,两侧填充各为 P,步幅为 S,在本课不使用空洞卷积的前提下,输出长度为 floor((N+2P−K)/S)+1。floor 表示向下取整。32 像素输入经过 K=3、P=0、S=1 后变为 30;若 P=1 则保持 32;改成 P=1、S=2 则得到 16。高和宽分别使用这个公式,不要只凭“差不多减半”推断。
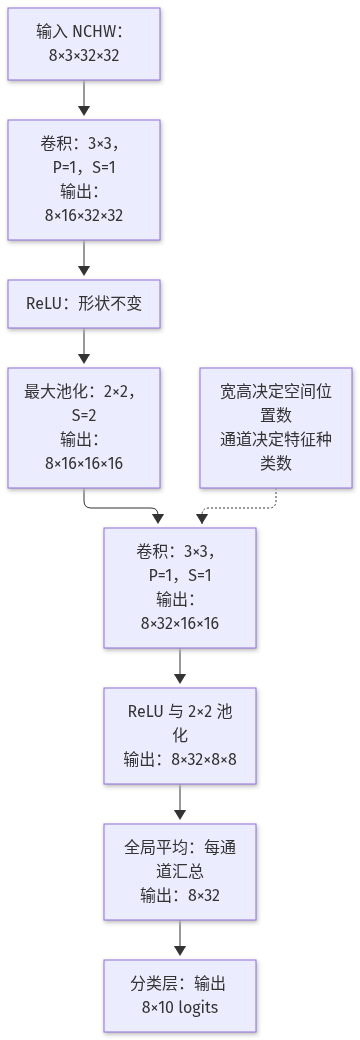
还要区分特征图分辨率与感受野。分辨率降低表示输出位置更少;感受野变大表示每个位置可联系更大的输入范围。它们常同时发生,却不是同样的事。模型可能每个位置看得很广,但输出格子过粗,无法区分邻近的 2 个小目标;也可能保留大量格子,却因为层数不足而缺乏上下文。后续设计应同时追踪这 2 条线索。
4 动手:追踪一次卷积层的形状变化
先用纸笔完成形状账本,再运行框架。约定张量采用 NCHW 顺序:批量、通道、高、宽。取 8 张 CIFAR-10 图片组成批次,输入形状就是 [8,3,32,32]。批量维度表示同时计算多少张图片,不表示把图片拼成更大的图像。部分工具采用 NHWC 顺序,读取日志时必须先确认约定,不能看到 3 就默认它出现在同样的位置。
第 1 层设置输入通道 3、输出通道 16、卷积核 3×3、填充 1、步幅 1。代入公式,宽高均为 32,所以输出为 [8,16,32,32]。随后接 ReLU 激活,把负数变为 0,正数保持不变,形状仍为 [8,16,32,32]。激活让多层网络能够表达更复杂的变化;它不会因为“添加了非线性”就自动增加通道或缩小图像。
接 2×2、步幅 2 的最大池化,得到 [8,16,16,16]。然后用输入通道 16、输出通道 32 的 3×3 卷积,填充 1、步幅 1,得到 [8,32,16,16]。再接相同配置的池化,结果为 [8,32,8,8]。这张账本给出了明确的接口约束:第 2 个卷积必须接收 16 个通道,不能因为原图是彩色就继续把输入通道写成 3。
为了完成分类,可以把每个通道的 8×8 数值做全局平均,得到 [8,32],再通过全连接层输出 [8,10]。这 10 个数是每类的分数,通常称为 logits。训练时可直接交给适配 logits 的交叉熵损失;展示概率时再使用 softmax。不要在不清楚接口的情况下重复使用 softmax,也不要把训练损失下降等同于验证效果提高。
实际运行时,记录每层名称、输入形状、输出形状和参数量即可。先送入随机张量检查连接是否成立,再用真实图像检查通道顺序、像素范围与标签对应。随机张量通过只能说明形状兼容,不能证明读取数据正确。若把颜色通道错排,网络仍可能正常运行,却会在有缺陷的数据表示上学习,最终表现为难以解释的精度损失。
训练前固定数据分区和随机种子,将像素缩放到约定范围。若使用均值与标准差标准化,统计量只从训练集计算,再原样用于验证集和测试集。随机裁剪、水平翻转等增强通常仅用于训练,验证与测试采用固定处理。还要确认增强不破坏标签:水平翻转普通动物照片常可接受,带方向含义的交通标志或文字却需要另行判断。
完成第 1 次训练后,至少记录训练损失、验证损失、验证集宏平均 F1 和每类召回率。宏平均 F1 是先计算各类别 F1,再对类别等权平均,可以防止常见类别掩盖少数类别。若报告 AUC,应明确是哪个类别对其余类别的评分,或如何进行多分类汇总;AUC 衡量排序表现,不能替代实际决策阈值处的精确率与召回率。
5 深度与计算量取舍
网络更深通常能组合更大范围的信息,但深度不是免费提升。每加 1 层,都增加计算、激活存储和优化难度。先考虑普通卷积的近似乘加次数:输出高×输出宽×输出通道×卷积核高×卷积核宽×输入通道。这个估计忽略偏置与激活等操作,却足以比较结构方向。参数量衡量需要保存多少权重,乘加次数衡量前向计算的主要工作,两者不能互相替代。
前述第 1 个卷积对每张图像需要 32×32×16×3×3×3=442368 次乘加。第 2 个卷积在 16×16 的特征图上运行,需要 16×16×32×3×3×16=1179648 次乘加。虽然第 2 层的空间尺寸更小,它仍可能更贵,因为输入与输出通道增加了。若把输入、输出通道都翻倍,其他条件不变,普通卷积的主要计算量约变为 4 倍。
增加输入分辨率也会改变预算。宽高都翻倍时,像素位置数约为原来的 4 倍,前部卷积的计算与激活存储通常也相应增长。但对极小目标,增加分辨率有时比单纯加深网络更有价值,因为原始输入若已经把目标缩到几乎无法辨识,后续网络无法凭空恢复细节。应先看任务需要保留什么,再判断钱和时间花在哪里。
2 个连续的 3×3、步幅 1 卷积可以覆盖 5×5 的理论感受野,中间还可加入激活。在输入、隐藏和输出通道都为 C、忽略偏置时,它们的参数约为 18C²,而单个 5×5 卷积约为 25C²。这是解释“小核叠加”的简化比较,不代表实际运行必然更快;额外的中间特征图、框架实现和设备都会影响延迟。最终应在目标设备上测量。
公平比较要固定训练分区、预处理、训练预算和评价规则。可以先比较基线、增加 1 个卷积层、增加输入分辨率这 3 个配置,观察验证宏平均 F1、小目标召回率、单张延迟和峰值内存。若更深的模型训练效果提高而验证效果下降,应优先检查过拟合与数据质量。只有当收益稳定且满足部署约束时,增加复杂度才成为有证据的选择。
6 常见坑:把全连接层当空间特征提取器
把 32×32×3 的图像直接展平成 3072 个数,再接 128 个隐藏单元,需要 3072×128+128=393344 个参数。这个层为每个像素位置分别分配权重,并没有明确要求相邻像素共同组成局部模式,也没有要求左边出现的模式与右边共享参数。它能学习图像分类,但需要自己从数据中摸索许多空间规律,通常缺少卷积结构提供的约束。
因此问题不在于全连接层“不能处理图像”,而在于把它作为空间特征提取器时,代价与假设是否合适。CNN 的分类末端仍然可以使用全连接层,因为前面的卷积已经将局部证据转换成特征。对卷积输出直接展平也可行,但若特征图很大,后接全连接层会迅速增加参数,并将预测更紧地绑定到特征的位置和输入尺寸。
全局平均池化提供另种汇总方式:每个通道只保留平均响应,再交给较小的分类层。它减少参数,并允许某些结构适应不同空间尺寸;但平均操作会稀释罕见的局部响应,也会丢失精细位置。分类任务中有用的选择,放到定位任务里未必合适。判断依据应是输出需要什么证据,而不是哪个层名字看起来更先进。
另个常见错误是拿网络结构解释所有指标异常。训练与验证都很差,可能是标签错位、像素范围错误、学习率不合适或容量不足;训练很好而验证很差,可能是过拟合、划分差异或数据泄漏造成的评估误导。先尝试让模型拟合很小的训练子集,有助于发现数据与训练代码问题,但这种诊断结果不能当作泛化表现报告。
泄漏也不只发生在归一化统计量中。同段视频的相邻帧、同个对象的多角度照片、原图与其裁剪副本若跨越数据分区,都可能让验证集变得过于容易。应根据对象、拍摄会话或时间分组划分,并在可行时检查重复与近重复样本。类别不均衡时,还要报告样本数与分组指标;对训练集重采样可以调整学习机会,验证集与测试集则应反映约定的评估分布。
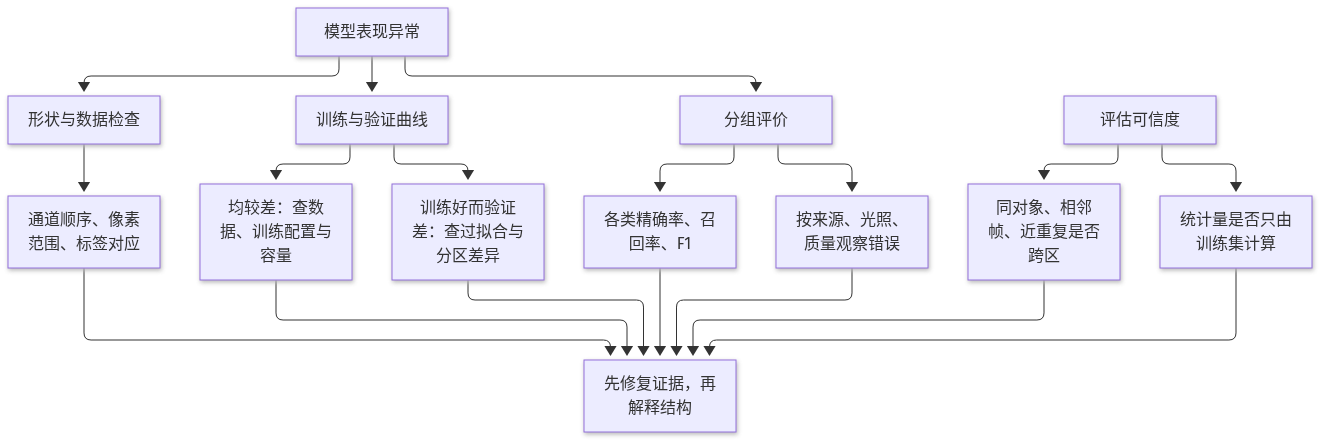
最后,分布偏移可能来自拍摄设备、背景、季节和光照。训练集里的动物照片与实际入口的夜间监控画面,即便类别名称相同,也不保证具有相同分布。应保存按来源和条件分组的评价结果,让“这次模型在哪些条件下有效”成为可检查的陈述。卷积的参数共享能帮助利用局部规律,却不会自动消除这些差异。
7 案例:感受野不足漏检小目标
现在从整图分类切到目标检测,讨论“找得到位置”这类需求。设教学实验采用公开交通标志数据集 GTSDB,使用其中带标注、可用于训练的数据划分训练、验证与测试部分,并按拍摄序列分组,避免相邻画面跨区。检测输出包括标志框、类别和置信分数。这里的数字示例用于解释排查过程,不代表已经在该数据集上完成实测。
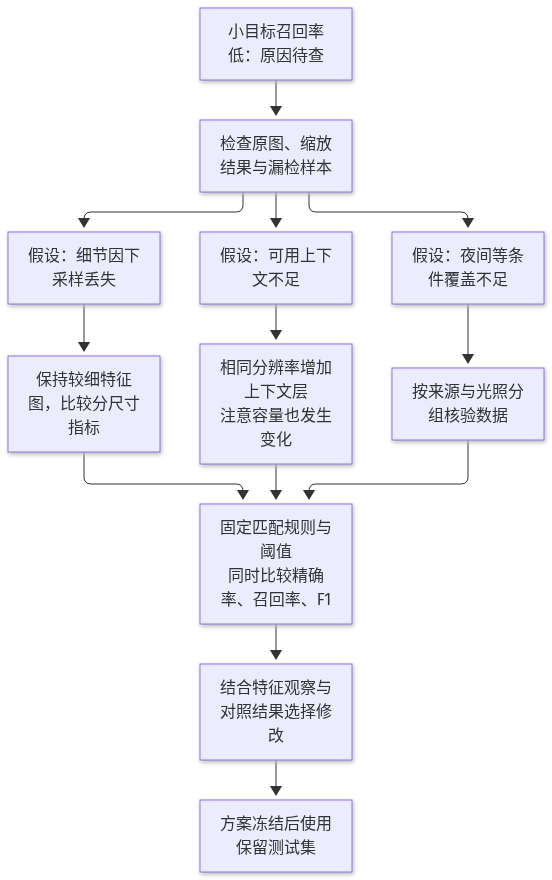
假设某个简化检测器连续下采样后,只在步幅为 16 的特征图上预测。部分远处标志宽度只有 8 像素,在粗特征图上跨度不足 1 个格子。验证结果若呈现“大标志召回尚可,小标志召回明显偏低”,首先只能确认尺寸相关的失败,不能直接断言感受野不足。小目标常见的直接问题是分辨率损失,而感受野不足指的是模型无法结合判别所需的周围区域。
要区分这 2 种原因,可以观察漏检图和中间特征。某些小标志外观与背景亮点相近,需要结合路杆、道路边缘或完整边框才能判断;若负责预测的特征只覆盖很小的输入区域,局部响应即使存在,也可能缺乏足够上下文。另些标志在缩放后已经只剩模糊色块,这时扩大感受野不能恢复细节。标题中的原因必须由对照实验支持,不能从漏检现象直接推出。
固定其他条件,设置基线、保持较细特征图、在相同分辨率上增加上下文层这 3 个配置。第 2 个配置主要测试空间细节是否不足,第 3 个主要测试上下文是否不足。新增层也会改变容量,因此它不是严格的单变量因果证明,但能与特征观察、分尺寸指标共同形成证据。不要同时放大图像、换标签、改阈值,再把所有收益归给感受野。
检测评价还必须规定怎样算命中。例如按 IoU≥0.5 将预测框与同类别真实框进行匹配,每个真实框最多对应 1 个正确预测,多余重复框算误报。IoU 是预测框与真实框交集面积除以并集面积。随后分别统计小、中、大目标的精确率、召回率和 F1,并观察不同置信阈值。单看召回率上升不够,因为把阈值大幅降低也可能同时产生大量误报。
若增加上下文层后,在固定阈值下小目标召回提高、精确率基本稳定,且改善主要发生在需要背景关系的样本上,才能支持“原模型上下文不足”的解释。若保持较细特征图的配置改善更明显,则应优先处理分辨率问题。若所有配置都在夜间失败,就应检查训练数据是否覆盖夜间条件。失败案例的价值在于缩小原因范围,而不是给每次失败套上结构术语。
8 把 CNN 归纳偏置写进视觉方案
归纳偏置指模型在观察数据之前,由结构或学习方式带入的倾向。CNN 的局部连接假设附近位置更值得先组合,参数共享假设类似模式可能在不同位置重复出现,层级组合则让简单模式逐渐形成复杂证据。这些假设适合大量自然图像问题,但不是图像世界的全部规律。方案应写清它们为何适合当前输入,以及在哪些条件下可能失效。
例如识别动物类别时,耳朵和纹理在不同位置仍可提供线索,参数共享有合理性;若识别某个固定仪表上的指针位置,绝对位置也很重要,过强的空间汇总可能损害任务。文本分类中,局部短语可能有价值,但远距离否定关系未必能靠很短的窗口解决。表格流失预测中,“年龄”旁边恰好排着“登录次数”只是列顺序选择,通常不构成使用二维卷积的理由。
可复现的视觉方案需要同时交代输入、输出和证据。输入包括图像来源、尺寸、颜色顺序与预处理;输出包括类别分数还是位置框,以及阈值如何确定;证据包括分区原则、主要指标、分组表现和设备上的延迟。写“使用 CNN 提高准确率”无法让读者复查,写“保持小目标可辨的输入尺寸,并在验证集上比较分尺寸召回率”才把结构选择与目标连接起来。
还要给方案留下失败处理。输入出现明显模糊、分辨率过低或来源变化时,可以记录质量信号,进入人工复核或约定的降级流程。置信分数高并不保证预测正确,尤其在训练分布之外;阈值应根据验证集的误报与漏报代价制定,并在新来源数据上重新检查。部署后若输入分布改变,不能只看总体调用成功率,应持续抽样核验预测质量。
9 从CNN走向计算机视觉任务(A24)
CNN 给出的是将图像转成特征的途径,A24 将把注意力转向不同视觉任务的输入、输出与评价。图像分类回答“整张图主要属于哪类”;目标检测回答“有哪些对象,分别在哪里”;语义分割为每个像素指定类别。它们可以共享相似的特征提取部分,却需要不同的输出结构、标注方式和损失设计,不能把分类准确率直接拿去代表定位质量。
在准备下课之前,可以用同张街景提出 3 个问题:是否存在交通标志、交通标志的框在哪里、哪些像素属于道路。第 1 个问题可能只需图像级标签,第 2 个需要框,第 3 个需要像素标注。标注成本、评价指标和失败代价随任务变化。任务定义越明确,越容易判断应保留多少空间细节,以及是否有必要增加上下文。
带着本课的形状账本进入后续内容:每次下采样都改变定位粒度,每次扩大感受野都改变可用上下文,每次汇总都可能丢失位置信息。先说明输出必须保留什么,再设计特征与评价;这比从网络名称倒推需求更容易得到可解释、可复现的视觉系统。
放进方案里
本方案使用 CNN 完成 CIFAR-10 的 10 类图像分类,输入为 32×32 的 RGB 图像,输出为各类别分数。选择 CNN 的理由是局部边缘与纹理具有空间关联,并可能在不同位置重复出现,适合用局部连接和参数共享提取特征。模型采用 2 个卷积阶段,配合池化与全局平均汇总;先建立可解释的基线,再根据验证证据决定是否增加深度或输入分辨率。
数据采用原始训练部分划出 45000 张训练图像与 5000 张验证图像,原始 10000 张测试图像保留作最终评估。分区按类别分层,增强副本跟随原图,归一化统计量仅由训练集计算。训练阶段使用经过标签适用性检查的随机增强,验证与测试采用固定预处理。保存分区清单、处理配置、随机种子和模型版本,以支持重复实验。
主要评价使用宏平均 F1,并同时报告准确率、各类别精确率、召回率及混淆矩阵。若增加某类的告警阈值策略,阈值由验证集上的漏报与误报代价确定,测试集仅用于方案冻结后的报告。结构比较固定数据与训练预算,记录目标设备上的单张延迟和峰值内存,避免只凭参数量判断运行成本。
方案重点检查背景依赖、类别不均衡及输入分布偏移。对错误样本按类别、图像质量与来源分组,区分细节丢失、上下文不足和数据覆盖不足。用于检测任务时,另行定义框匹配规则及分尺寸召回率,不能沿用分类结论。上线后通过抽样复核观察新来源表现,达到约定的质量退化条件时重新评估数据和模型;本实验结果只覆盖已验证的输入范围。
10 小结:下一步计算机视觉任务(A24)
CNN 用共享卷积核提取局部模式,通过层级组合扩大感受野;步幅、填充和池化共同决定特征图大小与细节保留程度。选择结构时,应同时追踪形状、上下文、计算量与评价结果。
自测时尝试回答:32×32 输入经过 3×3、填充 1、步幅 2 的卷积后为何是 16×16?输出通道为什么不等于原图颜色数?小目标漏检为何不能直接归因于感受野不足?如果能把答案连接到具体输入、指标和对照实验,就可以进入 A24,进一步学习分类、检测与分割如何定义任务与验证效果。